

2025-06-11
H Company的AI网页冲浪高手:开源模型如何以超低成本击败GPT-4?
H Company研究团队开发了开源网页操作AI系统Surfer-H,配备专门训练的Holo1视觉语言模型。该系统在WebVoyager基准测试中达到92.2%的成功率,媲美GPT-4性能但成本仅为其四分之一。研究团队还...

H Company研究团队开发了开源网页操作AI系统Surfer-H,配备专门训练的Holo1视觉语言模型。该系统在WebVoyager基准测试中达到92.2%的成功率,媲美GPT-4性能但成本仅为其四分之一。研究团队还...

这项研究提出了RACRO框架,通过奖励优化图像描述来解决多模态推理问题,避免了传统方法中昂贵的视觉-语言重新对齐过程。研究表明,通过将视觉感知与推理解耦并使用强化学习优化图像描述质量,即使只使用较小模型训练,也能在推理阶...

香港中文大学(深圳)研究团队开发出FusionAudio-1.2M数据集,创新性地融合音频、视觉、语音和音乐信息来生成详细的音频描述。该研究采用多模态专家系统和大语言模型整合的两阶段方法,构建了包含120万高质量音频描述...

浙江大学与吉利汽车研究院提出了一个叫做FreeTimeGS的新方法,通过一种全新的思路给予高斯基元"自由",让它们能够在任意时间和位置出现,从而更好地重建具有复杂动作的动态场景。

上海交通大学研究团队开发出革命性AI癌症诊断系统,通过深度学习技术分析50万张细胞图像,实现94.2%的诊断准确率,诊断时间从30分钟缩短至2分钟。该系统不仅能识别多种癌症类型,还具备解释性功能,已在多家医院试点应用。研...

南华理工大学等机构提出3DFlowAction方法,让机器人通过预测物体3D运动轨迹来学习操作技能。该研究创建了包含11万个实例的ManiFlow-110k数据集,构建了能预测三维光流的世界模型,实现了跨机器人平台的技能...

这是首个系统性探索跨视角协作智能的综合性研究,由南京大学、东京大学等顶尖机构联合完成。研究团队首次将"第一人称视角"与"第三人称视角"的协作应用进行了全面梳理,提出了三大技术方向和十三个关键任务,涵盖从智能厨房到手术机器...
北京大学等机构的研究团队开发出PartCrafter技术,能够从单张照片同时生成多个3D零件组成完整模型,无需预先图像分割。该技术采用创新的局部-全局注意力机制,在保证零件细节的同时确保整体协调性。相比传统先整体后分解的...

这项由台湾大学与微软研究团队合作的研究探索了使用音频感知大语言模型(ALLMs)作为自动评判员来评估语音生成模型的说话风格。研究设计了"语音风格指令跟随"和"角色扮演"两个任务,测试了四种语音模型的表现,并比较了人类与A...

卡内基梅隆大学研究团队提出全新"Kinetics"缩放定律,揭示大语言模型测试阶段的资源分配策略需要重新思考。研究发现小型模型效率被严重高估,因为以往研究忽略了内存访问成本这一关键瓶颈。在测试阶段,注意力机制而非参数数量...

这项研究由加州大学伯克利分校团队完成,通过创建"Search Arena"平台收集了24,000多次用户与搜索增强型大语言模型的真实交互数据。研究发现用户提问远不止简单事实查询,他们更看重引用丰富的回答,即使引用与内容无...

这项来自加州大学戴维斯分校和俄亥俄州立大学的研究探讨了多模态AI训练的一个重要问题:让AI同时学会处理文字、图像、视频等多种信息类型时,是否会影响其原有的语言能力?研究发现,扩展模态确实存在能力权衡,模型合并技术比全模态...

众所周知,苹果的全球开发者大会WWDC的主题演讲,是提前录制好的视频。无论你是现场参会(由于报名人数众多,要通过抽奖系统才能获得门票),还是线上观看,其实都是在看视频,区别只在于在哪里看。当然,除了主题演讲,WWDC还有...

中科院团队提出Prefix Grouper方法,巧妙解决GRPO训练中的重复计算问题。通过将自注意力分解为前缀和后缀两部分,实现共享前缀的高效计算,在长文本场景下可将计算量降至原来的1/G。该方法保持与传统GRPO完全一...

这项研究由IIIT海德拉巴的Ananth Muppidi、IIT哈拉格普尔的Abhilash Nandy与Adobe研究院的Sambaran Bandyopadhyay共同完成,提出了一种名为ID-SPAM的创新方法,用...
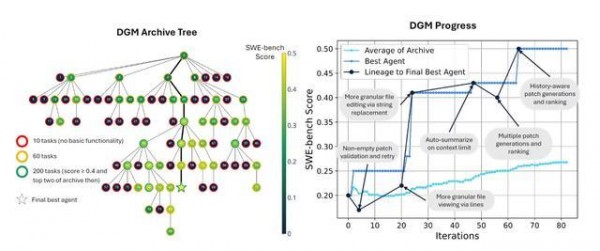
当AI学会自我进化:一台能不断重写自身代码的"达尔文哥德尔机器"正在实验室诞生,它像有创造力的厨师,不仅按食谱做菜,还能发明新菜谱并改进烹饪技术——这项突破让AI首次实现真正的自主进化,编程成功率从20%跃升至50%。

HASHIRU是一个创新的多智能体系统,由加州大学戴维斯研究团队开发,采用"CEO-员工"层级结构,动态管理AI智能体团队。系统优先使用小型本地语言模型,仅在必要时调用更强大的外部API,通过经济模型控制资源分配,并能自...

北航团队开发的FEAT是一种全新的医疗视频生成方法,通过三大创新解决了现有技术的关键问题:引入全维度依赖关系建模同时处理空间、时间和通道信息;采用线性复杂度的注意力机制大幅提高计算效率;设计残差值引导模块提供精细的像素级...

这项研究首次通过规模法则全面比较了CLIP和MaMMUT两种视觉-语言模型,发现虽然小规模计算下CLIP表现更优,但随着计算资源增加,MaMMUT展现更强的扩展能力。研究在多种下游任务和不同开放数据集上验证了结果一致性,...

MARBLE是一项由牛津大学、MIT和Stability AI联合开发的创新技术,通过操控CLIP空间中的材质表征,实现了图像中物体材质的精确编辑。它不仅支持基于示例的材质转移,还能实现材质混合和参数化控制,如调整物体的...