

2026-06-29
搭载摄像头的耳机:VueBuds能否取代智能眼镜?
华盛顿大学研究人员开发了一款名为VueBuds的原型耳机,在每只耳塞内嵌入低分辨率摄像头,通过蓝牙将灰度图像传输至手机端视觉语言模型处理。其功能与Ray-Ban Meta智能眼镜相当,可实现翻译标识、辅助低视力用户、识别...

华盛顿大学研究人员开发了一款名为VueBuds的原型耳机,在每只耳塞内嵌入低分辨率摄像头,通过蓝牙将灰度图像传输至手机端视觉语言模型处理。其功能与Ray-Ban Meta智能眼镜相当,可实现翻译标识、辅助低视力用户、识别...

今年4月,搭载谷歌DeepMind Gemma 3视觉语言模型的Yam-9卫星,首次在轨道上独立完成图像分析任务,无需地面人员介入。该模型由NASA喷气推进实验室开发的NAVI-Orbital软件包驱动,可响应自然语言指...

澳大利亚墨尔本大学研究人员训练协作机器人通过视觉语言模型(VLM)读取人类情绪,不仅分析面部表情,还综合考量交互情境因素。实验结果显示,VLM在情绪识别准确度上(0.86分)明显优于传统AI系统(0.77分)。研究同时发...

MIT与MIT-IBM计算研究实验室联合开发了专为图表理解设计的数据集ChartNet,包含逾百万张多样化图表及对应代码、文字描述、数值表格和问答对。研究团队利用两步合成数据生成流程,从单张图表出发可扩展出数百种变体。实...

MIT、伍斯特理工学院和谷歌的研究人员提出了一种名为"加权旋转去偏见"(WRING)的新方法,用于解决AI视觉语言模型中的偏见问题。现有的"投影去偏见"方法会导致"打地鼠困境"——消除一种偏见的同时可能放大其他偏见。WR...

MIT研究人员开发出一种基于生成式AI的视觉任务规划方法,在机器人导航等长期视觉任务上的效果比现有技术提升约一倍。该方法使用专门的视觉语言模型感知图像场景并模拟达成目标所需的行动,然后由第二个模型将模拟结果转换为标准规划...

新研究通过 DeepTumorVQA 基准测试表明,尽管 AI 在基本识别和测量任务上有一定表现,但在复杂医学推理上仍远落后于临床要求,难以取代医生的诊断判断。

Hugging Face 公司开源了 SmolVLM-256M,这是一个参数量最少的视觉语言模型。它能在普通笔记本电脑上运行,支持多种视觉数据处理任务。该模型采用新的编码器,在多项基准测试中表现出色,展现了小型模型的巨大...
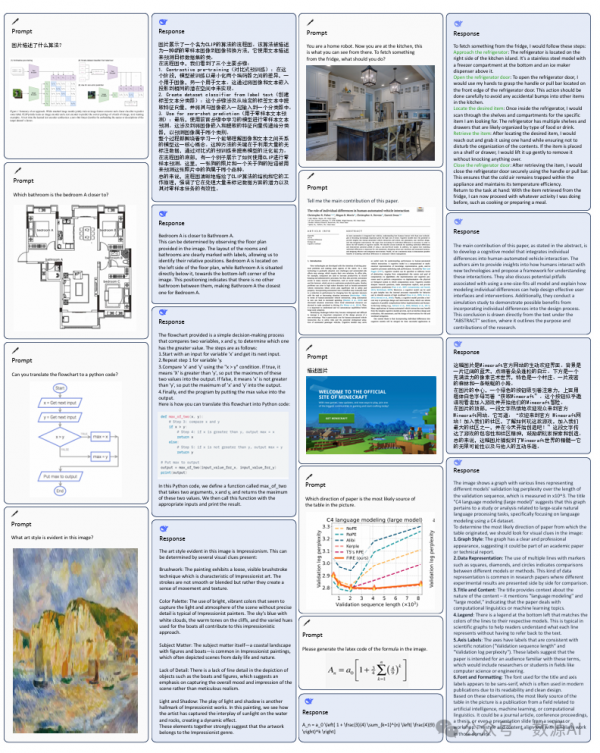
DeepSeek-VL是一个为现实世界设计的开源视觉语言模型,它通过数据构建、模型架构和训练策略三个维度来实现对高分辨率图像的高效处理和丰富语义理解。