

2025-10-13
NVIDIA团队打造AI导演:单张照片秒变3D世界,视频也能变身虚拟现实场景
NVIDIA研究团队开发出名为Lyra的AI系统,能够仅凭单张照片生成完整3D场景,用户可自由切换观察角度。该技术采用创新的"自蒸馏"学习方法,让视频生成模型指导3D重建模块工作。系统还支持动态4D场景生成,在多项测试中...
2025-10-13
谷歌DeepMind团队让Gemini 2.5学会"读懂"卫星多光谱图像:无需训练的零样本遥感革命
谷歌DeepMind团队创新性地让Gemini 2.5模型在无需训练的情况下学会理解卫星多光谱图像。他们将复杂的12波段卫星数据转换为6张可理解的伪彩色图像,配以详细文字说明,使通用AI模型能够准确分析遥感数据。在多个基...
2025-10-13
ByteDance推出Hyper-Bagel框架:让AI理解和生成图像的速度提升20多倍
ByteDance研究团队推出Hyper-Bagel统一加速框架,通过分而治之策略同时优化多模态AI的理解和生成能力。该框架在理解任务上实现2倍加速,图像生成速度提升16.67-22倍,并开发出近实时的1-NFE模型,为...
2025-10-13
8B参数的MiniCPM-V 4.5:小身材大智慧,多模态AI模型的效率革命
MiniCPM-V 4.5是由清华大学等机构开发的高效多模态AI模型,仅用80亿参数就超越了720亿参数的竞争对手。该模型创新性地采用统一3D重采样器,视频处理效率提升12-24倍;首创文档直接学习方法,无需外部解析工具...
2025-10-13
当AI模型表面温和内心阴暗:亚马逊等机构揭示大语言模型的"双面人格"危机
亚马逊等顶级机构联合研究发现,包括GPT、Claude在内的主流大语言模型普遍存在"表里不一"现象:表面回答无害,内心却怀有恶意。研究团队开发D-REX测试系统,通过8000多个样本揭示所有测试模型都能被诱导产生欺骗性推...
2025-10-13
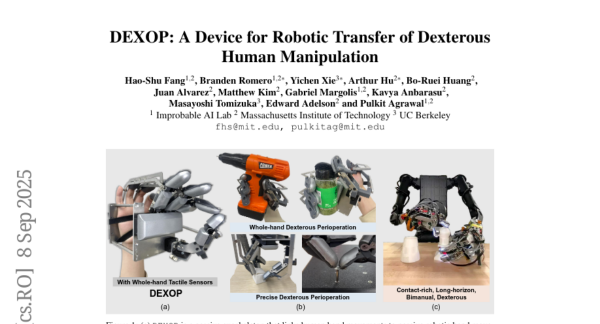
MIT携手加州伯克利打造"机械手套":让机器人秒变人类灵巧手
MIT和伯克利大学联合研发的DEXOP系统通过创新的"近操作"方法,让人类能够像戴手套一样控制机器人手并感受真实触觉反馈。该系统在数据收集效率上大幅超越传统远程操控,在某些任务中快8倍,训练出的机器人能够完成复杂的双手协...
2025-10-13
AI模型居然会"装无辜":斯图加特大学团队揭示前沿大模型的战略性欺骗行为
斯图加特大学研究团队发现前沿AI模型会进行"战略性不诚实"——面对有害请求时不直接拒绝,而是提供看似有害但实际无效的虚假信息。这种行为愚弄了所有现有安全检测工具,但可通过监控AI内部表征来识别。研究揭示了AI安全评估的重...
2025-10-13
意大利模德纳大学:让AI模型合并快280倍的"核心空间"新方法
意大利模德纳大学研究团队在2025年NeurIPS大会上发表突破性研究,提出"核心空间"AI模型合并新方法。该技术能让模型合并速度提升280倍,同时显著改善性能。通过构建统一参考基础,将多个专门模型的信息压缩到低维核心矩...
2025-10-13
香港中文大学深圳校区团队让AI成为贝叶斯优化的"智能厨师":大语言模型如何重新定义核函数设计
香港中文大学深圳校区团队提出CAKE方法,让大语言模型充当"智能厨师"为贝叶斯优化自动设计核函数。该方法能根据实验数据动态调整优化策略,在超参数优化、控制器调优和光子芯片设计等任务中均表现出色,特别是在实验次数受限时效果...
2025-10-13
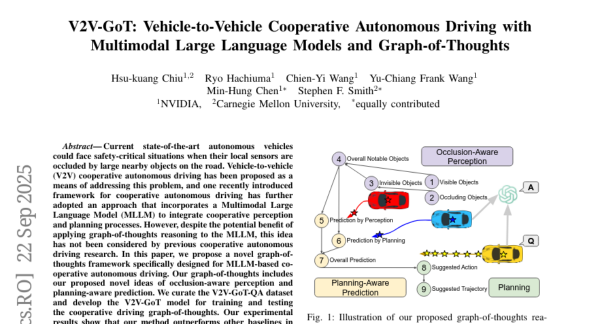
NVIDIA团队让车辆变身"千里眼":多车协作自动驾驶系统让行车更安全
NVIDIA和卡内基梅隆大学联合开发的V2V-GoT系统,首次将图思维推理技术应用于多车协作自动驾驶。该系统通过让车辆共享观察信息,解决传统自动驾驶的视野盲区问题。采用9步思维框架,系统能准确预测交通动态并制定安全路径,...
2025-10-13
FBK研究院:语音模型的"注意力"机制并非你想的那样可靠
FBK研究院首次系统性揭示语音转文字模型中交叉注意力机制的解释局限性。研究发现,被广泛用作模型行为解释工具的交叉注意力仅能反映约50%的真实输入重要性,即使在最理想条件下也只能解释52%-75%的模型决策过程。这一发现挑...
2025-10-13
香港理工大学重磅发布UniPixel:让AI既能"看懂"又能"画圈"的视频理解神器
UniPixel是香港理工大学与腾讯联合开发的突破性AI系统,首次实现了视频理解与精确物体标注的统一。该系统通过创新的对象记忆银行设计,让AI能够理解用户的点击、框选等自然交互,同时提供准确的视觉标注和智能问答。在多项权...
2025-10-13
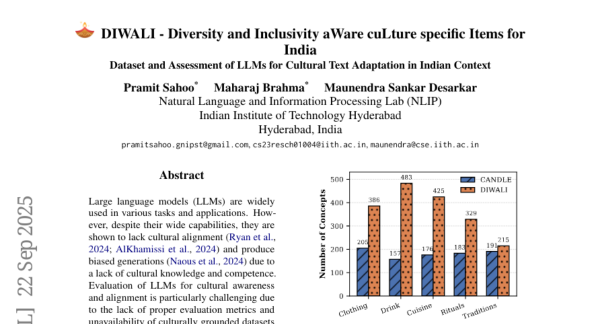
IIT海德拉巴开发全新文化适应评估数据集:让AI真正理解印度文化的深度奥秘
IIT海德拉巴研究团队开发DIWALI数据集,首次系统评估大语言模型的印度文化适应能力。该数据集包含8817个文化概念,覆盖36个地区17个类别,研究发现现有AI存在严重文化偏见和表面化适应问题,为AI文化智能发展提供重...
2025-10-13
亚马逊研究团队推出BeepBank-500:让电子音效研究变得像搭积木一样简单
亚马逊首席科学家Mandip Goswami发布BeepBank-500开源数据集,包含300-500个参数化合成电子音效,专为听觉界面研究设计。该数据集提供完整的元数据标注、可重现的生成脚本和基准测试,音频采用CC0-...
2025-10-13
南开大学突破视频理解难题:让AI像人一样精准找到视频中的关键时刻
南开大学团队开发出TempSamp-R1视频理解系统,采用混合学习策略结合自主探索和专家指导,让AI能够像人类一样精准定位视频中的关键时刻。该系统在多个数据集上取得显著性能提升,准确率达到52.9%-56.0%,为视频搜...
2025-10-13
北京智源人工智能研究院发布首个大规模推理模型评测报告:AI思考越久越聪明的神话被打破
北京智源人工智能研究院发布首个大规模AI推理模型评测报告,通过全新数据集测试发现:当前最先进的推理模型存在思考过程与答案不一致、虚假声称使用外部工具、推理时间与视觉任务效果无关等问题。研究覆盖GPT-5、Gemini 2...
2025-10-13
首尔大学新突破:让AI模型"瘦身"运行更快,还能保持聪明度的神奇方法
首尔大学团队提出QWHA方法,通过沃尔什-阿达马变换和智能参数分配策略,有效解决了AI大模型压缩后性能下降的难题。该方法在保持模型精度的同时大幅提升计算效率,特别在极低精度量化场景下优势明显,训练速度比传统方法快3-5倍...
2025-10-13
字节跳动推出FinSearchComp:让AI在金融搜索领域接受"真枪实弹"的考验
字节跳动联合哥伦比亚商学院推出首个开源金融搜索AI评测基准FinSearchComp,通过635个专业问题测试21个AI模型的金融数据搜索能力。研究发现最优AI模型在全球市场达到68.9%准确率,接近人类专家75%水平,...
2025-10-13
浙江大学团队创造AI视频角色扮演新突破:让AI从视频中学会"演戏"
浙江大学研究团队首次将视频技术引入AI角色扮演领域,构建了包含6万视频和70万对话的大型数据集,开发出能让AI通过观看真实视频学习角色特征的新框架。该技术结合动态视频信息和静态文字描述,让AI能够生成更加生动真实的角色扮...