
2026-11-12
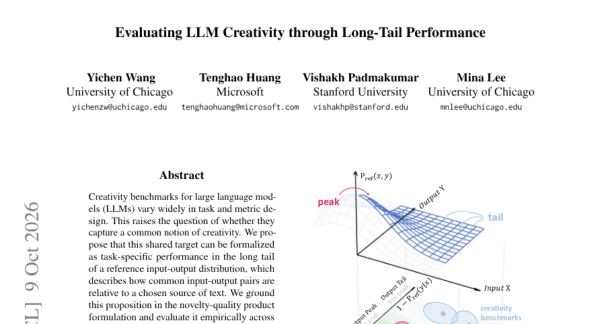
AI评价"创造力"的尺子,为什么一直对不上号?
论文提出用"参照分布长尾区域的表现"统一解释创造力评测的本质,覆盖15个基准、26个模型,发现尾部表现更贴近人类创造力判断,并提出低成本诊断指标q@Tail。

论文提出用"参照分布长尾区域的表现"统一解释创造力评测的本质,覆盖15个基准、26个模型,发现尾部表现更贴近人类创造力判断,并提出低成本诊断指标q@Tail。
研究发现,AI自主发现算法的成败,关键不在工具链设计多复杂,而在初始候选方案质量。论文提出先并行探索再串行优化的初始化策略,在五类任务上稳定提升发现效果2%至21%。
论文提出BranchOPD方法,在学生生成轨迹的关键犹豫点重新采样分支,让教师模型逐字监督,大幅提升蒸馏效果同时降低生成成本,并引入协议修复机制消除输出冗余问题。
论文提出用蒙特卡洛推理树识别解题过程中的不确定分岔点,结合两阶段数据收缩,让大模型推理训练仅用0.22%算力预算就超越全量训练效果,效率提升超450倍。

比亚迪上周发布第二代海豹07,售价13.99万元起,首发搭载云辇-M智能磁流变车身控制系统,支持100至10000 Nm阻尼力调节,纯电版CLTC续航最高775公里,电池10%充至97%仅需9分钟。

Zipline最新升级的"声学优化动态飞行"技术已全机队部署,通过机载声学建模实时调整飞行姿态,使每次飞行的总噪声暴露量降低68%,峰值噪声减少24%,同时每次飞行能耗降低21%,平均飞行时间缩短53秒。

Lincoln Electric推出XpertLINC,这是一款集成视觉、协调运动与过程控制的物理AI焊接技术平台,首发于Cooper协作机器人。该平台无需编程即可自动扫描零件、动态调整焊接参数,适应零件差异,并可标记不...

德国工业具身AI公司FMC? Robotics推出Doceo系列,通过智能摄像头头显、手套等设备采集工人操作数据,涵盖数据采集、处理、训练及机器人集成四大模块,并已在消费电子和电池生产工厂开展概念验证项目。

Serve Robotics与DoorDash在澳大利亚黄金海岸健康与知识园区推出该国首个人行道机器人配送服务,这也是Serve首次将业务拓展至美国以外。用户可通过DoorDash应用选择机器人配送,机器人完成订单后自主...

CMS宣布其六轴机器人大幅面增材制造系统Krearob将首次亮相法兰克福Formnext展会。该系统支持热塑性大型模具及复杂几何件生产,较传统制造可节省高达80%的材料与重量,适用于航空、汽车及工业制造领域。

论文提出TerminalHorizon数据合成引擎,通过独立挑战发现任务设计缺陷并重建环境,再渐进式扩展需求,生成长达52.8轮交互的高质量训练轨迹,训练出的27B模型在12个基准上全面超越基座,并展现出更强的自主实验与...

AgentSWE是一个检验编程智能体能否忠实造出用户真正需要的智能体的评测基准,涵盖创建、编辑、优化三阶段25个任务,发现当前模型普遍存在过拟合、空心运行时和虚假完工声明等失败模式。

论文提出MSAR,将残差连接升级为深度维度的多头注意力检索。通过多尺度因果卷积从序列上下文构造多个流,解决了深度信息稀释问题,在18B/28B MoE模型全部12项基准测试中超越标准残差、mHC、AttnRes,等损失算...

牛津、斯坦福、清华团队研究发现,六大主流AI模型在"关闭思考"模式下依然会暴露显式推理,答案空间越开放现象越明显,论文称之为"思维惯性",并揭示了严格指令压制思考与准确率之间的权衡关系。

论文提出SpatialASM框架,通过训练时使用允许中心视角生成器模拟空间场景,让大型视觉语言模型学会主动规划观察视角并在脑中想象画面,在七个空间推理基准上实现全面提升,同时保持通用视觉能力几乎不受损失。

论文指出手机智能助理依赖历史记录做个性化,但检索出来的相关历史只在任务开场有用,后续步骤和主动建议环节帮助有限。研究团队提出免训练框架ExpActivator,让每一步执行实时匹配适用的历史动作,建议环节按时间场景判断是...

这篇研究提出了HSS基准,测试AI能否像人一样从图像视频中推断隐含信息。结果显示最强AI模型仅得53.6%,远低于人类93.1%,暴露出视觉直觉推理这一被忽视的能力短板。

本文介绍了一种让AI学会推测对方隐藏信念和意图的心智模型框架,通过递归式信念建模和奖励联合训练,在社交互动、信念追踪、议价谈判等多个测试场景中显著提升了AI智能体的协作与博弈表现。

本文解读了DRMoET方法,一种让混合专家模型训练更稳健的分布鲁棒优化框架。它不只追求专家流量均衡,更关注专家在被错误路由选中时的实际表现,在746M和10.3B参数规模实验中均带来下游任务提升。

纽约大学团队分析12.7万条医生对AI助手的真实提问,发现文书和查资料占近三分之二,诊断仅占3.7%,而58个主流医疗AI测评题库与真实用法重合度中位数仅31%,揭示评估体系与临床实际严重脱节。