
2026-11-10
冲浪隐藏层:如何给大模型的"投机取巧"选对帮手
论文提出ELSI和ELSI-C算法,通过矩阵熵衡量信息量、CKA衡量层间冗余度,为投机解码的大模型选出最优隐藏层组合,替代固定位置公式,实验显示选层质量比层数更重要,部分场景下单层表现超过默认三层方案。

论文提出ELSI和ELSI-C算法,通过矩阵熵衡量信息量、CKA衡量层间冗余度,为投机解码的大模型选出最优隐藏层组合,替代固定位置公式,实验显示选层质量比层数更重要,部分场景下单层表现超过默认三层方案。
本文解读PreSTO方法,它通过预取MH采样中未来可能出现的决策树并批量生成候选,在保持大模型功率采样结果不变的前提下,将推理速度提升1.7到2.3倍。
高通2026财年收入431.20亿美元,同比下降3%,手机芯片收入240.72亿美元、减少约37亿美元。公司重申数据中心2027财年50亿美元收入目标,并预计非手机业务增长超60%。缺口与目标之间,隔着定制芯片和光连接的...
哈佛大学团队测试六个生物推理模型发现,打乱DNA/蛋白质序列对BioReason等模型预测准确率几乎无影响,模型更依赖文本而非生物学原始数据,且推理文字常与真实输入脱节,后训练提升准确率未必提升输入利用率。
两台e-puck机器人只能用一个比特信号交流,研究发现通讯是否出现取决于信息能否从别处获得,任务难度不增加通讯频率但筛选出有效策略,内置反射架构反而拖累需要配合的社会任务。
TouchScale是一个500小时统一设备采集的人类视觉触觉数据集,覆盖近2000项任务。实验显示其提升零样本触觉预测、动作识别及机器人操作成功率,验证大规模视触数据对具身学习的价值。
DiffusionART揭示了扩散模型强化学习训练不稳定的隐藏成因:前向反向一致性力,并提出聚合优先的奖励引导加自适应恢复力机制,无需EMA调参即可实现高效稳定训练,在图像和视频生成任务上大幅超越现有方法。
Reflex提出三阶段训练框架,让人形机器人仅凭自身RGB-D摄像头接住飞来的纸箱,无需动作捕捉或标记物。真实机器人在2.5米、5米分别达到65%、40%成功率,接近人类接球表现的76%和59%。
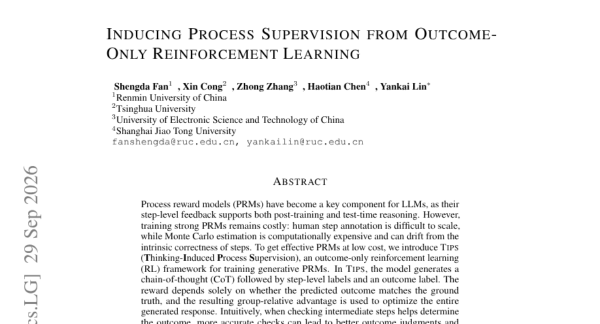
一篇研究提出TIPS方法,仅用结果对错作为训练信号,就能让AI模型学会精准定位推理过程中的错误步骤,用3200条数据超越了72B大模型和顶级商业AI裁判的表现。

论文提出ReHarness框架,让AI智能体在持续学习中具备"回头修正"记忆的能力,而非只能单向积累经验。三大基准、三种模型测试显示其显著优于现有记忆与反思方法,且更省token。

杜伦大学与阿里达摩院团队提出CASE框架,训练8B小模型自主在纵向病历与影像中查找证据,诊断准确率超越GPT-5.4和Claude Opus 4.8等大模型。

MixTok提出一种混合视觉编码方法,结合紧凑的1D全局token与稀疏2D局部token,通过内容自适应打分机制动态分配细化预算,在ImageNet上实现1.195的重建FID和1.95的生成FID,兼顾压缩效率与细节...

这篇论文提出SOLOQ,一种无需校准数据的扩散语言模型量化方法,通过K-RPBH旋转把激活值映射到可预测分布,支持4比特量化,在多个模型上实现最高2.61倍内存压缩和2.24倍推理加速。

ProgramGym提出可规模化训练环境Program-Env与分角色工作流Program-Agent,让AI学习从零复现程序。实验显示开源模型Qwen3.8-27B经训练后测试通过率从34.87%升至55.71%,超越...

本文解析了一项关于大模型训练的研究,揭示相对策略差异迁移中真正起作用的是任务训练产生的方向性差异而非模型规模差异,并发现专家与参照模型分工互补,目标模型的兼容性决定迁移成败。
在旧金山,AI正成为影响约会选择的重要因素。有人因对方使用AI直接左滑拒绝,有人担忧AI灭绝风险而不愿规划未来,还有创业者用AI代理自动完成配对沟通。调查显示,26%的美国单身人士已借助AI工具辅助约会。


本文介绍LatentGRM框架,它用连续潜在向量代替冗长文字评语完成AI多标准偏好判断,在8B模型上将评估轨迹压缩8.9至9.2倍、推理时间降低6.1至7.0倍,同时保持判断准确率,并验证压缩信息可被还原解读。
论文提出HT-Coreset方法,通过全量保留违法交易、分层采样正常交易并加权估计,将反洗钱大模型评估成本压缩271至611倍,同时验证了七个开源大模型的检测精确率接近"全部判违法"基线,且推理文本中的专业术语无法可靠证...

论文提出Video-RSI框架,让视频理解智能体用冻结权重的同一语言模型充当求解器和编辑器,通过主动重访训练视频诊断失败原因,并结合准确率与视觉成本筛选修改,实现脚手架的递归自我改进,在多个基准上提升准确率同时减少帧使用...