


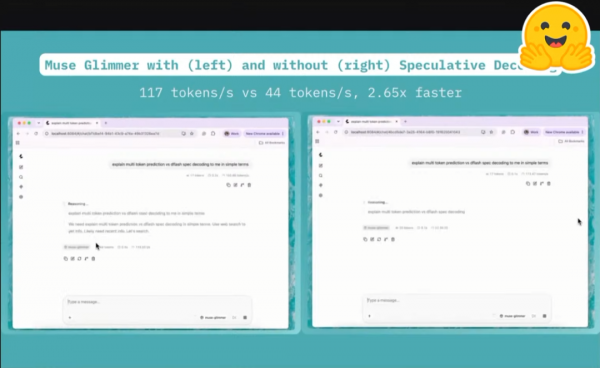
同一台电脑、同一个模型、同一段提示词,左侧的回答已经生成完毕,右侧还在逐字往外蹦。
Hugging Face最近用一场长达82分钟的技术直播演示了这组对比。两边运行的是同一个目标模型,输出质量也由同一个模型把关,区别只在于左侧多了一个很小的“草稿模型”。
在部分测试中,这种组合把单请求生成速度提高到原来的近4倍;即使并发请求不断增加,仍能获得约2倍的吞吐提升。没有更换显卡,也没有把大模型继续压缩,变化发生在Token生成方式上。
这项技术叫做推测解码,英文是Speculative Decoding。它正在被llama.cpp、Transformers和vLLM等主流推理框架吸收,也让“草稿模型”逐渐成为本地运行大模型时一个绕不开的角色。
大模型为什么总在“逐字加载自己”
一次大模型推理通常分为预填充和解码两个阶段。
用户输入提示词后,模型会在预填充阶段集中处理整段内容,计算注意力并建立KV Cache。这个阶段一次处理大量Token,主要受计算能力影响。开始回答以后,模型进入解码阶段,每次只能生成一个Token。
问题也出现在这里。
为了生成下一个Token,显卡需要读取模型权重和已有的KV Cache;生成完成后,再把新的键值数据写入缓存。随后,为了生成下一个Token,这个过程重新执行一遍。
一个模型有几十GB甚至几百GB权重,生成每个Token都要搬运大量数据。此时GPU拥有多少计算单元已经不再是唯一决定因素,显存带宽以及数据搬运速度会直接限制生成速度。
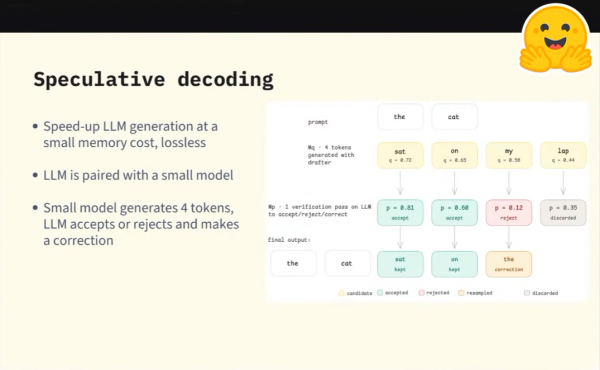
草稿模型的思路,是把一部分容易预测的工作交给一个更小、更快的模型。
例如,用户输入“The cat”,草稿模型可能连续预测“sat on my lap”。目标模型随后用一次前向计算检查这些候选Token。前两个Token如果符合目标模型的概率分布,就会被直接接受;第三个Token被拒绝,后续候选也会随之丢弃,再由目标模型生成修正Token。
过去目标模型需要运行三四轮才能完成的工作,现在有机会压缩到一轮验证中。草稿模型体积很小,生成候选Token的成本远低于目标模型多次读取完整权重的成本。Hugging Face官方文档也将其概括为:助手模型先提出候选Token,主模型通过一次前向计算集中验证。
草稿写得越多,速度未必越快
推测解码看起来像一顿“免费午餐”,真正决定加速效果的指标叫作平均接受长度,也就是目标模型每轮平均接受多少个草稿Token。
草稿模型一次预测4个Token,如果其中3个被目标模型接受,相当于用一次大模型计算推进了多个位置。草稿模型如果频繁猜错,目标模型只能不断否决和修正,额外计算反而可能拖慢整个生成过程。
这也解释了为什么草稿模型不能随便搭配。
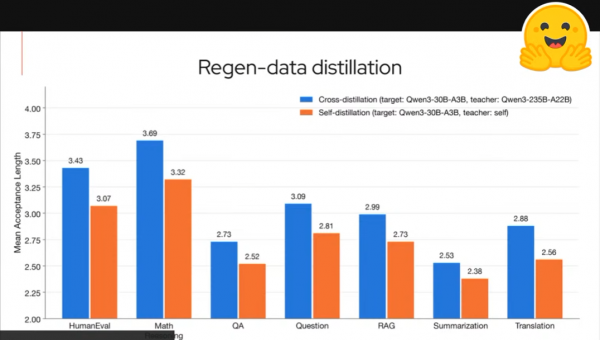
用于法律文本的目标模型,配上一款主要训练代码的草稿模型,两者的Token概率分布差异很大,接受率很可能快速下降。模型开发者提供的配套草稿模型通常更稳,因为它们针对目标模型的数据分布、隐藏状态和词表进行了专门训练。
草稿长度同样需要控制。一次预测8个Token,看起来比预测4个更有效率,但第三个Token一旦被拒绝,后面的5个全部作废。视频中的建议是从较短长度开始测试,4个Token通常是相对安全的选择,结构稳定的代码和数学任务可以尝试更长的草稿。
结构化任务也是草稿模型更容易发挥作用的场景。代码必须遵守固定语法,数学推导中也存在大量可预测模式;故事和诗歌追求更多随机性,草稿模型更难提前猜中目标模型的选择。
EAGLE、DFlash和MTP,草稿模型也有不同路线
传统推测解码使用一款独立小模型,自回归生成候选Token。EAGLE进一步读取目标模型的隐藏状态,让草稿模型获得更多上下文信息,提高候选Token的接受率。
DFlash采用了另一种方法。它通过轻量扩散模型一次并行预测一整块Token,减少草稿模型内部的串行生成。官方说明显示,在同步请求中,DFlash可能获得比EAGLE-3高2至3倍的加速,但实际表现仍取决于模型、任务和硬件配置。
MTP,即多Token预测,则把预测多个未来Token的能力放进模型或配套检查点中。部分模型自带MTP层,Gemma 4等模型采用独立助手检查点,并复用目标模型的输入嵌入和KV Cache。Transformers和vLLM已经提供了相应的加载方式。
视频展示的Gemma 4 E2B草稿模型不到1亿参数,目标模型约为20亿参数。草稿模型复用目标模型的隐藏状态,通过4层解码器快速预测候选Token,再交回目标模型集中验证。一次草拟3个Token时,目标模型如果接受前两个,还能在同一轮计算中补上一个修正Token,相当于一次前向计算推进了3个位置。
接近4倍加速,也有明确的适用边界
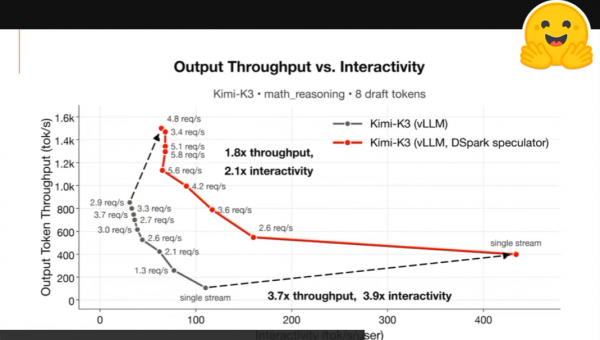
视频公布的一组Gemma测试显示,使用DSpark草稿模型后,单请求场景获得了接近4倍的速度提升;随着并发请求增加,收益下降到约2倍。另一组Gemma 4测试中,MTP的提升范围约为1.6倍至3.5倍。
并发越高,GPU一次可以批量处理的请求越多,原有推理方式对硬件的利用率也随之提高,草稿模型带来的额外收益便会缩小。DFlash一类并行草稿技术在低并发下优势明显,进入高并发场景后,MTP可能表现得更稳定。
任务分布也会改变结果。数学、代码等低熵任务更容易预测;开放式创作或训练数据之外的任务会降低接受率。视频中的DFlash测试在高熵任务上,有时只能追平MTP,甚至可能更慢。
“无损”也需要准确理解。推测解码保证输出仍来自目标模型的概率分布,草稿模型没有最终决定权。采用贪婪解码时,短输出通常可以做到Token级一致;随着序列变长,不同CUDA Kernel、浮点误差和采样实现仍可能让输出逐渐出现差异。
llama.cpp目前已经支持普通草稿模型、EAGLE-3、DFlash、DSpark、MTP和多种N-gram推测方式,并会输出草稿生成数、接受Token数与接受率等统计信息。
对本地大模型用户来说,草稿模型带来的价值很具体:当模型已经能够装进显存或统一内存,下一道门槛往往就是生成速度。此时继续量化可能损失能力,更换硬件又意味着新的成本,推测解码则提供了一条软件优化路径。
但它真正加速的前提,始终是草稿足够快,也足够准。观察Token/s之外,还应记录平均接受长度、草稿接受率、首Token延迟、并发吞吐和额外内存占用。只有这些数字同时成立,草稿模型才算真正替目标模型省下了时间。
视频开头那场速度对比,最终可以归结为一次计算分工:几十亿、上百亿参数的目标模型负责判断方向,体积小得多的草稿模型负责处理容易预测的Token。大模型依然掌握最终决定权,却不必亲自完成每一步重复工作。
这也给本地大模型优化提供了一个新的观察角度。模型已经装进内存之后,速度提升未必只能依赖更高带宽的显存、更激进的量化或价格更高的显卡。草稿模型如果拥有足够高的命中率,同样能把现有硬件的性能继续向前推一步。接下来真正值得比较的,将是不同草稿模型在代码、数学、长文本和开放式创作中的接受率,以及它们能否在普通个人电脑上稳定兑现宣传中的数倍加速。


