


物理AI场景下,对芯片的要求与云端推理并不一样。以一次避障或抓取为例,感知、推理、执行、通信几乎是接连发生的,留给每个环节的时间窗口很短。对计算芯片来说,光是承担推理过程中的计算任务远远不够,还需要保证推理的每一步都能按时完成。因为,一旦某个环节有延迟,就会直接体现在设备的实际动作上。
甚至,汽车和机器人对芯片还有更多要求:既要通过功能安全认证,功耗也不能增加,还要保证长时间稳定工作。
过去,设计这样一颗芯片,常见的办法是先购买处理器IP,再把NPU、DSP、安全模块等不同IP拼到一起,最后完成流片。这一模式本身并无问题,但其隐含了一个前提,那就是目标负载相对稳定。一旦真实负载发生迁移,选定的IP组合便不再适配,架构调整与验证返工随之而来。更为根本的是,处理器架构一经确定,上层软件栈与开发工具链便被一并锁定,后续调整空间十分有限。
面对这一痛点,近期MIPS发布了Acies、Actus、Aegis三款“工作负载原生”平台,并将每瓦Token数(tokens-per-watt)作为衡量能效的核心指标。
“我们希望从IP供应商转变为全栈技术解决方案供应商,定制芯片战略将成为整个业务的重要一环。”MIPS首席执行官SameerWasson表示。
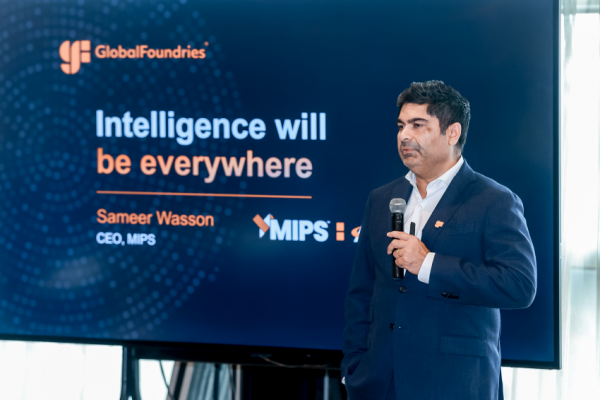
MIPS首席执行官SameerWasson
01 从授权IP到交付芯片
这种转变,与MIPS今天所处的行业位置有关。
事实上,MIPS已有四十多年的技术积累,如今隶属格罗方德。今年6月,格罗方德完成对新思科技ARC处理器IP业务的收购,ARC随之并入MIPS。合并后的MIPS目前是全球第一大RISC-VIP供应商,也是仅次于ARM的全球第二大处理器IP厂商。
在SameerWasson看来,IP授权仍是核心主业,但并不是业务的全貌,未来相当一部分新增收入将来自芯片制造及流片后的用户交付,背后则依托格罗方德的全球化制造平台。
为此,MIPS在三大洲搭建了约750人的研发团队,在中国设有上海和武汉两处基地。ARC与MIPS不再分设实体,统一下设RISC-VIP、AI加速器与DSP、软件工具、定制芯片四个业务板块。
不过,背靠格罗方德并不意味着IP与工艺绑定。
SameerWasson介绍,其处理器设计会独立于任何代工厂,用户的流片选择与台积电、三星、联电的市场份额分布大体相似;如果选用格罗方德的FD-SOI工艺,则可以在低功耗和汽车环境抗干扰上获得额外收益。
02 以“STAC”重构物理AI的计算架构
交付芯片,首先要知道芯片是为谁而设计的。
MIPS首席技术官Yankin Tanurhan博士给出的框架是STAC赋能物理AI。STAC即感知(Sense)、推理(Think)、执行(Act)与通信(Communicate),对应物理AI每个环节的工作负载。其核心思路是软件先行,先站在程序员的视角梳理开发流程、推出SDK,再反过来定义处理器,让用户针对自己的负载去优化,这就是所谓的“工作负载原生”。

MIPS首席技术官Yankin Tanurhan
具体来看,推理环节由Acies承担,这是一款推理原生平台,搭载基于开放标准的NPU和开放软件栈,采用易于集成的M.2PCIe规格,可以直接插入现有系统做边缘加速。
执行环节由Actus承担。这是一颗“事件原生”的MCU,面向运动控制、传感器融合和预测性维护等场景,基于RVM23微控制器规范,搭配512位向量协处理器,以开发板形态提供给开发者,且符合ISO26262和ISO21434标准。
Aegis则是一款安全原生CPU,面向需要低延迟和智能体(Agent)处理能力的关键任务系统,可用于汽车运行状态监控,以及航空航天和工业控制等场景。由于是全新设计,用户可以从零开始搭建自己的安全子系统。
支撑这三款平台的,是MIPS整套可授权的计算IP产品,覆盖SoC的各个环节。
AI加速这一档,有支持RVA23与矩阵扩展的S8200,以及NPX6神经网络处理器;应用处理器是4发射乱序、双路多线程的P8700;面向区域网关和机器人控制器的实时LinuxMPUI8500,采用3发射顺序、4路多线程;再往下是ASIL-D级入门MCURMX100,以及用于雷达、音频和基带的VPXDSP。其中NPX6单引擎稀疏算力可达440TOPS,最多8个引擎组成集群,单颗SoC可达3500TOPS。
不过,这些产品线不是“从零起步”。Yankin Tanurhan介绍,其采用同一微架构的芯片已有超过2亿颗落地ADAS,MIPS技术覆盖全球超过50家主机厂的1200余款车型;其年出货量约35亿颗。客户覆盖面同样可观,全球12大汽车制造商中9家、AI与数据中心基础设施芯片前15大厂商中的13家,都是MIPS用户。
产品线丰富,意味着同一套IP可以覆盖不同产品和应用场景。用户从一个场景扩展到另一个场景时,不需要重新选择处理器架构,原有的IP、软件栈和开发经验都可以继续复用。
“目前,这种复用已经出现在中国市场。”Yankin Tanurhan透露道。
03 标准与开放的“AB”面
平台之外,一个更根本的问题是:RISC-V这套架构本身,能否撑起物理AI?
YankinTanurha给出了肯定的判断。在他看来,RISC-V是处理器历史上普及速度最快的架构,而它之所以适合物理AI,关键在于开放,也就是不被单一供应商锁定。
事实上,物理AI产品的研发周期长、投入大,一旦作为企业的私有架构,用户的命运就和这家供应商绑在了一起,对方交付不力,项目就会卡在研发环节,进退两难。而如今的RISC-V则给了用户另一种选择,同一套指令集下有多家供应商可选,切换时既能保留现有方案,又能把迁移成本降到更低。
用YankinTanurha的话说,“如果能把成本压到零,这就是商业意义上的成功”。
不过,开放是一把双刃剑。人人都能参与,也就意味着人人都可能各走各的路。以矩阵扩展为例,RISC-V社区目前仍有IME、VME、AME等多条技术路线并存,而不少厂商等不及标准落地,就已经先行推出了私有扩展。
对于这种“抢跑”的风险,YankinTanurha认为已有前车之鉴。
就比如,RISC-V向量扩展(RVV)从2015年提出,到2021年底才正式批准,前后历时六年。其间,一些厂商按0.7.1草案提前量产了芯片,结果与正式的1.0版本并不兼容;而主流编译器只支持1.0,这些厂商要么返工,要么再单独维护一套工具链。
那么,标准为什么来得这么慢?原因在于参与者太多。
要知道,仅RISC-V国际基金会董事会就有二十多家公司,背后还有成百上千家会员单位,凝聚共识注定需要时间。因此在YankinTanurha看来,定制化不可避免,但标准必须先行,否则开放带来的碎片化问题,反而会吞噬开放本身的价值。
"标准先行"的思路,同样贯穿于MIPS对存量IP的处理之中。
一方面,旧IP不会被淘汰。因为,部分客户采用MIPS的IP已超过15年,汽车领域的产品支持周期甚至超过了20年,贸然停止支持,将直接损害这些长期合作的客户。
另一方面,新品已全面转向RISC-V架构。YankinTanurha指出,原ARC产品线中,EM系列演进为RMX,HS系列演进为RHX;VPX这类DSP产品暂缓迁移,待相关标准成熟后再行过渡。