


如今,物理AI正在汽车、工业机器人和各类嵌入式设备上逐步落地。与云端数据中心的AI不同,物理AI的算力大都分散在设备内部的多个硬件单元中。比如,传感器前端、域控制器(Domain Controller)、电机驱动器,各自承担一部分工作。
然而,这些节点的负载差异也相对较大。有的需要运行Transformer模型做推理,有的负责电机电流环(Current Loop)这类控制任务,却要求每几十微秒完成一次确定性响应。对系统设计者来说,算力应该放在哪些节点,节点之间如何连接,以及不同处理器怎样协同,都需要在设计阶段确定下来。
与此同时,系统架构变化后,用户对处理器IP厂商的要求也随之变化。过去,系统厂商拿到RTL代码和数据手册,就可以进入后续设计。而现在,则需要在芯片流片(Tape-out)之前,就能拿到功耗、带宽和延迟等实测数据,用于验证方案,提前发现问题。
而围绕这些需求,MIPS首席技术官Yankin Tanurhan博士给出了MIPS的应对思路。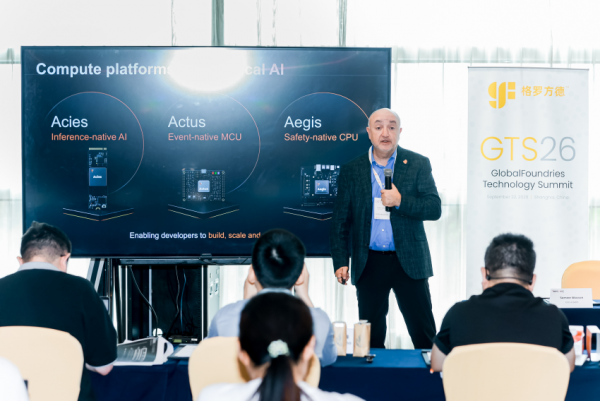
MIPS 首席技术官 Yankin Tanurhan博士
如果用三个词归纳Yankin Tanurhan的观点,或许可以总结为架构、产品和交付。
架构层面,MIPS通过其STAC框架把物理AI的工作链路拆成感知(Sense)、推理(Think)、执行(Act)、通信(Communicate)四个环节,形成完整闭环,再为不同环节匹配相应的处理器IP。
产品层面,MIPS把STAC框架对应到不同类型的工作负载,并于9月初发布Acies、Actus、Aegis三款“工作负载原生”(Workload-Native)开发平台。三款平台分别面向AI推理、实时控制和安全关键型应用。
交付层面,MIPS把验证环节进一步前移。依托母公司格罗方德(GlobalFoundries,GF)的晶圆制造能力,MIPS在提供处理器IP之外,还提供可实测的芯片原型,让客户在正式流片之前完成性能评估和方案调试。
这套能力的扩充,也与 MIPS 今年完成的产品线整合直接相关。今年 1 月,格罗方德宣布收购新思科技(Synopsys)的 ARC 处理器 IP 业务,6 月正式完成交割。ARC-V、ARC Classic、VPX 等产品线,ASIP Designer 等定制处理器工具,以及对应的工程团队,整体并入 MIPS。
ARC系列的加入,进一步扩充了 MIPS 的处理器产品矩阵:原有 RISC-V 产品线(包括乱序多线程 CPU)继续承担通用计算任务,ARC 系列则补齐了实时处理器与 DSP 能力,覆盖运动控制、信号处理等专属负载。
01 让"通信"独立成环,STAC的“第四块拼图”
顺着架构层的设计逻辑,Yankin Tanurhan最先拆解的,就是 STAC架构中“C”的由来。
其实,在行业通用的机器人系统设计里,传统架构只覆盖Sense、Think、Act 三个核心环节,MIPS 却把 Communicate 单独列出来,与前三者平级。
在Yankin Tanurhan看来,并非所有工作都需要在本地处理,到了某个阶段,数据总要传输到某个中央计算单元,而且这种情况会越来越普遍。集中式架构的智能汽车和多关节机器人都是如此,节点越分散,数据流动就越关键,如果通信跟不上,前三个环节做得再好,闭环也转不起来。
他将通信链路拆解为三个核心指标:带宽、延迟与传输功耗。
带宽决定多路摄像头、雷达数据能否无拥塞送达计算单元;延迟会直接叠加在 “感知到执行” 的端到端时延上;而在边缘设备上,数据搬运消耗,和AI本身消耗的算力达到了同一量级。
而事实上,这三个维度也恰好是 MIPS 的长期积累方向。Tanurhan 表示,MIPS 在通信领域深耕多年,后续会推出对应的组件与平台,简化有线、无线接口的开发落地流程,缩短实现周期。
从产品侧看,在 MIPS的产品布局中,对应通信环节的是I8500系列处理器,这是一款支持 4 路 SMT(Simultaneous Multi-Threading,同步多线程)的顺序执行内核,主要面向区域网关(Zonal Gateway)与中央网关场景,承担数据编排任务。
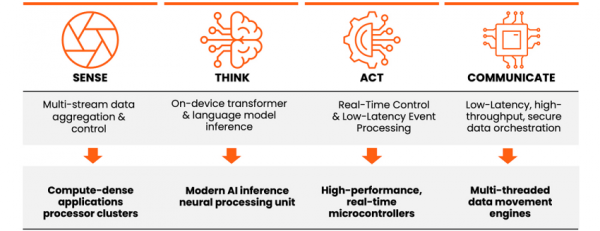
STAC框架
02 工作负载原生平台,让“设计左移”
框架决定了算力如何分配,但客户更关心的,往往还是如何更快地完成场景中的系统落地。而MIPS发布的Acies、Actus、Aegis三款工作负载原生平台,分别聚焦AI 推理、实时控制与功能安全场景。
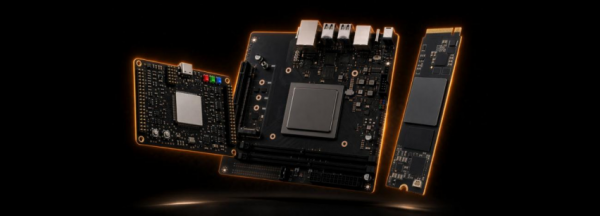
MIPS 三款工作负载原生平台
(截取自MIPS)
对于全新平台形态同时覆盖开发板与成品芯片,外界自然会追问:MIPS 是否要转型做板卡或芯片供应商?
对此,Yankin Tanurhan明确表示,MIPS 的核心目标是加速客户的开发周期。
“这些开发板乃至芯片,本质上是参考样例、设计模板与验证平台。我们不会转型做目录型板卡或目录型芯片供应商,这从来不是我们的定位。”Yankin Tanurhan强调,MIPS 做开发平台的历史由来已久,客户可以用这些平台搭建原型,甚至在芯片流片前,就拿它和下游客户做方案沟通,让软件开发与方案验证工作提前启动。这正是业界所说的 “Shift Left(设计左移)”。
所以,不难看出,MIPS 这次发布算不上商业模式的范式转变,更像是对原有支持方式的强化。“把IP 交付给客户就撒手不管,从来不是好的客户支持方式。而只给 IP,客户拿到的只是纸面参数;配套软件之外,再加上可实测的芯片,客户才能拿到真实可靠的数据。”Yankin Tanurhan如是说
至于 “工作负载原生” 的概念,Yankin Tanurhan的解释是 “从问题出发”。
其实,不少 AI 项目在起步阶段很容易忽略负载需求,在没有理清场景要解决什么问题时就启动开发。而MIPS 的思路与之相反,先针对具体工作负载做性能评估与架构选型,再据此设计芯片产品。NPX6内核就是典型的特征,其支持 CNN、RNN/LSTM、Transformer,在大模型推理场景下有不错表现。
另外,这套 “工作负载原生” 的思路,还配套软件优先的设计原则。开发者的业务负载,在项目早期就能在平台上调试运行,不必等到芯片流片之后才验证软件方案。
不过这套工作负载原生的思路,也并没有将Acies、Actus、Aegis三款平台设计成大一统的综合套件。考虑到汽车、航空航天、工业自动化、机器人等下游场景的需求高度分化,不同领域对应的算力、实时性、安全标准差异显著,因此三款平台均采用独立模块化设计,作为专用子系统供客户按需选配,避免通用方案适配性差、资源冗余的问题。
而这种贴合实际落地需求的产品形态,也离不开 MIPS 全新的交付能力支撑。依托母公司格罗方德的晶圆制造优势,MIPS 彻底解决了以往自身与 ARC 业务的核心痛点。
过去,行业仅能依靠仿真数据与技术手册完成前期评估,无法验证IP在真实硅片上的实际表现;如今MIPS可在交付处理器IP的同时,提供可实测的芯片原型,让客户在流片前即可完成真实性能测试与方案调试。这一模式早已落地了原型芯片辅助开发的模式,而格罗方德成熟的制造体系,促使这套前置验证流程更加高效、落地性更强。
交付能力的升级,也进一步厘清了 MIPS 的商业模式定位。不同于Arm推出自有 CPU芯片、直接下场做产品的路线,MIPS 的核心方向仍是打造开发平台,赋能客户自主设计芯片。其内部虽然有定制芯片的团队,能够承接特定场景的芯片设计服务,但这类定制项目,和面向市场批量售卖通用目录芯片还是两回事。
02 MIPS+ARC“融合”,扩充 “体量”
MIPS 敢于跳出传统IP厂商的单一交付模式,推进 IP、软件、硅原型一体化交付,背后依托的核心底气之一,也正是今年完成的ARC业务整合。这类全链路前置交付体系,对团队工程能力、产品线完整度的要求,远高于传统纯IP售卖模式,而并购整合的价值,也在进一步释放。
经过半年的业务交割与体系梳理,MIPS已完成组织层面的全面融合。目前内部已形成统一的RISC-V研发团队,全盘承接原MIPS与ARC 两大技术体系的积累,统一工程规范与研发流程,彻底告别过去两套团队、两套标准的状态,组织层面的整合已基本收尾。
从行业格局来看,RISC-V的规模化落地已是全球性的确定趋势,中国市场的高速崛起更是典型缩影。
但是,此前的生态依旧存在明显的短板,行业始终缺少体量足够、技术全面、交付可靠的头部综合IP 供应商。
而因为这次整合,MIPS达到了可与行业巨头正面竞争的“体量”。Yankin Tanurhan透露,目前公司坐拥700多人的跨国研发团队,研发力量覆盖中国、美国、印度三地,形成了足够支撑高端车载、工业物理AI场景的研发规模,且具备了承接大型客户全链路定制化需求的实力。
但人员到位、组织统一只是并购整合的第一步,如果只是把MIPS 原有RISC-V产品线和收购来的 ARC 产品线挂在同一家公司名下卖,两边技术体系各做各的、互不通气,这次收购就只是规模扩张,算不上真正的能力升级。
而这,也是MIPS将微架构层面的技术融合,被放在核心位置的原因。具体来说,MIPS沉淀多年的是高性能通用计算能力,代表产品P8700,搭载 16 级流水线、4 发射乱序执行架构,支持双路SMT多线程,主打高吞吐、低时延,面向车载 AI、自动驾驶这类对峰值算力要求高的场景;ARC经过多年工业、嵌入式场景打磨,攒下了小面积、超低功耗、硬实时的技术积累,像ARC-V RHX、RMX 这类内核原生适配运动控制等强实时负载(VPX 则对应信号处理,RPX 承担 64 位主机侧计算)。
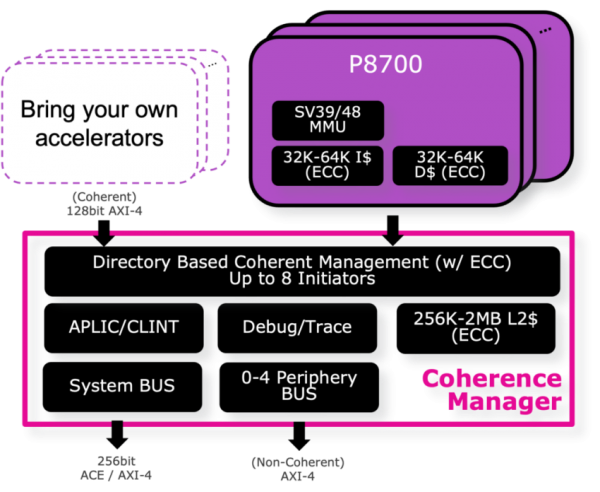
P8700 多处理系统框图
截取自MIPS
两套架构打通之后,产品的灵活度会比单做任何一条线都高。
至于原因,则是,MIPS后续新品会把原本只在高端MIPS内核上配备的SMT多线程能力,做成可配置选项,原本主打低功耗、小尺寸的 ARC 内核,不用推翻原有架构,只要付出很小的芯片面积代价,就能获得多线程带来的吞吐提升。
而且,两边研发已经合为一支团队,不存在技术壁垒和跨公司协作成本。最终MIPS 就能凑齐从高性能AI推理到低功耗实时控制的全栈产品能力,进一步适配物理 AI 场景里算力分散、节点负载差异极大的现实需求。
03 直面ADAS严苛场景:“CPU双路线+NPU阶梯式”矩阵
两套技术体系融合出来的全栈产品能力,不能只靠参数证明竞争力,最终要放到要求最严苛的场景里检验。
ADAS是物理AI中传感器密度高、异构算力组合较为复杂的落地场景。在ADAS这类场景下,CPU 到底该堆独立物理核,还是靠SMT提升算力密度,行业已经争论了很久。
堆独立物理核自然不必多说,靠堆硬件换线性算力增长,虽然简单可靠,但芯片面积开销大。而SMT的本质其实是 “榨干执行单元的空闲时间”,让单个物理核同时跑两个线程,其中一个线程遇到缓存未命中、停在原地等内存数据的时候,本来要闲置的计算工作流不会空转,而是直接把空闲的执行槽位让给另一个线程的指令跑。
但是,这种 “挤空闲资源挤出来的性能” 存在“天花板”。
试想,两个线程共享同一套执行单元和缓存,做不到真正的物理隔离。如果跑的是对功能安全隔离要求极高的任务,还是要用独立物理核把资源彻底隔开。
面对这道选择题,MIPS 没有押注单一路线,而是同时布局了两种CPU 架构,让客户按负载特性自行选择。
从产品侧来看,一条路线是P8700,其依靠SMT提升单位面积的算力密度,适合传感器数据高度并发、需要在有限面积内榨出更多吞吐的场景。另一条路线则来自ARC,ARC-V RPX 系列的多核型号 RPX-105,最多可扩展到 16 个物理核,并可在同一集群内连接多达 16 个硬件加速器。
两者面向的负载并不相同,可互为补充。
不过,CPU 解决的是并发与实时调度的问题。一旦进入 AI 感知推理这类重负载,仅靠CPU就不够了。MIPS 的做法,是把这部分计算进一步卸载到专用NPU,并按算力区间划分高低两档产品布局。
代表性的高端产品是NPX6,面向200 TOPS以上的ADAS场景,采用数据流架构,让数据沿着计算图在片上存储和计算阵列之间流动,尽量减少对外部DRAM 的反复读写,从而同时降低带宽压力和功耗。官网数据显示,单颗NPX6采用5nm 工艺、1.3GHz 主频,在最差工况下可提供约250 TOPS算力,开启稀疏化后可达440 TOPS;最多8颗实例级联后,单颗 SoC 的算力可达3500 TOPS。从落地情况看,目前已有客户将NPX6用于高级 ADAS 项目,并全部通过资格验证。
在更低的算力区间,MIPS推出了基于RISC-V的S8200,面向 Transformer、多模态和智能体负载,重点解决了应用在 RISC-V生态下的编程和部署问题。
不过,要让RISC-V更好适配 Transformer,仅靠向量和矩阵扩展并不够。原因在于,Attention计算并不是一串连续的矩阵运算,两次矩阵乘之间还夹着Softmax,其中包含指数、求和、归一化等非线性操作。如果这些步骤都交给通用向量单元逐行处理,那么即使矩阵计算再快,整条流水线仍会被这些零散运算拖住。
正因如此,S8200在向量引擎之外,又加入了矩阵乘法和Softmax等高频算子的专用加速单元,把原本需要通用计算单元反复处理的部分直接固化下来。
这样做的目的,就是减少矩阵计算与非线性算子之间的等待,让AI推理能够连续运行。
04 “紧耦合”保障机器人响应速度
机器人被普遍看作物理AI最重要的落地方向之一。但和汽车领域向中央计算集中的趋势不同,机器人的芯片选型到今天仍然比较分散。x86、Arm、RISC-V以及各类专用AI加速平台,都有自己的适用场景。
不过,在具体的场景下,分化程度并不一样。无论客户使用PyTorch还是ONNX,主流软件框架已经比较统一。基于这两种框架开发的模型,MIPS可以通过SDK直接编译和部署,有户不需要重新进行硬件适配。
执行环节则完全是另一回事。机器人的每个动作最终都要靠电机控制来完成,而电机控制看的不是算力,是响应速度和稳定性。就比如,以常见的磁场定向控制(FOC)为例,一个电流环的周期通常只有50到100 微秒。在这段时间里,芯片需要连续完成采样、坐标变换、电流调节和PWM 输出。只要其中任何一步因为缓存未命中等原因发生延迟,控制输出就会出现偏差。
可见,对于这类任务,实时处理显然比单纯追求高算力的处理器更合适。
这恰恰是ARC系列长期积累的优势所在。MIPS在控制和传感器子系统上已经深耕多年,其ARC-V RHX正是延续了这套实时处理能力。
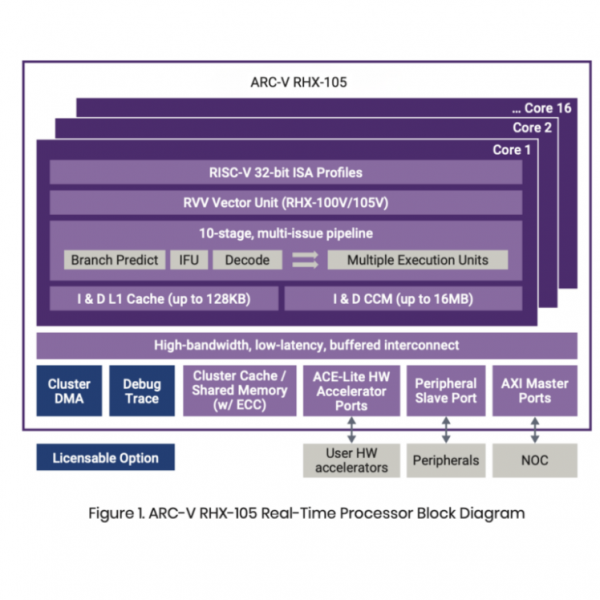
ARC-V RHX-105 实时处理器框图
截取自MIPS
响应问题,主要体现在存储器和I/O方面。以TCM(紧耦合存储器)为例,控制代码可以直接放入其中运行。与缓存不同,TCM的地址和访问周期固定,不涉及命中判断与替换,因此每次访问需要多少个周期都可以提前确定。
对于FOC 这样的实时控制任务,这意味着程序的执行时间可以被精确计算,最坏情况下,延迟也随之可以推算出来,延迟抖动更容易控制在允许范围内。这正是ARC系列用于电机控制场景时的核心价值。