在生成式AI开启新一轮科技周期后,GPU一直是算力舞台的主角,但当AI从回答问题走向自主规划和执行任务,一直站在GPU身后的CPU,正在被重新推到数据中心的中央。
不过,当下市场上还没有出现专为Agentic AI而生的CPU,我们在2026云栖大会听到的一个判断是:
2026年3月智能体加速爆发之后开始设计的CPU,未来或许可以成为真正的Agentic CPU,但目前已经上市的CPU,并不是专为Agentic AI而设计,更多只是在Agentic AI的某些环节上具有优势。
一颗数据中心处理器从定义、设计、验证到正式上市,通常需要数年时间,今天部署在数据中心里的CPU,在设计之初很难预见智能体在2026年呈现出的工作负载特征,只能借助既有的通用计算能力、内存体系和加速器承接需求。
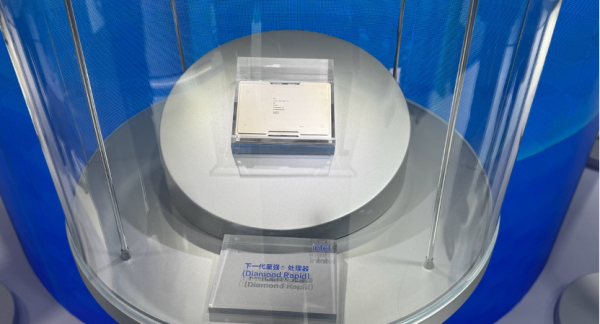
如今,英特尔试图跨过这条从“适配”到“原生设计”的分界线,这一代被寄予厚望的处理器,正是被命名为Diamond Rapids的英特尔下一代至强处理器。
那么,当智能体开始成为一种新的基础负载,英特尔将会打造一颗怎样的Agentic原生处理器?
01 智能体重新定义CPU
要理解Agentic原生处理器的重要意义,我们首先要知道,智能体对CPU带来了怎样的影响。
传统大模型推理的工作链路相对直接,用户提出问题,模型完成一次计算并生成答案,主要算力集中在模型的预填充和生成阶段,因此过去几年行业讨论AI基础设施时,焦点往往是GPU数量、显存容量和每秒能够生成多少Token。
然而,智能体的出现改变了这条工作链路。
一个智能体接到任务后,往往需要先理解意图、制订计划,再调用模型、执行工具、读取结果,并根据反馈决定下一步动作,复杂任务不会在一轮推理后结束,而是会形成不断循环的工作流,在一些P90或P99的复杂任务中,Agent Loop可能会达到数十次甚至上百次。
在每一次循环中,大模型主要负责思考,CPU则要把思考结果转化为现实动作,包括调用API、运行代码、访问网页、操作数据库、读取文件、启动沙箱以及处理不同Agent之间的通信,CPU处理稍慢一步,就可能转化为GPU的等待时间。
英特尔技术专家李尔成在2026云栖大会上就指出:“进入智能体时代之后,CPU既是主办方也是调度者,需要支撑整个流程的统筹、规划和执行。”
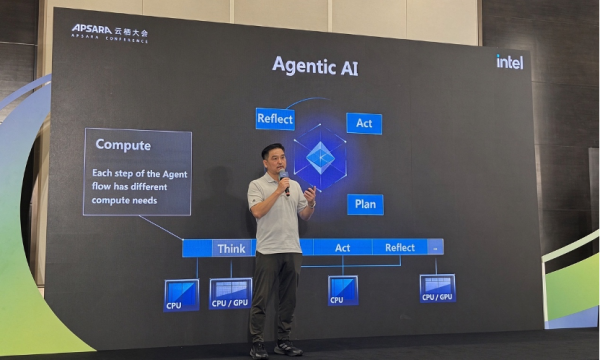
这也是CPU在Agentic AI时代重新受到重视的原因。
实际上,在大模型训练时代,数据中心CPU和GPU的算力配置接近1:4,而随着智能体推理兴起,这一比例正在向1:1演进,如今的CPU已经成为智能体工作流的编排者、控制器和执行者。
这样的变化,也为CPU带来了四类新需求:
第一,更复杂的通用计算。
智能体不仅要调用模型,还要执行大量分支、调度、工具调用和事务处理,核心数和频率仍然重要,但更重要的是单核性能、每周期指令数,以及面对大量状态切换时的执行效率。
第二,更大的内存需求。
智能体需要保存上下文、长期记忆、执行状态、知识库和运行轨迹,还会产生KV Cache、向量数据和大量临时文件,Agent部署密度越高,对内存容量、缓存和带宽的压力就越大,如今限制一台服务器能够承载多少Agent的,已经不是算力,而是内存。
第三,更高效I/O与数据搬运效率。
智能体需要频繁访问GPU、网络、数据库和存储,在多GPU服务器里,CPU与GPU之间、两颗CPU之间的通信带宽都会影响端到端效率,仅仅提高计算峰值,却不能及时把数据送到计算单元,反而会造成更多空转。
第四,成本与安全问题。
企业不仅关心Agent能不能完成任务,还关心完成一次任务需要多少时间、多少Token和多少基础设施成本。与此同时,Agent往往拥有浏览器、数据库和代码执行权限,需要沙箱、虚拟化、可信执行环境以及更完善的安全治理能力。
因此,Agentic AI时代衡量一颗CPU,不能只数核心或者比较主频,而要看它在既定P99时延目标下能够承载多少智能体,以及单位时间内究竟能够完成多少真实任务。
02 为了适配AI应用,英特尔至强做了哪些工作?
面对已经出现的智能体需求,英特尔并非从零开始。
在英特尔至强处理器过往产品中,英特尔已经在CPU中部署了多种专用加速能力,例如,AMX可以承担Embedding、小模型推理以及部分多模态数据预处理,QAT、IAA、DSA可以处理压缩、解压缩、数据搬运、沙箱加载与快照恢复,TDX及虚拟化技术则能为Agent提供隔离的运行环境。
英特尔技术专家胡勇在2026云栖大会上就特别指出:“我们现有的至强处理器,尽管在两三年前设计的时不是一个Agentic原生的产品,但英特尔正在利用已有技术解决智能体应用中的关键问题。”
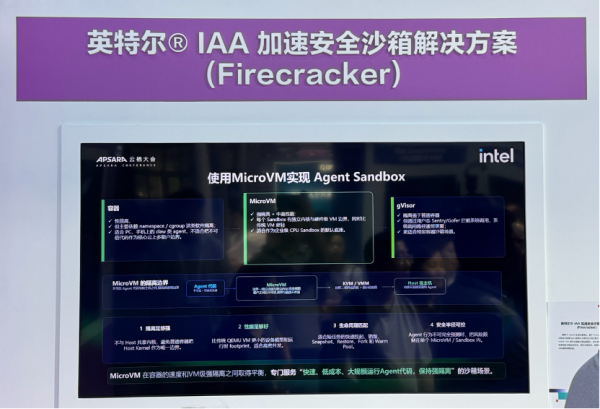
以Agent沙箱为例,一个智能体在执行代码或操作网页时,通常需要一个独立的运行环境,当平台需要在短时间内启动数万乃至更多沙箱时,启动时延、内存占用和并发密度会迅速成为瓶颈,英特尔与合作伙伴尝试利用IAA进行内存压缩,把压缩和解压缩工作从CPU核心卸载到专用硬件,在尽量降低业务干扰的同时,提高同一台服务器上的Agent部署密度。
AMX则可以把部分工作留在CPU本地完成,视频、语音和文本数据不一定要全部传给远端大模型,一些预处理、Embedding或者小模型任务可以在本地执行,其意义不只是降低延迟,也在于减少远端模型调用和Token消耗。
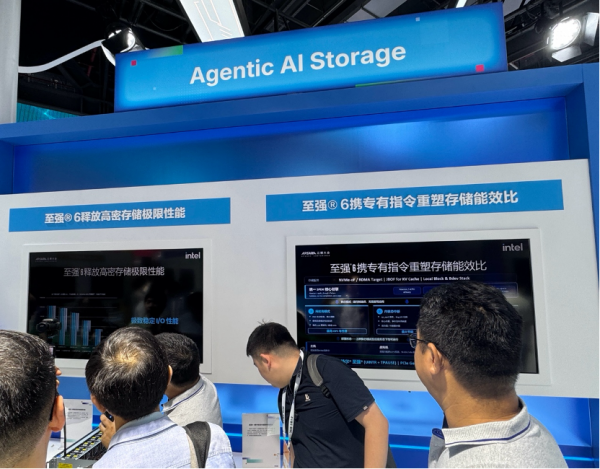
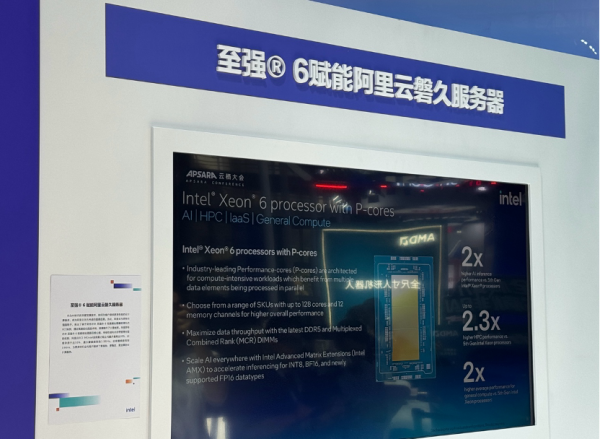
在阿里云九代实例中,英特尔至强6处理器已经被用于浏览器Agent、数据处理、RAG、沙箱和工具调用等场景。
阿里云基础设施事业部弹性计算高级产品专家武双涛在大会上指出,阿里云基于英特尔至强6处理器,以g9i、u2i及i5/i5e等实例分别承接重负载Agent、浏览器高并发、工具调用、数据处理和数据库等场景,并利用AMX、TDX、QAT、IAA及千万核弹性资源池,增强了推理、隔离、浏览器并发、沙箱恢复和峰值承载能力。
尽管英特尔通过已有技术,已经解决了一些Agentic AI需求,但Agent负载通常包含大量短任务、分支跳转和频繁状态切换,对CPU前端、缓存有效性、指令预测和调度非常敏感,高密度Agent又会迅速吃掉内存容量。
在这一情况下,简单增加核心或频率未必能线性提高输出,软件团队需要不断通过调度、压缩、卸载和资源池化弥补底层限制,如何在芯片定义阶段将Agent工作流转化为可衡量的微架构指标,就成了英特尔芯片设计团队需要着重考虑的问题。
实际上,在过去一段时间,英特尔与阿里云等客户所做的工作,除了优化现有产品,也是在收集真实生产环境里的Agent负载特征,例如,哪些环节对CPU前端更敏感,哪些任务受到内存容量制约,什么情况下GPU会等待CPU,以及如何在P99时延目标下部署更多Agent。
这些反馈,被英特尔用到了下一代至强处理器产品设计中。
03 Agentic原生处理器,原生在哪里?
英特尔下一代至强处理器,代号为Diamond Rapids,据悉,这代处理器最高配置256个新核心、1.28GB末级缓存、16个内存通道和128条PCIe 6.0通道。
不过,英特尔技术专家龚海峰指出:“在智能体场景下评判一颗CPU,不能只是数它有多少核心,或者看它运行在多高的频率,而要看它能够承载多少个智能体,以及每个智能体能多快完成任务,也就是要看实际输出。”
Diamond Rapids最大的变化,也不是简单地把核心数提高到了256个,而是围绕计算、缓存、内存、I/O和硬件卸载重新组织了整颗CPU,我们将这代产品中的变化总结为以下五点:
第一个变化是在计算核心与指令效率。
智能体中的大量工作并非矩阵计算,而是编排、分支、控制、工具调用和数据处理,Diamond Rapids采用新的CPU核心,并对流水线、指令和数据预取、分支预测进行优化,目的正是提高IPC,减少核心等待。
这其中值得一提的是APX,英特尔对沿用多年的x86通用整数指令集进行了扩展,把通用寄存器数量由16个增加到32个,并引入了NDD(New Data Destination)等机制,传统双操作数指令执行后,可能覆盖原有数据,程序需要提前复制或保存,NDD允许把结果写入新的目标寄存器,减少不必要的数据复制、内存访问和分支开销。
英特尔技术专家龚海峰以SPEC CPU 2017为例指出,SPEC CPU 2017在使用了支持APX的编译器重新编译后,代码中的Load/Store数量减少了40%。
第二个变化是在缓存。
智能体在运行过程中会频繁访问上下文、状态和工具运行数据,如果更多工作集能够停留在缓存中,就能减少对内存的反复访问,降低CPU等待时间。
Diamond Rapids最高配备1.28GB末级缓存,至强处理器由此进入到了GB级缓存时代,其计算核心位于上层,缓存位于底层,并通过Foveros Direct 3D等技术连接,相比把核心和缓存全部平铺在同一层,这种设计可以在扩大缓存容量的同时,缩短部分访问路径。
第三个变化是在内存体系。
Diamond Rapids提供16个内存通道,最高支持12800MT/s的MRDIMM,理论内存带宽约为1.6TB/s,对于需要部署大量Agent实例、保存上下文和处理KV Cache的系统来说,内存容量与带宽往往比单纯增加频率更关键。
为此,英特尔还引入了新的Fan-out Fabric架构,整颗处理器围绕Fabric Hub布置了多个计算模块,各个计算模块通过较为均衡的路径访问内存和I/O资源,从而降低芯粒位置差异带来的影响,也减少了软件针对复杂NUMA结构进行适配的压力。
第四个变化是在I/O。
Diamond Rapids提供128条PCIe 6.0通道,并支持CXL 3.0,在常见的一机八卡服务器中,CPU不仅要连接GPU,还需要处理跨插槽通信,如果两颗CPU之间的带宽不足,GPU进行集合通信时就可能出现瓶颈,更多、更灵活的高速通道,正是为多GPU、多存储和大规模数据搬运准备。
第五个变化是在加速器与系统调度。
英特尔此次增强后的AMX支持FP8、FP16和BF16,可以用于部分AI推理,QAT、IAA和DSA继续承担压缩、数据搬运、KV Cache处理以及Agent沙箱的加载与快照,配合更丰富的性能遥测,系统可以根据资源余量分配Agent任务,而不是等某些核心、内存通道或I/O资源出现热点后再被动处理。
正式基于这五个变化,英特尔面向数据中心打造的新一代至强处理器Diamond Rapids让整套架构围绕智能体的实际输出进行了系统性的优化,由此得以在时延约束下承载更多Agent,用更少指令完成工具执行,让数据更快到达计算单元,并把适合的任务卸载到专用加速器。
不过,英特尔打造的Diamond Rapids这代Agentic原生处理器,目前仍还未正式上市,预计要到2027年才会正式进入市场,产生实际效用。