

2025-06-10
Kinetics:从全新视角重新思考大语言模型测试阶段的资源分配,卡内基梅隆大学研究表明稀疏注意力机制至关重要
卡内基梅隆大学研究团队提出全新"Kinetics"缩放定律,揭示大语言模型测试阶段的资源分配策略需要重新思考。研究发现小型模型效率被严重高估,因为以往研究忽略了内存访问成本这一关键瓶颈。在测试阶段,注意力机制而非参数数量...

卡内基梅隆大学研究团队提出全新"Kinetics"缩放定律,揭示大语言模型测试阶段的资源分配策略需要重新思考。研究发现小型模型效率被严重高估,因为以往研究忽略了内存访问成本这一关键瓶颈。在测试阶段,注意力机制而非参数数量...

这项研究由加州大学伯克利分校团队完成,通过创建"Search Arena"平台收集了24,000多次用户与搜索增强型大语言模型的真实交互数据。研究发现用户提问远不止简单事实查询,他们更看重引用丰富的回答,即使引用与内容无...

这项来自加州大学戴维斯分校和俄亥俄州立大学的研究探讨了多模态AI训练的一个重要问题:让AI同时学会处理文字、图像、视频等多种信息类型时,是否会影响其原有的语言能力?研究发现,扩展模态确实存在能力权衡,模型合并技术比全模态...

众所周知,苹果的全球开发者大会WWDC的主题演讲,是提前录制好的视频。无论你是现场参会(由于报名人数众多,要通过抽奖系统才能获得门票),还是线上观看,其实都是在看视频,区别只在于在哪里看。当然,除了主题演讲,WWDC还有...

中科院团队提出Prefix Grouper方法,巧妙解决GRPO训练中的重复计算问题。通过将自注意力分解为前缀和后缀两部分,实现共享前缀的高效计算,在长文本场景下可将计算量降至原来的1/G。该方法保持与传统GRPO完全一...

这项研究由IIIT海德拉巴的Ananth Muppidi、IIT哈拉格普尔的Abhilash Nandy与Adobe研究院的Sambaran Bandyopadhyay共同完成,提出了一种名为ID-SPAM的创新方法,用...
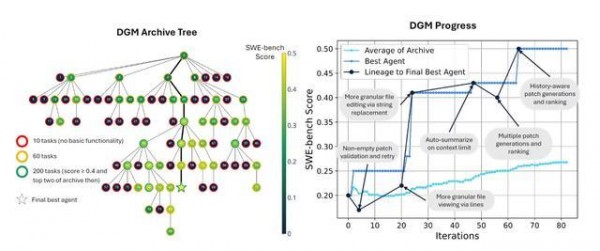
当AI学会自我进化:一台能不断重写自身代码的"达尔文哥德尔机器"正在实验室诞生,它像有创造力的厨师,不仅按食谱做菜,还能发明新菜谱并改进烹饪技术——这项突破让AI首次实现真正的自主进化,编程成功率从20%跃升至50%。

HASHIRU是一个创新的多智能体系统,由加州大学戴维斯研究团队开发,采用"CEO-员工"层级结构,动态管理AI智能体团队。系统优先使用小型本地语言模型,仅在必要时调用更强大的外部API,通过经济模型控制资源分配,并能自...

北航团队开发的FEAT是一种全新的医疗视频生成方法,通过三大创新解决了现有技术的关键问题:引入全维度依赖关系建模同时处理空间、时间和通道信息;采用线性复杂度的注意力机制大幅提高计算效率;设计残差值引导模块提供精细的像素级...

这项研究首次通过规模法则全面比较了CLIP和MaMMUT两种视觉-语言模型,发现虽然小规模计算下CLIP表现更优,但随着计算资源增加,MaMMUT展现更强的扩展能力。研究在多种下游任务和不同开放数据集上验证了结果一致性,...

MARBLE是一项由牛津大学、MIT和Stability AI联合开发的创新技术,通过操控CLIP空间中的材质表征,实现了图像中物体材质的精确编辑。它不仅支持基于示例的材质转移,还能实现材质混合和参数化控制,如调整物体的...

加州大学研究团队开发的DOVE系统彻底革新了AI图像处理方式,不再用固定长度表示所有图像,而是根据图像复杂度智能调整表示长度。就像人类描述简单白墙只需几句话,而描述繁忙街景需要更多细节一样,DOVE为简单图像分配更少的"...

这项研究介绍了FlowDirector,一种无需训练的视频编辑新框架,由西湖大学AGI实验室开发。不同于传统方法,该技术避开了易导致时间不一致和结构失真的反转过程,而是直接在数据空间中进行编辑。通过常微分方程引导视频沿着...

SViMo是清华大学与南方科技大学等机构联合开发的创新系统,通过同步扩散模型实现手物交互视频与3D动作的协同生成。不同于传统方法分别处理视觉效果或物理动作,SViMo整合视觉先验和动态约束于统一框架中,采用三模态自适应调...

这项新泽西理工学院与麻省理工学院合作的研究揭示了语言模型水印技术会降低模型对齐性的隐患。研究者发现水印导致两种行为异常:模型要么变得过于顺从而忽视安全限制(防护减弱),要么变得过度谨慎而拒绝合理请求(防护增强)。针对这一...
这项研究探索了自监督语音模型对荷兰语特征的理解能力,由阿姆斯特丹、蒂尔堡和奈梅亨拉德堡大学研究团队完成。研究者开发了荷兰语专用的Wav2Vec2模型,并将其与英语和多语言模型进行对比。结果表明,荷兰语特定预训练显著提升了...
SeedVR2是南洋理工大学与字节跳动团队共同研发的一步视频修复模型,通过扩散对抗式后训练实现高效视频增强。该模型突破了传统扩散模型需要多步采样的限制,引入自适应窗口注意力机制和特征匹配损失,成功在单步内实现高质量视频修...
斯坦福大学和上海交大等机构的研究团队提出了一种为视频世界模型增加长期记忆能力的创新方法。受人类记忆机制启发,他们设计了三种互补的记忆系统:短期工作记忆、基于点云的长期空间记忆和稀疏情节记忆。这种组合允许AI在生成长视频时...

浙江大学和吉利汽车研究院联合团队提出的FreeTimeGS是一种创新的动态3D场景重建方法。不同于传统方法,它允许高斯基元在任意时空位置自由出现,并赋予每个基元运动功能,使其能够随时间移动到相邻区域。研究通过4D正则化策...