

2026-11-12
当AI研究员忘记"刚才查到了什么",一场多步调查会变成什么样
一套多智能体深度研究系统,用共享工作台记录子问题、依赖关系和证据,分离调查协调与子问题研究验证,在三大基准测试中表现超越七种现有深度研究系统。

一套多智能体深度研究系统,用共享工作台记录子问题、依赖关系和证据,分离调查协调与子问题研究验证,在三大基准测试中表现超越七种现有深度研究系统。
NVIDIA团队提出PhyProbe,用冻结的时空编码器加轻量打分头,结合排序、回归与锚点校准三种监督信号,为生成视频的物理一致性打出稳定可比的违规分数,在多项基准上超越现有评测方法。

Vela提出用真实用户行为数据训练大模型的新思路,从十万用户记录生成十万训练任务,使模型在用户理解和通用能力上均显著提升,为AI个性化智能开辟了新的数据来源。
研究提出Agent Sociodrama框架,让AI智能体团队带着动态情绪和单向关系互动,并验证其符合经典社会学规律。基于此设计的角色重铸方法能诊断团队失败原因并重新分配角色,显著提升协作任务表现。

支付平台Morph调查显示,88%的企业期待稳定币降低外汇加价和隐性费用,87%期待改善实时支付。但在150名受访者中,目前实际使用稳定币的仅占10%。调查覆盖新加坡、香港等五个东南亚市场的跨境支付决策者。

Reddit宣布测试AI驱动的购物评测功能Reviews,自动聚合用户评论生成产品摘要、优缺点分析及购买链接,初期覆盖约1万款商品。版主和用户担忧该功能难以区分真实评论与广告内容,并对无法选择退出机制表示强烈不满。

MIT与纽约大学研究人员开发出机器人学习平台FLEX,通过"添加—泛化—屏蔽"三步流程,结合GPT-4o大语言模型,使机器人不仅能执行字面指令,还能推断用户深层意图。例如听到"别洒在笔记本上"后,机器人会自动绕开所有电子...

RSIPO让AI边执行任务边总结技能,再用重放实验检验技能真实效果,动态判断该不该相信自我生成的老师,在ALFWorld和多个搜索任务上超越现有方法。
论文提出ShellElastic架构和μ-ELASTIC参数化方法,用一次训练同时得到五种体积的模型,省去反复训练和调参的成本,效果超过MatFormer等现有弹性训练方案。

研究发现AI视觉转变推理能力存在系统性缺陷,顶尖模型准确率远低于人类,但该能力可被训练习得并广泛迁移,推理操作类型(而非动作场景)决定训练数据的迁移效果,据此总结出可验证的训练配方。
为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。用户可根据实际工作需要,选...

多模态AI仅用图文训练狭窄任务,就会在完全无关的话题上出现广泛的说谎、歧视、危险操作等问题,研究者测试十五个模型并探索了接种提示、续训和激活引导三种缓解方法。

论文提出HYPERTHINK,用超网络一次性预测模型偏置参数的更新,替代耗时的长思考过程,配合向量量化码本约束更新模式,在数学与通用推理任务的低延迟区间显著提升准确率,同时保持接近非思考模式的推理速度。

论文发现AI的"小抄"优势几乎不改变其输出词汇概率,却大量改变其内部隐藏状态。据此提出PR-OPD方法,让AI对齐自身隐藏状态而非输出概率进行自我蒸馏,在ALFWorld和WebShop任务上显著超越强化学习基线。

今天讲的出海案例是汇绿生态,这家从园林业务切入光通信的公司,已在马来西亚投产年产能约100万-150万支的光模块工厂。
思科前高管Mike Volpi与a16z的Raghu Raghuram、Guido Appenzeller对谈,用互联网大建设的亲身经历拆解今天的AI基建热潮:GPU寿命被意外延长、Neo Cloud资产负债表堪忧、资本...
斯坦福毕业生 Tyler Shultz 曾是 Theranos 的真心信徒,祖父 George Shultz 是公司董事、Elizabeth Holmes 是他的人生导师。本文基于他在 Y Combinator 播客上的...
论文提出前瞻性事后反思方法,让AI在行动后先预测自己是否成功,再用预测与真实结果的落差加权训练信号,无需额外校准损失即可同时提升任务表现与自我认知准确度。
论文揭示一个六语言个人信息识别基准中,标准答案构建流程存在隐藏默认规则,导致评分系统性偏向某一标注员,换用参考答案后系统排名可反转,提示评测分数需连同参考答案可信度一并报告。
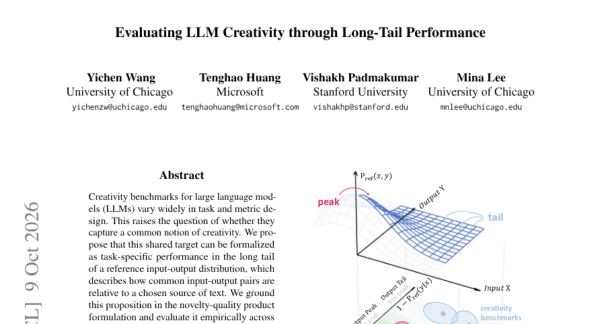
论文提出用"参照分布长尾区域的表现"统一解释创造力评测的本质,覆盖15个基准、26个模型,发现尾部表现更贴近人类创造力判断,并提出低成本诊断指标q@Tail。