

2026-10-28
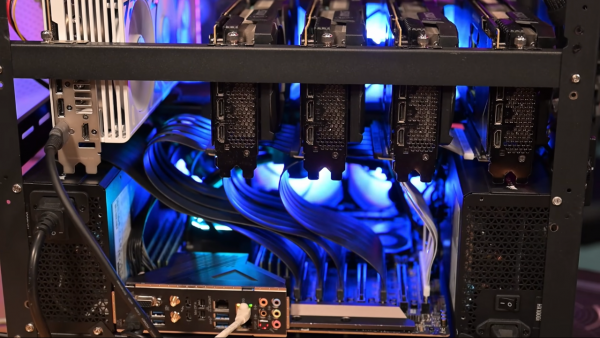
摩尔线程开源大模型训练基础设施 Megatron-MUSA-Titan,贯通万亿参数 MoE 预训练与强化学习
摩尔线程开源大模型训练基础设施 Megatron-MUSA-Titan,基于全功能 GPU,覆盖万卡级集群万亿参数 MoE 模型的预训练与强化学习,含 blockwise FP8、MoE 通信优化、激活卸载与流水线通算重...
2026-10-28
把一段视频倒着放,AI却读不出区别:这个bug藏在模型的哪一层?
视频AI分不清视频是正放还是倒放?研究者发现时序信息在模型中间层产生后逐层衰减,提出无需训练的TAI方法,在峰值层提取信号按衰减曲线回注,显著提升三款主流视频大模型的时序推理能力。
2026-10-28
E-MoE:当扩散语言模型学会"抽牌"而不是"独立猜测"
E-MoE提出用混合专家模型自带的路由决策作为离散隐变量,替代扩散语言模型中各位置独立采样导致的分解误差,无需额外参数即可大幅提升少步数生成质量,在LM1B等数据集上验证有效。
2026-10-28
语言和图像,一个像说书人,一个像摄影师
本文介绍Multimodal Flow框架及其实例化模型MF-1,一种用流匹配统一建模语言与视觉的全连续生成方法。通过文本图像超块设计、块因果注意力与模态专属前馈网络,MF-1在仅用150B训练词元的情况下,于GenEv...
2026-10-28
HPE 整合业界领先的有线、无线及 SASE 方案的可视化能力,优化从边缘到云端的用户与应用体验
HPE 将 Networking EdgeConnect 与 HPE Mist、HPE Aruba Central 集成,在统一智能体框架下融合 SASE、有线接入与无线局域网,实现端到端网络可视化。


2026-10-28
“我没想到有生之年能看到准黎曼猜想的证明”
10 月 6 日晚间,罗格斯大学数论学家 Alex Kontorovich 在纽约国家数学博物馆的晚宴上,一手端着威士忌一手刷手机。OpenAI 刚刚在 GitHub 上放出 722 篇 AI 生成的数学论文。他翻到"准...
2026-10-28
机器人学会一个新动作,到底需要多少次摔倒?
这篇论文提出InterEvolve,让人形机器人无需重新训练,通过大模型演化奖励程序并结合执行反馈,复用已有运动能力完成全新接触密集型任务,成功率大幅超越人工设计奖励,并在真实机器人上实现自主部署。
2026-10-28
AI世界模型如何记住几分钟前走过的路
论文提出Memorizon训练方法,让视频世界模型的训练跨度和注意力计算长度解耦,通过按相机共视性检索历史片段组成有界记忆库,使模型能在超出训练窗口的时间跨度上保持场景重访一致性,同时控制训练成本。
2026-10-28
机器人会"健忘症",这事比你想象的更麻烦
机器人常常记不住"自己做过什么",这篇论文设计了HIDE基准专测这种健忘症,并提出SEEK三合一记忆框架,在仿真和真实机械臂实验中显著提升了需要历史信息才能完成的操作任务成功率。
2026-10-28
润泽科技加快印尼巴淡岛与香港数据中心建设,首批60MW进入收尾
今天讲的出海案例是润泽科技,这家数据中心建设运营商正加快印度尼西亚巴淡岛和中国香港园区建设,两地合计规划规模约600MW。

2026-10-28
比铁路、公路和曼哈顿计划加起来还大的工程,正在被一块钢板卡住
AI数据中心建设正超越GPU与电力成为焦点,变压器、开关柜、液冷设备及特种钢材等隐藏环节正成为新的供应瓶颈,也为创业者打开了被忽视的机会窗口。
2026-10-28
AI做数据视频,为什么总是"人不人鬼不鬼":DataMagic怎么把混乱变成了可控
DataMagic用声明式规范DVSpec和"先生成后编排"的多智能体策略,解决了AI自动生成数据视频时音画不同步、叙事混乱的难题,质量较直接生成大模型提升83%。
2026-10-28
更小的模型,更好的"反例":一个颠覆直觉的发现
研究发现用更小、更弱的冻结模型生成的错误答案训练大模型,效果反超用模型自身错误训练,且计算成本大幅降低,挑战了偏好蒸馏中"反例须同尺寸生成"的传统假设。
2026-10-28
当你让AI帮你扫描一台靶机的端口,然后用Metasploit打一个漏洞,你有没有想过:它敲出来的那串命令,到底对不对?
KaliBench是首个针对Kali Linux命令行工具调用的细粒度基准,含8504条查询命令对,覆盖1642个工具。研究发现开源模型完全匹配准确率不超42%,参数构造是主要瓶颈,并通过可验证奖励训练让8B小模型逼近6...
2026-10-28
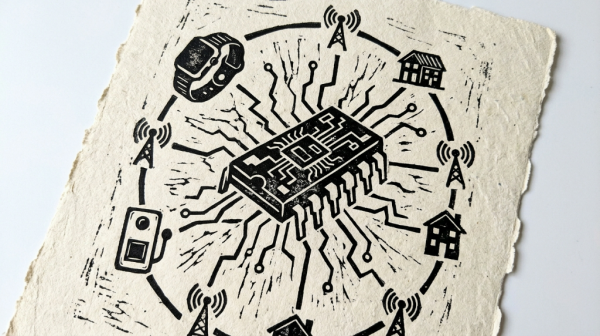
BrainChip发布AKD1500 SPI芯片,神经形态AI走进日常边缘设备
BrainChip发布AKD1500 SPI协处理器,通过MCU已有的SPI接口为可穿戴设备、智能家居等边缘产品带来Akida神经形态AI能力,支持本地学习,无需替换现有主控芯片,现已通过BrainChip Shop及D...

2026-10-28
NVIDIA Cosmos开放新工具 助力世界模型训练评估与部署
NVIDIA扩展Cosmos平台,新增数据工厂蓝图、训练优化工具及仿真检查点,支持自动驾驶、机器人等物理AI场景。Cosmos 3 NIM微服务推理速度提升最高2倍,新增模型可适配GR00T、QWEN等多种开源架构。