

品牌一致性背后的运营挑战,Monotype(蒙纳字库)最新研究带来哪些发现?
The Adecco Group 全球研究:员工参与工作方式重塑,AI 创造更大价值
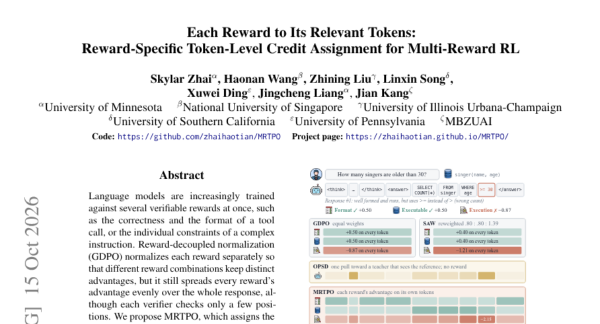
每个奖励管好自己的那几个词:多奖励强化学习的token级信用分配
多奖励强化学习训练大模型时,奖励信号常被平摊到整条回答。MRTPO通过自我回放比较有无验证信息时的预测差异,找出每个奖励真正相关的token,精准分配优势值,在文本转SQL、指令遵循、工具调用任务上均超越现有方法且收敛更...
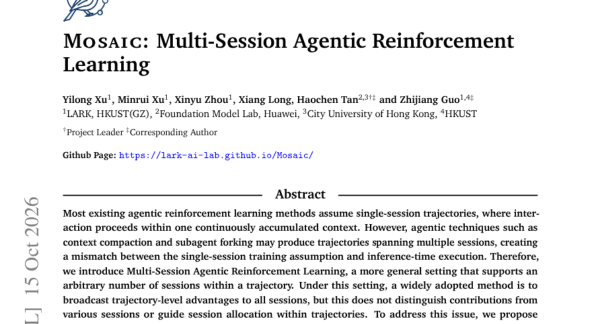
当AI智能体的记忆被拦腰截断,训练该怎么跟上?
本文解读Mosaic多会话强化学习方法,解决AI智能体在上下文压缩与子智能体分身场景下训练信号粗糙的问题,通过分层打分机制提升任务准确率并减少冗余会话。
AI会自己改造自己的"外挂装备",这事靠谱吗?
论文系统梳理了AI harness(外部装备,涵盖提示词、记忆、工具、代码)自我进化机制,提出完整分类框架和理论保障(泛化界、遗忘上限、准入规则),并结合个人助手、企业自动化、科研、机器人、公共服务五大场景分析风险与应对...
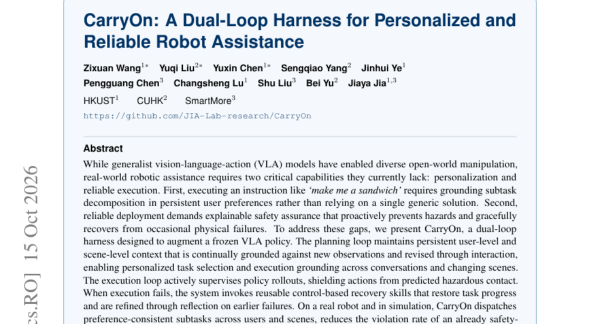
机器人端上菜,它怎么知道该不该把肉端给一个吃素的人
CarryOn是一套套在冻结VLA模型外的双循环系统,通过持久化用户与场景记忆实现个性化任务规划,并用主动防护盾与反思式恢复技能提升物理执行的安全性与可靠性,真实机器人实验显示违规率从52.6%降至6.1%,恢复成功率从...
AI代理公司不设CEO,让它们自己竞标谁来当家做主
哈佛团队提出MPT框架,让AI智能体通过竞标自主决定行动顺序并分配学习信号,在造物、导航、深度研究任务上显著超越固定分工的传统多智能体训练方法。
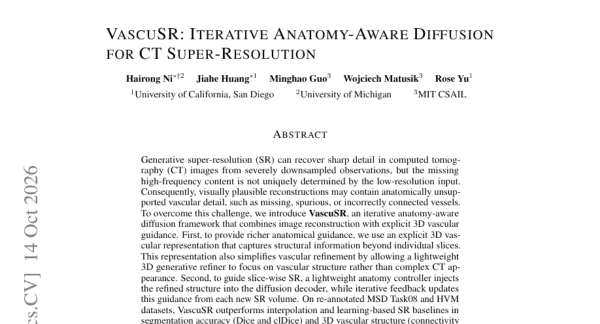
CT血管图像放大后,医生发现血管断了:一个AI的自我修正实验
研究团队提出VascuSR框架,用三维血管结构修正配合扩散模型逐轮迭代反馈,解决CT超分辨率中血管细节可能失真断裂的问题,在肝血管和冠状动脉数据集上均优于现有方法。
AI转得动T恤的轮廓,却转不懂T恤的样子
厦门大学团队提出RoTA-Bench基准,通过让AI旋转3D物体对齐目标投影来测试空间推理能力,发现最强模型成功率仅17%,远低于人类100%,揭示AI在3D空间理解上的根本短板。
强模型不用每步都亲自动手,当个审稿人就够了
论文提出SpecAgent,让强模型从亲自执行每一步,转变为审核弱模型起草的操作,仅在不可逆的写操作前介入,用语义验证替代精确匹配,大幅降低显存流量和耗时,同时保持接近强模型的任务质量。
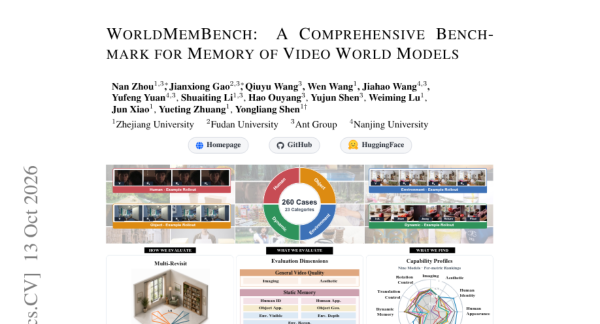
WorldMemBench:当AI视频模型"走出去又走回来",它还记得原来的世界吗
WorldMemBench是评测AI视频世界模型记忆能力的基准,通过让镜头走出去再回来的受控轨迹,检验模型能否保住已见的人、物体与场景,以及离屏期间事件是否继续演化。研究评测九个模型,发现静态记忆强不代表动态演化可靠,多...
海信以智能洗护让日常洗衣更省心
EVA-Cap:当AI给视频配音配字幕时,它到底有没有看懂谁在说话
EVA-Cap提出事件中心对齐框架,将视频描述拆解为音视频事件单元,通过SFT与GRPO两阶段训练结合三类事件奖励,显著提升音视频描述的事件完整性、角色归因与时间同步准确性。
当四个专家模型同时被塞进同一个大脑,会发生什么
东北大学与阿里巴巴团队提出SCOPED框架,通过独立训练视觉语言模型专家并提炼可复用技能指导蒸馏,解决多能力联合训练中的梯度冲突问题,在八项多模态测试中显著超越基线与更大规模模型。
网页浏览智能体训练难题:当AI学会给自己打分
论文提出CLIFT方法,让网页智能体通过保形认证的自我验证问题库获得密集训练奖励,并在测试时无需外部裁判即可做轨迹选择,在三个基准上均取得领先效果。
RWS 集团首席执行官本杰明·法斯出席深圳 APEC 会议:探讨中国 AI 市场机遇与全球化服务
近日,全球 AI 解决方案公司 RWS 集团首席执行官本杰明·法斯(Benjamin Faes)出席亚太经合组织(APEC)工商领导人峰会,并接受了中央广播电视总台记者的专访。围绕中国市场的巨大增长潜力以及 RWS 在华...
145B 的模型,一张 24G 显卡就够了?
一张5090五万,一台128G统一内存小主机也要四五万。上周开源的Edge0-145B号称29GB就能跑,我们翻了它的文档,实际要54G。水分不小,但这条路依然值得认真看