


来自普林斯顿大学的研究团队于2026年3月发布论文《OpenClaw-RL: Train Any Agent Simply by Talking》,提出了一个名为OpenClaw-RL的强化学习框架。论文上线一周,GitHub收获超过3000 star,引发了AI工程圈不小的讨论。
这篇论文的出发点听起来几乎像是在批评整个行业的浪费:每一个部署中的AI智能体,每时每刻都在收集让自己变得更好的数据,然后把它丢掉。用户说"你应该先检查文件再编辑",终端报了一个错误,测试跑通了——这些反馈信号本质上都是对刚才那个动作的评估,甚至包含了"应该怎么做"的具体指向,但现有的AI系统清一色地把它们当作下一轮对话的上下文,然后继续前进,不留痕迹。
这不是小问题。当前主流的大模型强化学习体系——无论是RLHF、GRPO还是DeepSeek-R1的路线——都依赖预先收集好的数据集进行批量离线训练,部署和训练是两个分开的阶段。OpenClaw-RL想做的是彻底打破这条线:让模型一边在用,一边在学。
被扔掉的两种信号
论文把AI智能体在使用过程中产生的反馈信号分为两类,并把它们统称为"下一状态信号"(next-state signal)——也就是智能体做出某个动作之后,环境返回的那条信息。
第一类是评估信号。用户重新问了一遍同样的问题,说明上一次没答好;测试通过了,说明代码改对了;终端返回了报错,说明命令走偏了。这些信号天然地给前一个动作打了分,不需要任何额外标注,却被现有系统普遍忽略。
第二类是指令信号,这才是论文真正有意思的部分。用户说"你应该先检查文件再编辑"——这句话不只是告诉模型"你错了",它指明了错在哪里、正确的顺序应该是什么。详细的SWE错误报告(软件工程任务中的diff和编译诊断信息)也一样,往往隐含着具体的修改方向。
现有的强化学习方法处理不了第二类信号。RLVR体系用标量奖励值——一个数字——来压缩所有反馈信息,把"应该先检查文件"这样的方向性指导压缩成+1或-1,方向丢了,内容丢了,只剩一个好坏判断。
OpenClaw-RL针对这两类信号,分别设计了两套机制。
四个独立转的轮子
在介绍学习方法之前,需要先理解OpenClaw-RL的架构设计,因为它是后续一切的前提。
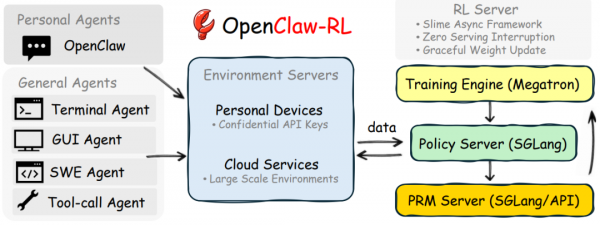
整个系统由四个完全解耦的异步模块组成:
- 策略服务器(SGLang):负责回答用户的实时请求
- 环境服务器:负责对接用户设备或云端Agent运行环境
- PRM评判服务器:负责对每一个动作打分
- 训练引擎(Megatron):负责用收集到的数据更新模型权重
这四个模块互不等待。模型在回答当前问题的时候,PRM在评判上一个问题的回答,训练引擎在消化更早之前的批次——三件事同时进行,谁也不卡谁。
这个设计的关键价值在于:它让"从实时交互中持续学习"在工程上变得可行。对个人智能体来说,用户的手机或电脑通过加密API连接到RL服务器,训练在后台静默进行,不影响正常使用。对通用智能体来说,数百个云端环境并行跑各自的任务,产生的数据源源不断地流入同一个训练循环。
两类用途,同一套基础设施。
"好不好":二值强化学习
处理评估信号的方案叫Binary RL,逻辑相对直接。
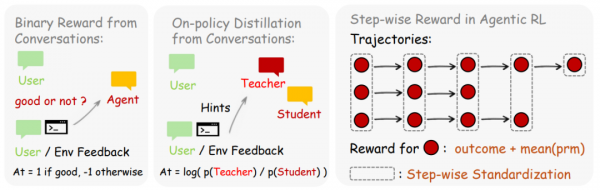
系统让一个PRM(过程奖励模型)读取智能体的动作和随后的下一状态,判断这个动作表现如何,输出+1(好)、-1(坏)或0(中性)。为了降低单次判断的随机性,系统并行运行多次独立查询,取多数投票的结果。
训练目标采用PPO风格的截断代理损失,加上KL散度约束防止策略走偏太远。这部分技术上没有太多新意,但关键在于它能处理所有类型的下一状态信号——无论是用户简短的回复、终端的退出码,还是测试套件的通过率,只要有下一状态,就能打分,就能训练。
覆盖面广是它的核心优势,代价是粗糙:对用户的每一个动作只给一个标量数字。
"怎么改":事后引导的在线蒸馏
处理指令信号的方案叫Hindsight-Guided On-Policy Distillation,简称OPD,是这篇论文技术上最有新意的部分。
它的核心洞察是:如果把用户的纠正意见提前放进提示词,同一个模型会生成截然不同的答案。这个"提前知道纠正意见的模型"实际上比"不知道的模型"更接近正确答案,它可以充当教师,而学生(原来的模型)只需要向它看齐。
整个流程分四步:
第一步,提取事后提示(Hindsight Hint)。 判断模型读取动作和下一状态,决定用户的反馈是否包含可操作的改进方向,如果是,提炼成1-3句具体的指令,放入[HINT_START]...[HINT_END]标记中。这里有一个重要设计选择:不直接用原始的用户回复做提示,因为用户说的话往往混杂着噪音(既纠正了上一个回答,又顺手提了新问题),判断模型的作用就是提炼出纯净的指令方向。
第二步,质量过滤。 从多次平行判断中选择最长、最具体的那个提示(超过10个字符),没有有效提示则丢弃这条样本。OPD主动牺牲覆盖率换取信号质量。
第三步,构建增强教师上下文。 把提取出的提示拼接到原始用户消息后面,生成s_enhanced——一个"如果用户一开始就告诉我该怎么做"的假设提示词。
第四步,计算逐词优势。 让模型在s_enhanced条件下对原始回答的每个词重新打分,再与原始条件下的打分相减,得到每个词的优势值。某个词在教师条件下概率更高,说明该词应该强化;反之应该抑制。这个逐词的方向性信号,信息量远超整条回答只对应一个+1或-1的标量。
这套机制有几个特别的地方:它不需要更强的外部教师模型,模型用自己当教师;它不需要预先准备配对的偏好数据,信号来自实时交互;它与RLHF、DPO从根本上不同,因为它给的是词级别的方向,而不是序列级别的好坏判断。
两套方法加起来比任何一套都强
论文设计了一个精巧的仿真实验来对比这两套方法:用大模型模拟两类真实用户——一个不想被发现在用AI写作业的学生,和一个希望批改意见具体友好的老师。
基准分数是0.17(满分1.0)。经过8步训练后:
-
单独用Binary RL:0.25 -
单独用OPD:0.25(数值相同,但原因不同——OPD样本稀疏,需要更多步才能发力) -
两者联合:直接跳到0.76
经过16步训练后:
-
Binary RL单独:0.23(略有波动) -
OPD单独:0.72(追上来了) -
联合方法:0.81
两种方法的组合不是简单相加,而是互补:Binary RL给所有轮次提供宽覆盖的梯度信号,OPD在能提取到方向性指令的那些轮次提供高精度的逐词修正。它们加权相加,共用同一个PPO损失函数,只是优势值的计算来源不同。
具体效果怎么看?学生场景里,训练前的回答满是粗体标记和模板化的分步格式,训练后变成了更自然的口语风格;老师场景里,批改意见从冷冰冰的"正确答案30"变成了带鼓励、带具体解释的几段话。仅凭36次学生互动、24次老师互动,效果就已经清晰可见。
过程奖励在长任务中不可或缺
对通用智能体(终端、GUI、SWE、工具调用)的实验则验证了另一个问题:过程奖励(Process Reward)和结果奖励(Outcome Reward)哪个更重要?
答案是两个都要,但过程奖励的作用在长任务中尤为突出。
原因不难理解:一个软件工程任务可能需要二十步操作,如果只有最后一步的测试结果才算奖励,那前十九步几乎没有训练信号。PRM在每一步动作之后立即根据下一状态打分,让整条轨迹都有梯度,而不是只有终点有灯。
数据上,工具调用任务中整合奖励vs只用结果奖励的对比是0.30对0.17,差距超过75%。GUI任务的对比是0.33对0.31,差距较小但依然稳定正向。代价是需要额外的算力来托管PRM服务器。
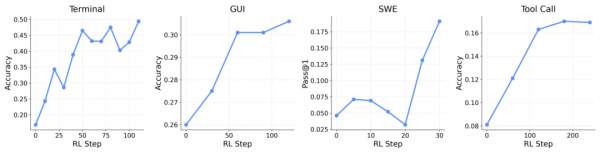
论文同时报告了框架在终端、GUI、SWE、工具调用四个场景下的学习曲线(分别使用128、64、64、32个并行环境),均呈现明显上升趋势,验证了同一套基础设施跨场景的通用性。
这件事的潜台词
这篇论文的意义,不只是提出了两个新的学习方法。
它真正挑战的是一个隐含假设:训练和部署必须分开。过去十年的大模型发展路线默认"先收集数据,再训练模型,再部署服务"——这条流水线在实验室里清晰,但在实际使用中意味着每次更新都需要暂停、回收、重训、重部署,成本高、周期长、个性化程度低。
OpenClaw-RL想做的是打通这条流水线,让使用本身成为训练。个人智能体在私人设备上运行,用户的每一次回复都在悄悄改善它对这个特定用户的理解,不需要把私人数据上传到任何地方,不需要任何手动标注。
这个方向还有很多未解决的问题——训练稳定性如何保障?不同领域的提示在分布偏移下如何表现?奖励黑客(reward hacking)的风险怎么控制?——但它至少清楚地指出了一件事:每一次对话都是一次被浪费的学习机会,现在有人开始认真把它捡回来了。
https://arxiv.org/pdf/2603.10165
Q&A
Q1:OpenClaw-RL和现有的RLHF、GRPO等方法有什么本质区别?
现有方法(RLHF、GRPO、DeepSeek-R1等)都依赖预先收集好的数据集进行离线批量训练,部署之后模型不再更新。OpenClaw-RL的核心区别在于它是在线的、实时的:模型在对用户提供服务的同时,就在从这些交互中学习,四个异步模块同步运行,互不阻塞,不需要停机重训。此外,OPD方法引入了词级别的方向性优势信号,这是现有标量奖励体系根本处理不了的。
Q2:Hindsight-Guided OPD的教师模型从哪里来,为什么不需要外部更强的模型?
OPD的教师和学生是同一个模型,区别只在输入不同。将从用户回复中提取的纠正提示拼接到原始提示词之后,模型在这个"事后知道答案"的增强上下文下重新对原始回答打分,这个打分就是教师信号。其背后的假设是:如果用户一开始就说清楚了"你应该先检查文件",同一个模型会在文件检查相关的词上分配更高的概率,这个概率差就是训练方向。这套机制不依赖外部教师,也不需要配对偏好数据,但代价是只在用户回复确实包含可提取的方向性指令时才有效,因此OPD的样本覆盖率低于Binary RL。
Q3:过程奖励和结果奖励为什么要结合使用,各自的局限性是什么?
结果奖励(只看最终任务是否完成)的问题是稀疏:对于需要二十步操作的长任务,前十九步没有训练信号,信用分配(credit assignment)极为困难。过程奖励(PRM对每步动作打分)解决了稀疏性,但引入了新的问题:PRM本身可能出错,尤其在中间步骤的判断上。论文的解决方案是将两者加权相加,既保留了结果奖励的客观性,又获得了过程奖励的密度。工具调用任务的实验显示,联合使用比单独使用结果奖励提升超过75%,代价是需要额外算力维护PRM服务。