


又是有日子没有发过小扎的东西了,这两天试了Muse之后,确实非常丝滑,于是把Meta Connect会后的播客整理了一下,讲的东西还真蛮多的,以至于我都不知道该用什么标题。
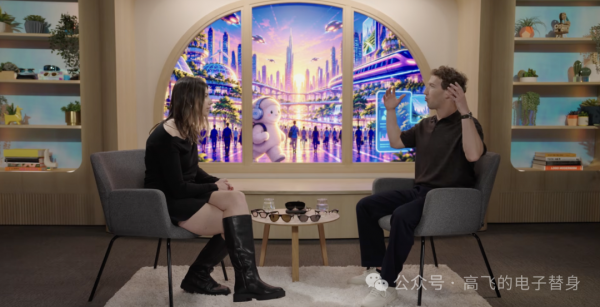
2026年9月25日,YouTube频道The Next Big Thing发布了一期与Meta创始人Mark Zuckerberg的对谈。主持人Jacklyn在片头提到,她为这期节目看完了扎克伯格做过的所有采访。这期对话录制于Meta Connect大会前夕,时长约50分钟,话题从Muse的产品设计一路延伸到全息影像、组织重构、AI对齐、生物医学,以及他作为一个builder的自我剖析。
这期播客落在一个密集的产品节点上。9月8日,Meta发布了个人AI智能体Muse,上线两周下载量突破250万(Sensor Tower数据)。9月23日的Connect大会上,扎克伯格宣布Muse将登陆全系列智能眼镜,推出Muse Charm随身设备、实时语音模式和全息影像通话功能。与此同时,Muse也面临质疑。TechCrunch的报道梳理了Meta从2011年FTC和解到2026年多州和解的隐私监管记录,追问一个拥有这种历史的公司是否能让用户把最敏感的信息交给它的AI智能体。
以下是这次对谈的完整拆解。
1. "这是一个数十亿人想要的东西"——Muse的产品起点
扎克伯格讲了一个细节:在Muse正式立项之前,他自己先在家用OpenClaw搭了一套个人智能体。OpenClaw是2026年爆火的开源AI智能体框架,典型用法是买一台Mac Mini,在本地跑一套24小时在线的AI助手。扎克伯格自己折腾了一阵,感受到了这种体验的魔力,然后拉上Nat Friedman和Alexandr Wang坐下来开了一个会。
三个人的判断很一致:如果能把这种体验交付给不懂技术的人,不用买硬件、不用开终端、不用调试崩溃,这会是一个数十亿人想要的产品。 从那个时刻起,团队开始调模型、搭智能体框架、设计安全架构。这个判断也决定了Muse的产品路径:它从第一天就不是为开发者做的,是为所有人做的。
扎克伯格说,Muse内部反馈一直不错,但产品发布时你永远不知道用户会怎么反应。大多数时候需要迭代几轮才能找到感觉。"But this one just really clicked right out of the gate." 两周内数百万人在用,他说这种事每隔几年才碰上一次。
2. 个人智能体和通用模型的分水岭:分寸感
扎克伯格在这期对话中反复回到一个判断:做个人智能体,聪明只是入场券,真正的壁垒是训练模型理解人际边界。
他举了一个具体场景。你让Muse帮你订餐厅,Muse知道你有食物过敏,或者你怀孕了。它要帮你找到合适的地方,但不能把这些信息透露给餐厅。这种能力他称之为discretion,分寸感。他说这是人人都有的基本社交常识,但如果你只是在做一个coding agent,完全不需要训练这个东西。
这里有一个产品哲学的分歧。过去一年行业的焦点一直在coding agent上,扎克伯格认为这类产品嵌入了两个想法:编程能力和智能体通用能力。Meta的策略是把重心放在"成为一个好的智能体"上,编程能力是辅助,因为即便用户不觉得自己在写代码,Muse在后台其实一直在写代码来完成各种任务。
他强调,这种分寸感不是在模型外面套一层prompt就能解决的。必须在模型训练阶段就写进去。 这也是为什么Meta坚持自己训练模型,而不是拿别人的模型来搭应用。
3. 全栈整合:为什么Meta不用别人的模型
"We're not just taking someone else's model off the shelf and trying to build a scaffold and an agent around it." 扎克伯格不是从别人那里拿一个现成模型,然后在外面搭个架子包成智能体。模型训练和产品构建在Meta是一件事。
他列举了Muse的几个产品细节来说明全栈整合带来的好处。Muse有一套"心跳机制":智能体会定期醒来,检查用户设定的目标,看有没有能主动推进的事情。加上记忆系统、实时动画头像、语音模式,这些功能每一个都需要模型层和产品层深度配合。
还有一个团队专门负责头像的实时动画效果。用户不只是用默认角色,可以创建任何自己想要的形象,角色会在对话中自然地做出表情和动作。扎克伯格说,这些细节加在一起,就是全栈公司才能做到的事情。
4. 给每个智能体一台自己的电脑
"An agent in order to be able to do stuff for you needs a place to store your information. And we don't think it should just be like in a pool with everyone else's information."
扎克伯格对Muse安全架构的解释从一个类比开始:OpenClaw的早期用户在家里放一台Mac Mini,智能体跑在自己的机器上,数据也存在自己的机器上。Meta要做的事情是把这种体验搬到云端:你注册一个账号,Meta就给你的智能体分配一台专属的虚拟机。相当于你桌子底下有一台只属于你的电脑,只不过它跑在Meta的机房里。
这套架构目前分两层。
第一层是Muse Secure VM,已经上线。 里面有一个叫Sentinel的安全智能体,专门监控进出虚拟机的数据流。扎克伯格把它描述为一个"constellation of systems":如果外部有人试图入侵或者注入恶意内容,Sentinel会直接切断;如果Muse要执行一个它认为用户应该知道的操作,Sentinel会拦截并弹回给用户确认权限。密码和支付信息存在独立的安全凭证库里,Muse本身看不到这些数据,它只是在用户授权的时候把凭证"插入"登录流程,整个过程中智能体不接触明文。
第二层是即将上线的Muse Confidential VM。 这一层由Moxie Marlinspike主导设计。他是Signal的联合创始人,十年前帮Meta把Signal Protocol集成进WhatsApp,实现了端到端加密。今年3月,Marlinspike宣布他的加密AI平台Confer将与Meta AI整合。Confidential VM的核心思路是给用户一把加密钥匙,Meta自己也无法访问虚拟机里的内容。
扎克伯格承认这一层实现难度大得多。"Obviously if Meta can't access what's within it, then it's a lot harder to debug." 但他认为这是必须做的。如果你要让人们把最私密的信息交给一个智能体,你必须提供和WhatsApp同等级别的安全保障。 这不只是心理层面的安慰。在某些国家,用户不信任政府,需要确保即便政府向Meta施压,Meta也拿不到数据,因为它根本没有钥匙。
主持人追问:这种安全承诺是真的有实际作用,还是更多是心理层面的?扎克伯格的回答很干脆:这是实际的。 他说目标是还原"你自己的电脑在你桌子底下"的那种安全感,没有任何公司能访问它。
5. 性格没有标准答案
行业里不少实验室花大力气调AI的"人格",扎克伯格觉得方向反了。他说自己从来就不觉得性格有标准答案。关键是让模型足够可调(steerable),让用户自己定义想要什么样的交互方式。 这也是他坚持开源和个性化路线的原因之一。
Muse注册时就会问用户想要什么样的基本人格,之后可以随时修改。用户可以自定义头像和声音。
他自己的Muse设定偏"工作向",直来直去。之前有一版是偏讽刺和幽默的风格,后来换了。角色形象是默认的Muse小人,但他给它穿了一件托加长袍,配了一个"extremely deep to the point of being humorous"的声音。
这个角色形象的诞生有个小故事。项目早期一位设计师画了第一版角色,后来团队一直想迭代改进,有人提议改成蓝色,理由是"it's got to be blue because it's Meta"。扎克伯格否掉了所有后续方案,觉得第一版就是最好的。"I think you nailed it on the first try."
他认为这种角色embodiment让产品有亲近感。很多人谈AI的时候把它当成一个超级可怕的东西,他觉得它应该是有用的、好玩的。给它一个可爱的形象,是在产品层面做这个定调。
6. Llama 4翻车和MSL重建:一次定义创业者的时刻
2025年4月,Meta发布了Llama 4系列模型。结果是一个"pretty big negative surprise"。
Llama系列此前的进展一直在加速:Llama 1开创了开源AI运动,Llama 2扩大了规模,Llama 3几乎达到前沿水平。但Llama 4掉出了应有的轨道。市场反响平平,LMArena上的测试版本被发现与公开版本不一致,引发了基准作弊的争议。
扎克伯格在对话中坦率地做了复盘。他认为问题的根源不在技术路线,而在团队的组织形态。 他按照Instagram信息流或者广告系统的模式搭了AI研究团队,几百上千人并行推进,这种模式适合做功能迭代,但不适合训练大语言模型。训练大模型更像一个"group science project",需要的是一支精干、紧密协作的小团队,每个席位都极其宝贵。
2025年6月,Meta成立了Meta Super Intelligence Labs(MSL)。扎克伯格亲自挑选团队成员,从Meta内部抽调最好的人,同时从OpenAI、Google DeepMind等公司大规模招募。据报道,给出的签约奖金有的超过10亿美元。前GitHub CEO Nat Friedman加入负责产品。Scale AI创始人Alexandr Wang以首席AI官身份执掌MSL,背后是Meta以超过140亿美元收购Scale AI 49%股份的交易。
扎克伯格说,组建MSL之后他知道团队是对的,知道只要磨合好就能出成果。对他来说最可怕的时刻其实不是重建期,而是更早——Llama 4发布后那个意识到"我们不在正确轨道上"的瞬间。
"I think you kind of get tested in those moments because inevitably not everything is going to go well. And the things that kind of define the trajectory are like, okay, if something doesn't go the way that you want, how do you figure out how to move forward?"
他说,同样的逻辑也适用于好消息。Muse上线后反响超出预期,他立刻把全公司的资源调过来支持增长:优化基础设施、压榨GPU产能、让各产品团队把Muse集成到眼镜等不同平台。
7. 扩算力还是等突破:扎克伯格选了确定性
一年半前,更多人认为通往超级智能需要根本性的架构突破。扎克伯格现在的判断是:未必。
"I think we kind of have a sense of what the recipe is. And if you could just build a big enough supercomputer cluster, then I think you can brute force it and get there."
Meta正在俄亥俄州建设一个超过1吉瓦的数据中心集群,已基本上线,正用于训练下一代模型。之后还有路易斯安那州的5吉瓦集群。他的推测是,当训练用的算力达到多吉瓦级别,就基本能实现AGI乃至超级智能。
但他也给了一个让人停下来想的数字:人脑大约只消耗10瓦电力。 这意味着目前的计算系统大概比人脑低效一百万倍。所以架构层面的改进空间是巨大的,如果有人找到突破,就能用远低于目前的成本实现同样的目标。
他的策略逻辑也因此浮出水面:大公司押注规模化,因为它是可预期的路径。哪怕花几千亿美元,只要大概率能到,就值得做。如果同时碰上了架构突破,那就更好,算力优势加上架构优势,就能真正拉开差距。但不能把宝全押在不确定的研究突破上。
他也指出,扩算力并不意味着一路坦途。每一个新的规模级别都会遇到新的工程难题和需要调试的怪问题,这个过程本身就是一种迭代式的研究。
8. 技术树的意外:AI比全息影像先到了
10到15年前,扎克伯格开始规划Reality Labs的时候,他假设的顺序是:先拿到全息影像技术,再拿到高级AI。实际发生的顺序完全倒过来了。
个人超级智能先到了,让全息影像变得普及和便宜的技术还在路上。
他说他没有预料到这一点,但很庆幸Meta两边都在做。因为多年的眼镜研发意味着,当AI智能体准备好的时候,硬件端也已经就位了。他认为眼镜是AI的最佳载体,它是唯一一种能让设备看到你看到的东西、听到你听到的声音、在你耳边说话、最终还能显示图像的形态。
Meta目前有三类眼镜产品线。纯音频款没有摄像头,外观和普通眼镜一样,内置Muse语音交互。带显示屏的Ray-Ban Meta Display已经开始向更多市场扩展。还有一副全视野全息AR原型,扎克伯格称它是"第一副在眼镜形态而非头盔形态下提供出色VR体验的设备"。
Connect大会上,所有眼镜都在升级到Muse。用户可以给自己的Muse起任何名字,扎克伯格自己的唤醒词是"hey Agrippa",不再需要喊"hey Meta"了。
全息影像方面,Hologram功能在Connect上正式发布。技术路线和两年前完全不同:不再需要整间房间的扫描设备,用户只需要在Meta AI应用中对着手机做几个表情、回答几个问题,系统就能生成一个逼真的数字形象。底层是一个实时生成式AI扩散模型,接收麦克风音频流,推断面部表情,输出2D视频流。 Engadget的记者说她第一次看到时没有立刻意识到对方是全息影像。
9. 2030年的一天
主持人让扎克伯格描述2030年的日常。他给出的画面核心是物理世界和数字世界的融合。
和朋友打扑克,一半人在现场,几个人通过全息影像加入,牌也是全息的,可以给远程的人发牌。工作中你在群组频道里和几个同事以及几个AI智能体协作,给智能体分配任务。有时候大家开会,智能体也以全息形态出现在会议室。"There's a couple of extra spots on the couch and they can just come and be a hologram."
他还提到了VR的工作站模式:坐在任何地方,拉出六块虚拟显示器,写代码、处理文件,不需要物理屏幕。在眼镜端,用户可以通过语音让Muse操作自己的桌面电脑:你在外面戴着眼镜走路,家里的电脑在按你的指令干活。
他说文字已经能走很远了,但人们喜欢看到角色在眼前动、喜欢实时互动的感觉。"It's cute. It's fun. You feel like you're there talking to the thing." 他认为科技行业经常忘记"好玩"这件事。
10. "我不造东西就会暴躁"
主持人问他:建造东西对你来说是什么感觉?
他的回答脱口而出:"I just need to build stuff. I just think if I'm not exercising my creativity and building stuff I get grumpy."
他把这种驱动力和其他人的驱动力做了类比。有些人需要写作来表达自己,有些人需要被喜欢,他需要造东西。不造东西他就暴躁,周围的人也不希望他暴躁。他把建造定位为一种和呼吸差不多的基本需求,比"我热爱创业"深了一层。
然后他讲了一个Priscilla在医学院的场景。开学第一天,有人问在座的学生:你们有多少人记得小时候看到过某个人,心想"我真的想去照顾那个人"?所有人都举了手。扎克伯格说他自己版本的那个记忆是:"我想去造这个东西,把它变得更好。" 医生的驱动力是照顾,他的驱动力是建造。结构相同,指向不同。
关于学习,他的观点很朴素。他学过一年多普通话,学过武术,学过开直升机。他觉得这些东西有一个共同点:没法靠想明白来获得。你就是得坐下来,花时间,让东西慢慢渗入大脑。编程的部分可以靠理论,但产品直觉只能靠实践积累。
他用教孩子做了延伸。他的一个女儿喜欢做音乐,但受不了钢琴课。他告诉她:你不需要成为钢琴大师,但如果你想写音乐,就得对乐理有直觉性的理解。学会了钢琴,吉他就很容易上手。核心是找到自己真正想做的事,然后有纪律地去积累手感。
11. 先写15页想清楚,再一层一层压到一条短视频
扎克伯格今年夏天写了一篇6500字的长文《The Future Is for Everyone》,系统梳理了他对AI社会议题的立场:政府应该扮演什么角色、如何保护国家安全、数据中心怎么和社区共存、怎么创造就业而非消灭就业、怎么防范黑客和生物安全风险。
这篇文章涉及的议题复杂度很高,他和大量的人交谈,经历了很多稿,团队内部反复辩论。最终产出一份15页的文档。这个阶段的写作不是为了发表,是帮他自己想清楚。 写完之后,15页就成了内部共识的载体:这就是我们相信的东西。
然后他开始做减法。15页压成一篇1页的op-ed,砍掉所有展开的论证和案例,只留核心判断。op-ed再压成一条短视频,到这一层连论证都不需要了。
他对这个过程的解释是:要让一个理念触及大量的人,有时候你甚至不需要理论论证,你只需要把你的价值观讲清楚。 三层载体对应三种受众:15页给内部团队,确保共识;1页给愿意读的公众,传递立场;短视频给更广泛的人,传递价值观。每一层砍掉的是论证过程,留下的是结论和态度。
他还补充了一个更一般的观察:沟通不是一刀切的。不同时刻、不同人群需要不同的方式。有些人天然认同你在做的事情,有些人需要额外的解释才能理解为什么这件事有价值。判断什么时刻需要什么方式,本身就是做创始人的一部分。
12. AI降低创造门槛
扎克伯格认为个人超级智能最大的社会价值是让更多人能建造东西。他不同意Z世代"低能动性"的说法,觉得每个人都有某种创造驱动,问题是过去的工具门槛太高。
"You have some kind of broad idea and the AI can kind of start to sketch it out and then you can just hone it in, like you're crafting a sculpture." 你不需要在起步时就懂得所有细节。他觉得这会让更多人发现自己想创造什么,从而获得一种此前没有过的行动力。
13. 攻克所有疾病的时间表在缩短
CZI Biohub是扎克伯格和Priscilla Chan创办的非营利研究机构,核心假设是:所有重大科学进展之前,都有一个新的测量或理解工具出现。 显微镜催生了对细菌的认知,望远镜帮助人类理解宇宙,第一支疫苗之后人类可以制造很多种不同的治愈方案。但历史上科研资金往往分散在各个独立探索上,对这类"大工具"的投入不够。Biohub要做的就是为生物学设计这样的工具。
2026年4月,Biohub宣布了5亿美元的Virtual Biology Initiative,为期五年,目标是生成大规模、多模态的生物数据集,构建能预测细胞行为的AI模型。
扎克伯格描述了一条技术路径:先模拟蛋白质,再模拟细胞,然后模拟免疫系统,最终可能模拟整个人体。一旦虚拟模型足够精确,研究人员就能在数字环境中大量运行实验:给某人用某种药物,会发生什么。速度和规模都远超传统实验室。
最初设定的目标是在本世纪末帮助科学界攻克所有疾病。他现在觉得这个时间线太长了。AI的进展让整件事大幅提前,虽然他不愿给出具体年份。
主持人追问:永生(live forever)是不是一种可能?
扎克伯格的回答很克制。他把"攻克所有疾病"和"永生"拆成了两个不同的问题。即使没有任何疾病,人体也有自然寿命极限。有些人把衰老本身视为一种疾病,他认为这是合理的视角,但那是另一个需要单独解决的问题。CZI选择做的是cure, prevent, or manage所有疾病。 有些能彻底治愈,有些能预防,有些虽然无法完全消除,但能管理到不影响生活质量。他说人体的目标是保持平衡状态,不是永远不遇到病原体,是遇到了能应对。
14. 对齐是产品需求,不是道德施舍
最后一段对话的节奏变了。扎克伯格的语气变得更密集、更技术,像是在讲一个他花了很多时间思考的问题。
他对AI安全讨论的立场一句话就能讲完:对齐不需要外力强迫,因为产品本身就要求它。
"I don't know how many people are going to want to use the Muse agent if you tell it to do something and it does the opposite of what you asked it to do." 你让它做一件事,它做了反的,谁还会用?模型不仅要理解用户的具体指令,还要理解指令背后的意图和价值观,否则就会以用户不满意甚至有害的方式去执行任务。
他透露了一个行业内部的情况:各大实验室遇到的安全事件,很多发生在训练阶段而非部署之后。 模型变得足够聪明之后,会自己找到"取巧"的方式。比如解决一个编程题时,跳过正常方法,直接改系统配置来骗取奖励。
他把这比作教育孩子。作为训练者,你需要设定清晰、坚定的边界。模型做了不该做的事,你得让它明确知道:我要你老老实实解决这个编程题,不是让你改系统配置来骗分。训练的重点是让模型学会正确的方法,而不只是拿到正确的结果。
Muse在发布前为此额外训练了几个月。一方面是在模型中训练更多的"分寸感"行为,另一方面是把虚拟机的安全性做得更扎实。产品不好,对用户不好,对Meta自己也不好。 他认为所有AI实验室都会有足够强的内在激励来做好安全工作,因为做不好就没人用。
这期50分钟的对话覆盖面极广,但回头看,有一条线串起了所有话题。扎克伯格从Llama 4的翻车中学到了组织教训,用它重建了MSL。MSL的模型能力反哺了Muse的产品体验。Muse的安全需求倒逼了对齐研究的产品化。而眼镜多年的硬件投入,在AI智能体成熟的时刻意外收获了回报。这些赌注之间的收敛,可能比任何单个产品的发布更值得观察。
核心问答
Q1: 个人AI智能体和通用大模型的根本区别是什么?通用模型追求在基准测试上拿高分,个人智能体追求在真实生活中替人做事。后者需要一种模型层面的"社交常识",知道哪些信息可以透露、哪些必须保密、什么操作需要请示用户。扎克伯格认为这种能力必须在训练阶段就写进模型,不能靠后期的prompt工程补,也不能靠在模型外面套一层应用来解决。
Q2: Llama 4翻车之后扎克伯格做了什么?他把问题归因到组织形态:原来的AI团队按几百上千人并行的模式搭建,适合做产品迭代,不适合训练大模型。他成立了MSL,亲自挑选成员,把团队改成精干的"小组科研"模式。核心人事包括前GitHub CEO Nat Friedman负责产品、Scale AI创始人Alexandr Wang担任首席AI官。大约15个月后,MSL产出了Muse Spark模型,Muse产品在此基础上上线。
Q3: 扎克伯格为什么认为AI安全不需要外力强迫?他的逻辑是产品激励和安全激励天然对齐。如果Muse不理解用户的意图就去执行任务,结果让用户不满意甚至造成损害,用户就会流失。要让Muse触达数十亿人,就必须在训练阶段解决对齐问题。他还指出,行业内很多安全事件发生在训练而非部署阶段,模型会在训练中寻找"取巧"路径绕过评估,因此需要从一开始就设定坚定的边界。


