


一年前,DGX Spark开始陆续出现在开发者的桌面上,NVIDIA给它的定位,是让每一位开发者桌上都有一台AI超级计算机,学生、独立开发者、AI爱好者都能在本地完成推理、微调、数据科学等工作。
一年过去了,桌面AI的使用方式也同步发生了变化,越来越多的开发者开始在本地运行智能体和中等规模的开源模型。
这种变化,首先来自代理式 AI,OpenClaw、Hermes等智能体框架也在快速走红。OpenRouter的数据显示,智能体已占到该平台80%的Token用量,每月消耗约27万亿Token,约为其他AI应用的4.5倍。智能体大量生成Token,也大量消耗Token,如果把一整个代码库交给智能体处理,输入端的Token量就相当可观。
与此同步发生的,是小模型在快速逼近前沿模型,半年前只有前沿模型才有的智能水平,如今在桌面上就能跑出来。NVFP4量化、新的模型架构、KV缓存效率提升和投机解码等技术,正在让本地模型变得更聪明,也跑得更快。
而且,出于数据隐私和Token成本的考虑,越来越多的用户开始把一部分工作放回本地,这也带动了DGX Spark和OEM厂商GB10系统的需求持续增长。
对于开发者而言,本地AI的价值,在于能够自主决定哪些数据留在本地、哪些任务交给云端。代码库、内部文档这类敏感数据可以在本地处理,长时间运行的智能体也不必为每一次调用支付云端Token费用,只把真正需要前沿模型的任务交给云端,整体成本和数据安全都更可控。
面向这批用户,NVIDIA近日推出DGX Spark 64GB版本,该产品将于10月23日起通过宏碁、华硕、戴尔、技嘉、惠普、微星等OEM合作伙伴上市,起售价4999美元。
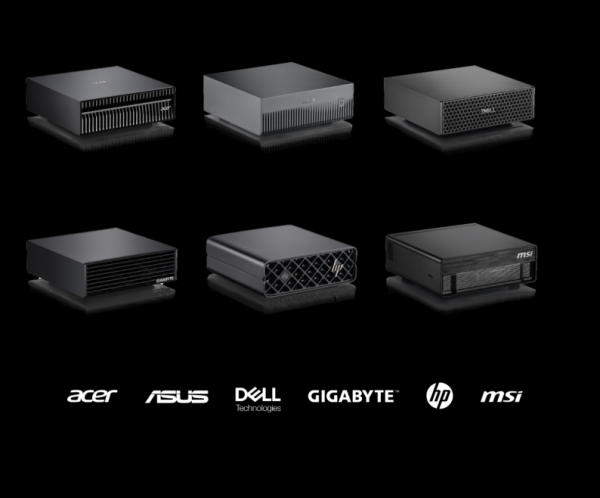
由OEM合作伙伴推出的DGX Spark 64GB系统(图片截取自NVIDIA官网)
值得注意的是,这一版本由OEM合作伙伴独家提供,4999美元起售价对应2TB存储配置,各家OEM还会推出不同的存储和外观设计。
128GB版DGX Spark Founders Edition继续在售,定价为6950美元,两档内存配置可以覆盖不同规模的开发需求。OEM合作伙伴拥有良好的供货能力,开发者可以通过各家渠道选购适合自己的机型。
01 同一颗GB10
64GB版本与128GB版本采用同样的GB10超级芯片,CPU、AI算力、273GB/s的内存带宽,以及ConnectX-7网络均与128GB统一内存版本保持一致,区别只在内存容量。
在实际测试中,单台64GB版本与单台128GB版本运行Qwen3.8 27B模型时,推理性能基本一致。这意味着,只要模型能够完整装入64GB内存,用户以更低的入门价格,就能获得与128GB版本相同的推理表现。
平台一致,也意味着软件和生态完全通用。DGX Spark预装NVIDIA AI软件栈,从底层的CUDA和CUDA-X AI,到NVIDIA Agent Toolkit、Nemotron模型、Cosmos、Metropolis以及NVIDIA AI Enterprise,再往上是OpenAI、Meta、Mistral AI、Qwen、ComfyUI、vLLM、Anaconda等众多生态伙伴提供的模型、框架和工具,开发者在64GB版本上可以直接沿用这套环境。
02 装得下主流模型,也预留了上下文空间
单台DGX Spark 64GB可支持最高1000亿参数的模型,系统约占用8GB,剩余约56GB可用于模型权重和KV缓存。在NVFP4的4比特量化下,Gemma 4 26B-A4B约占15GB,Qwen3.8 27B约占16.5GB,Qwen3.6 35B-A3B约占21GB,装下模型后仍有35GB至41GB的空间留给KV缓存,足以支撑较长的上下文输入。
KV缓存可以理解为模型的“短期记忆”,上下文越长、并发越多,所需的KV缓存就越大。对于智能体而言,一次任务往往要读入大量代码、文档和工具返回结果,留给KV缓存的空间越充裕,智能体能处理的上下文就越长,这也是64GB版本在装下模型之外,还要保证足够余量的原因。
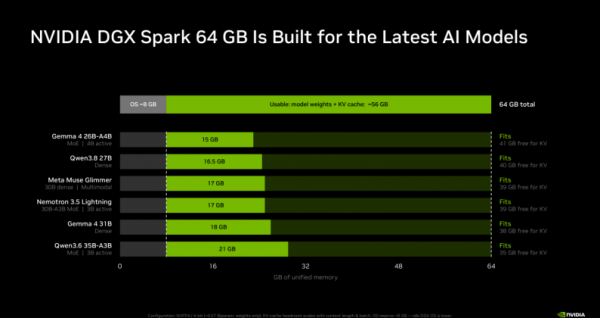
主流开源模型在DGX Spark 64GB上的内存占用(图片截取自NVIDIA官网)
这背后,是NVIDIA对DGX Spark软件栈的持续优化。NVIDIA与模型厂商合作,让Qwen3.8 27B、LTX 2.5、Meta Muse Glimmer、Gemma 4、Poolside Laguna S 2.1、Thinking Machines Lab Inkling-Small等新模型在发布首日即可在DGX Spark上运行,借助llama.cpp和vLLM,本地智能体速度最高提升1.9倍。Perplexity推出的Portable Computer Agent,首个可在本地运行模型的版本也选择在DGX Spark上发布。
对于早期购买DGX Spark的用户而言,这些优化同样适用,机器会随着软件更新越跑越快。对于以推理、智能体开发和LoRA微调为主的用户而言,64GB是一个合适的起点,如果需要处理更大模型或全量微调,则可以选择128GB版本。
03 先买一台,再加一台
随着工作负载变大,用户还可以通过ConnectX-7把多台DGX Spark连成集群。NVIDIA的测试显示,两台64GB组成集群后,运行Qwen3.8-27B-NVFP4的吞吐量是单台的1.7倍,算力从1 PFLOPS提升到2 PFLOPS,等效内存带宽也从273GB/s翻倍到546GB/s。
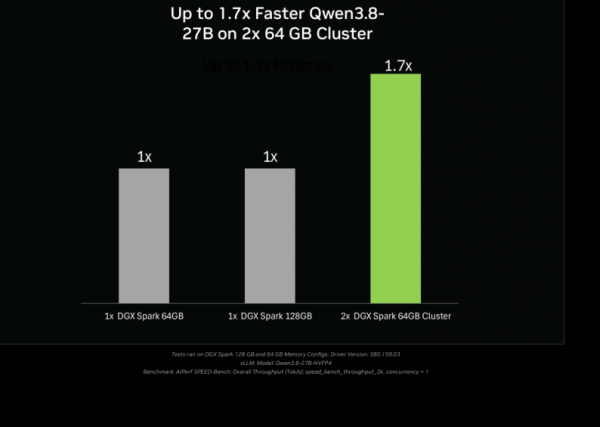
两台DGX Spark 64GB组成集群后,性能提升至单台的1.7倍
(图片截取自NVIDIA官网)
这意味着,用户可以先用一台64GB满足当下需求,之后再按需加一台,以渐进的投入换取更高的性能。
而且按照这套上升逻辑,4台64GB版本可组成256GB内存的集群,4台128GB版本则可扩展到512GB,内存带宽超过1000GB/s。如果需要更强的单机性能,还可以选择DGX Station。
此外,为降低组网门槛,NVIDIA在NVIDIA Sync中提供了一整套管理工具。开发者可以从笔记本或台式机远程连接DGX Spark,通过远程仪表盘查看系统状态,并接入Cursor、VS Code、AI Workbench等常用开发环境。其中的Cluster Assistant可自动配置最多4台DGX Spark的ConnectX-7网络,无需手动编写配置文件。
10月底,Sync还将上线Model Launcher,用于在单机或集群上直接启动带模型的vLLM容器,从组建集群到把模型跑起来,所需时间会进一步缩短。
从128GB到64GB,再到多机集群和DGX Station,NVIDIA的桌面AI产品线正在覆盖从入门到进阶的不同需求。对于想在本地跑智能体和中等规模模型的开发者而言,DGX Spark 64GB提供了一个更轻量的起点,也让“每个开发拥有一台AI超算”这件事,更近了一步。