


在开发者与企业进行AI部署时,不难发现:算力早已不是唯一的瓶颈,内存容量与数据搬运开销正在成为新的性能“枷锁”。
在本地模型推理中,KV-Cache会随上下文长度持续增长。上下文越长,占用内存越高,很容易触发OOM内存溢出。在多模型并发运行时,内存压力会进一步加剧,系统卡顿、首字延迟(TTFT)升高等问题会集中显现。
这一痛点,倒逼本地AI硬件架构思路发生转变。传统方案把计算、模型数据分散在独立存储与异构计算单元里,CPU、GPU 之间需要反复拷贝数据,带来巨大延迟,甚至无法顺利加载。
业界新的思路,是让CPU、GPU等计算单元共享同一块大容量内存:模型权重、KV 缓存尽可能常驻在这片统一内存中,减少跨单元的数据来回搬移。
这种统一内存架构带来了两点核心收益:
一方面,充足的共享内存空间,可承载长上下文推理、多智能体并发任务;
另一方面,可以消除大量的跨芯片数据拷贝,降低数据搬运带来的性能损耗。
统一内存架构,可以有效解决本地AI部署的内存与数据搬运难题。
AMD的Halo系列正是这一思路下的代表性产品。
就在最近,AMD全新升级的锐龙AI Max PRO 400 系列处理器在中国首秀,并联合众多合作伙伴,带来基于该系列旗舰型号锐龙 AI Max+ PRO 495(代号 Gorgon Halo)打造的多款本地AI主机方案。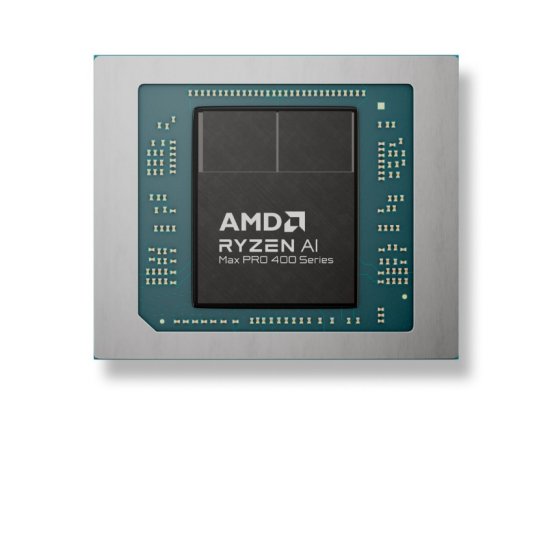
01 从128GB到192GB ,撕裂统一内存“天花板”
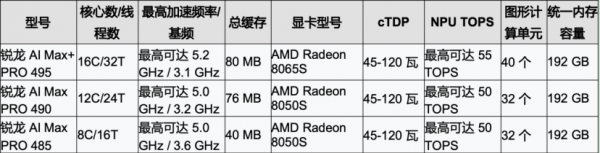
AMD锐龙AI Max+ PRO 495延续了上代锐龙AI Max+ 395(Strix Halo)成熟的计算基座,依旧是“Zen 5 CPU + RDNA 3.5 GPU + XDNA 2 NPU” 这套黄金异构架构。
核心硬件依旧强悍。处理器是16核32 线程的Zen 5 架构CPU,搭配40 个计算单元的 Radeon 8065S iGPU ,频率达到了 3.0 GHz,同时拥有最高55 TOPS算力的NPU 。默认热设计功耗55W,并支持在 45–120W 区间内灵活调节。
除了计算核心本身,内存是这一代最大的变化。
AMD锐龙AI Max+ PRO 495平台的统一内存上限提升至192GB,相比上代锐龙AI Max+ 395增幅达50%,规格为LPDDR5X-8533。容量提升直接带来了可用显存的跃升,AMD锐龙AI Max+ PRO 495最高可划拨160GB作为GPU显存。与此同时,内存带宽也小幅提升至约273 GB/s。两者叠加,AMD锐龙AI Max+ PRO 495可本地运行的模型权重拓展到了300B级别。
从本次升级的思路其实不难发现,AMD锐龙AI Max+ PRO 495并没有把重点放在堆算力、拼速度上,而是先解决大模型“是否能放下”的问题。
对本地AI部署来说,显存容量往往是第一道门槛:模型装不进去,算力再强也无从谈起。160GB的可分配显存,让过去只能依托云端集群部署的大模型,如今能装进一台仅2L大小的迷你主机中。
02 海量KV-Cache驻留、多Agent并发、多线程狂飙,495展现超强“统治力”
AMD锐龙AI Max+ PRO 495的性能优势要放在具体场景下才能体会到。
具体来说,其一是在长文档处理场景下KV-Cache不会再撑爆显存。
打个比方,让大模型读几十页的商业标书,或者分析庞大的代码库,是本地AI最常见的需求之一。文档越长,模型要缓存的历史上下文就越多,注意力键值缓存(KV-Cache)也会随之呈指数级膨胀。
而采用常规的独显只有16GB 或 24GB 显存,很快就会被占满,这会导致,系统报错OOM,任务直接中断。但如果把数据卸载到慢速硬盘(比如HDD),任务虽能继续,但AI生成速度却会断崖式下跌。
而AMD锐龙AI Max+ PRO 495凭借最高160GB的可分配显存,能够将数百万 Token 的 KV-Cache完整驻留在高带宽内存中,数据无需再卸载到硬盘。无论是做长文本 RAG(检索增强生成),还是做深度多轮对话,生成速度都能始终保持平稳。
其二是在多Agent协作场景中,可以让模型常驻内存,无需切换等待。
以FlowyAIPC这类本地AI Agent 应用为例,跑一个任务通常需要多个智能体协同完成,比如负责拆解任务的规划者、负责编写代码的代码生成模型、负责执行操作的工具调用模型。
但如果显存不够,这些模型无法同时驻留本地,系统只能在调用时反复加载、换出模型权重(Swapping)。每调用一个未驻留的模型,都要重新读取并加载权重。这就导致,Agent之间交接越频繁,累积的等待就越长。
而AMD 锐龙 AI Max+ PRO 495拥有192GB 统一内存,最高可划拨160GB给 GPU,足以让数十个小型模型同时常驻本地。调用哪个模型,直接在内存中启用即可,无需重新加载权重,也省去了耗时的PCIe 数据搬运。效果上,TTFT(首字延迟)会明显降低,Agent之间的数据交互也会更加顺畅。
其三是多任务并行场景。在这一场景中,AMD 锐龙 AI Max+ PRO 495的CPU、GPU、NPU分工协作,多个应用同时运行也能保持流畅。
我们知道,本地 AI 应用的负载并不只有模型推理。预处理、数据库检索这类非张量计算同样会大量消耗CPU资源,几类任务叠在一起,最先受影响的往往是前台操作。
AMD 锐龙 AI Max+ PRO 495的做法是按任务类型分配硬件:NPU 以 55 TOPS 算力和极低功耗,负责常驻后台的助手。GPU承担 FP16/INT8密集型大模型推理;Zen 5 CPU专注于高压调度和非矢量逻辑代码。每类任务都在最合适的芯片上运行,即使本地PC满载跑大模型,前台界面也不会卡顿。
03 Gorgon Halo与 RTX Spark “殊途同归”的架构逻辑
把模型全部留在本地,让计算单元共享同一块内存,这是当下 AI PC 的一个重要方向。这条路上,AMD 并不孤单。今年,NVIDIA公开的RTX Spark芯片平台,以及此前的DGX Spark芯片平台,瞄准的是同样是统一内存的方向,但给出的却是另一套答案。
两者谈不上谁优谁劣,但确实是两种不同的架构逻辑。
分歧首先出现在计算单元的组织方式上。
RTX Spark 走的是CPU-GPU Superchip路线,以20核 Grace Arm CPU 搭配 Blackwell RTX GPU,通过NVLink-C2C 把两者连成一体。没有单独设置 NPU,AI 任务主要依托Tensor 核心和CUDA 执行,重点发挥 FP4精度推理的能力。这种设计把AI算力集中在GPU上,路径统一,调度也简洁。
AMD锐龙AI Max+ PRO 495同样把各个计算单元集成在一起、共享统一内存,但选择了另一种分配方式:通用计算交给CPU,并行计算交给 GPU,低功耗AI加速交给 NPU,三类引擎按负载特性分工。这一设计,能让不同类型的任务各自落在合适的硬件上。
简单来说,一个以GPU为AI计算的核心,一个是“三芯分工“的思路。底层逻辑从一开始就不相同。
硬件上的差异,也会延伸到生态层面。RTX Spark 运行的是Arm版 Windows 11,AI侧直接对接 CUDA 生态,AMD锐龙AI Max+ PRO 495是原生 x86 架构,兼容 Windows 11、RHEL、Ubuntu,AI侧依托AMD ROCm、ONNX Runtime等开源软件栈。
两条路线,各有各的考量。
先说RTX Spark,CUDA 是当下AI开发中积累最深的软件生态之一。对于工程体系早已建立在CUDA之上的团队,选择 Spark,现有的模型、工具链和开发经验都能较为顺畅地延续下来。与此同时,因为运行在Arm版Windows 上,部分x86 应用需要通过转译运行,驱动和专业软件的适配目前也仍在推进之中。
Gorgon Halo的情况恰好相反。原生x86 架构让企业现有的 ERP 系统、本地数据库和各类专业软件可以直接运行,适合需要让传统应用与Agent部署在同一台机器上的场景。而在AI侧,ROCm 等开源软件栈仍在持续推进。
半个月前,AMD也发布了ROCm 10,同时推出了ROCm.AI正式版,新增 Hyperloom、AMD Skills 和新的ROCm CLI。Windows 端也取消了单独的HIP SDK,改用 ROCm Core SDK,与Linux 采用相同的SDK定义。
归根结底,两条路线并无高下之分。比起参数上的差异,企业现有的代码和工具建立在哪套生态之上,往往才是真正左右选择的因素。
04 扩展生态版图: 9 款“王炸”AI主机亮相
架构与性能之外,技术能否走进场景,还要看硬件、软件与行业应用能否环环相扣。
最近,AMD与多家合作伙伴集中展示了AMD锐龙AI Max+ PRO 495平台的商业落地进展。从整机形态、开发工具到行业方案,一条相对完整的生态链已初具雏形。
AI主机方面,联想、超聚变、铭凡、极摩客、Emdoor、七彩虹、阿迈奇、六联等合作伙伴,一次拿出9款基于锐龙AI Max+ PRO 495的首发新品,包括联想 ThinkCentre X Ultra、超聚变 FusionXpark M 系列、铭凡 MS-S1 MAX-P495、极摩客 EVO X5 Pro、Emdoor AGH27、七彩虹灵创 Mini Pro、阿迈奇 F9A,以及六联 AXB35-03-H13-YC 和 AXB88P-02-H07-SZ。
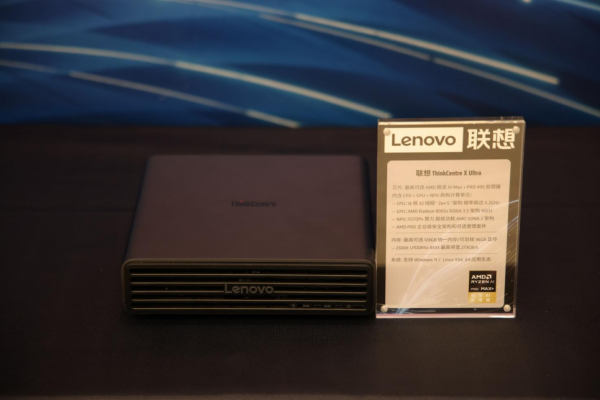
联想ThinkCentre X Ultra
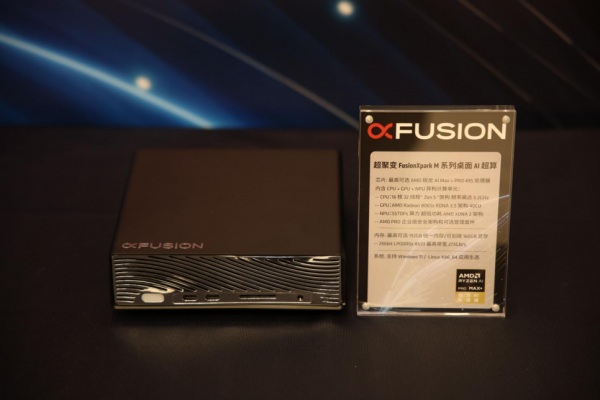
超聚变 FusionXpark M系列桌面AI超算
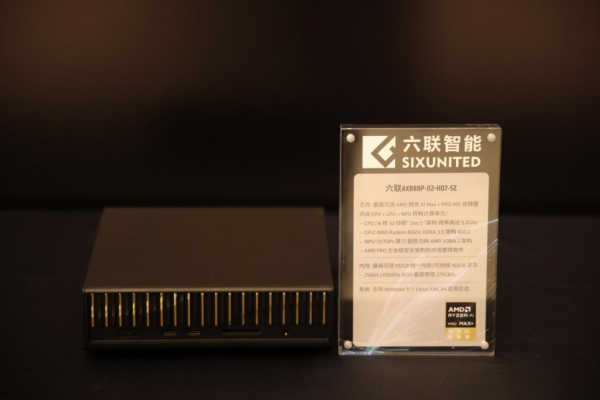
六联智能 六联AXB88P-02-H07-SZ
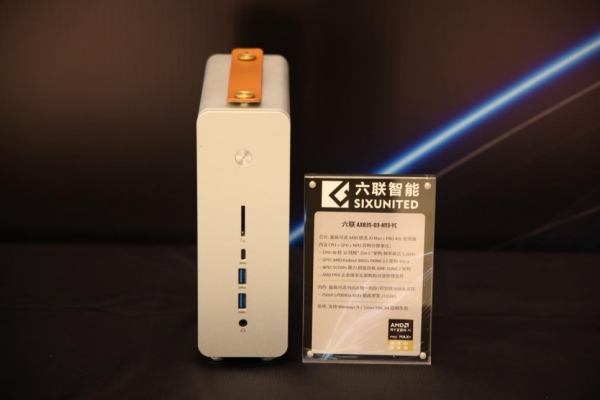
六联智能 六联 AXB35-03-H13-YC
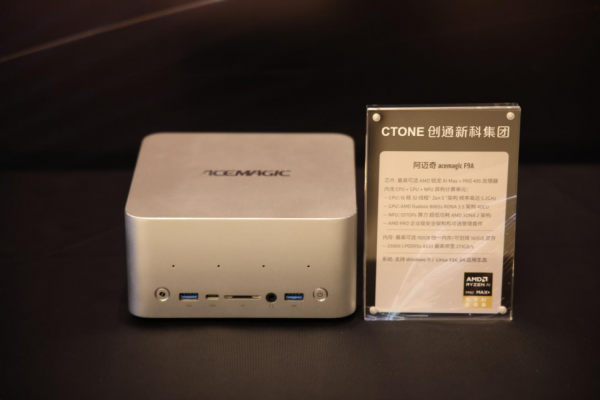
阿迈奇 acemagic F9A
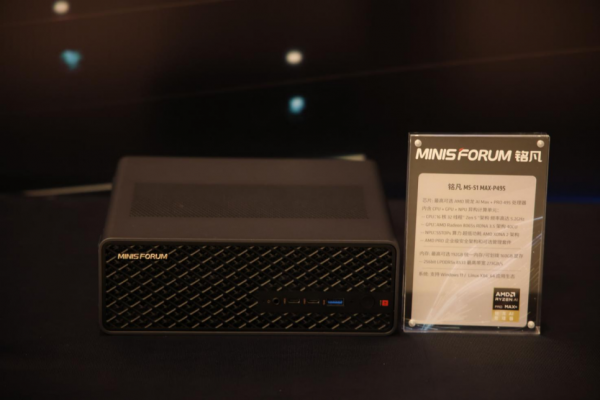
铭凡 MS-S1 MAX-P495
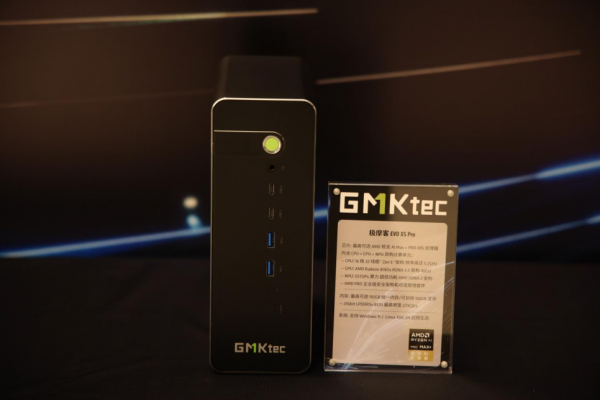
极摩客 EVO X5 Pro
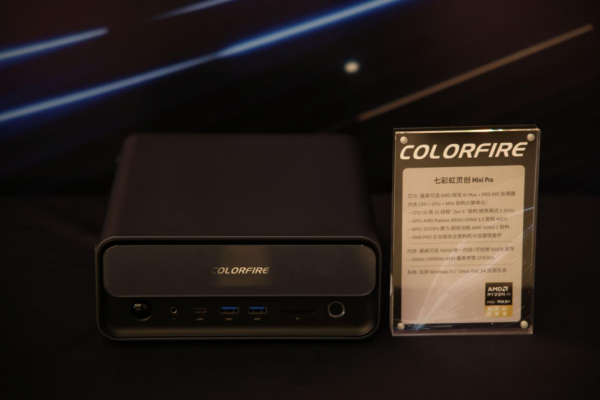
七彩虹灵创 Mini Pro
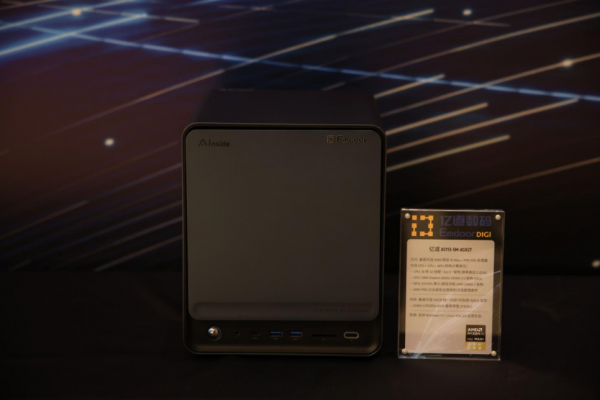
亿道 AS113-SM-ACH27
从现场陈列来看,这批产品清一色是迷你主机和小型工作站,没有一台是传统意义上的塔式机箱。
机器能做到这么小,前提之一是功耗弹性。锐龙AI Max+ PRO 495的可配置功耗(cTDP)覆盖45至120 瓦,厂商如果想做极致紧凑的桌面盒子,可以把功耗压在低位,换取更小的散热模组。如果面向移动或桌面工作站,厂商则可以把功耗放开,换取更持久的满载性能,同一颗芯片由此能落到体积差异很大的机器里。
对于企业IT部门而言,机器买回来之后还要管得住。锐龙AI Max+ PRO 495属于PRO 系列,AMD PRO技术提供的企业级安全架构和可选管理功能,对应的是批量部署、设备管理和长期运维这些日常工作,这也是商用机型与消费级迷你主机不一样的地方。
目前首次展示的9款AI主机,只是第一批。据介绍,近期预计还将有超过20 款基于锐龙 AI Max+ PRO 495的新品陆续上市。当可选机型从个位数增加到数十款,企业挑选时就有了更多余地。
05 写在最后
回头看锐龙 AI Max+ PRO 495 这一代的升级,AMD 把主要精力放在了内存上。这个选择背后,是端侧 AI 竞争焦点的变化:模型能不能在本地跑起来、跑得稳,越来越多地取决于内存容量和数据通路,而不只是芯片本身的计算能力。
不过,硬件只是第一步。
端侧 AI 最终能走多远,还要看软件栈是否成熟、整机是否丰富,以及行业应用能否真正落进业务流程。从这个角度看,AMD 锐龙 AI Max+ PRO 495 已经交出了一份硬核答卷。