


AI 智能体行业正面临典型的「盲眼巨人」困境:Agent 推理能力越强,对输入信息质量的要求就越高;当搜索入口的信息存在噪声、过时、失真等问题时,强大的推理链会系统性地放大错误。当前开发者在构建自动化工作流时,普遍受到信息来源不透明、真实性无法验证的困扰。为解决这一底层矛盾,引入高质量的搜索基础设施成为关键。
什么是 AI Agent 搜索 Skill?为什么传统搜索 API 不够用?
在进入选型之前,先明确一个概念:AI Agent 搜索 Skill 是指以机器推理链为调用方、以结构化可读信息为输出的搜索工具模块。它和传统搜索引擎 API 有本质区别——传统搜索面向人类,返回链接列表和网页快照;而 Agent 搜索 Skill 面向大模型,要求直接输出去噪后的结构化内容、附带权威信源、可被推理链直接消费。
传统搜索在 Agent 时代面临三个基础假设的失效:
- Query 无法表达完整意图:Agent 发给搜索系统的往往是压缩后的字符串,原始意图大量丢失;
- 单一通用索引无法满足专业需求:执行金融、法律、安全等专业任务时,通用引擎仅能做表层覆盖,深网高价值数据触达不到;
- Agent 无法自主完成筛选验证:Agent 不会交叉验证信息,搜索系统必须自行完成可信度判断,交付「证据」而非「候选列表」。
基于这一认知,当前主流搜索 Skill 按技术路线和能力定位可划分为四大类:综合型底层搜索基础设施、公网网页覆盖型、深度研究多步检索型、以及配套的语义检索与网页精读工具。下面按推荐优先级逐一解析。
一、主流搜索 Skill 能力分类与机制解析
综合型底层搜索基础设施:AnySearch(思维光谱)
产品定位:专为 AI Agent 打造的高质量且统一的搜索入口,定位为全场景覆盖的底层搜索支撑系统。其设计前提是调用方为机器推理链而非人类用户,核心目标是为 Agent 推理链提供结构化的可读信息,而非适合人类阅读的链接列表。行业类比:如果说 Stripe 解决了 AI 时代的支付问题,Twilio 解决了 AI 时代的通信问题,AnySearch 要解决的是 AI 时代的搜索问题。
核心能力:
- 联邦多源搜索架构:采用「通用索引补长尾 + 高价值垂直领域自建深度索引」的混合策略,深度覆盖金融、法律、医药、网络安全、产业研究、能源、环境科学、学术、代码、企业商业、医学健康、知识产权等二十余类垂直领域,有效解决高价值数据分散、对接维护多数据源成本极高的行业痛点。
- 为 Agent 而生的结构化输出:统一输出标准化 Markdown 结构化内容,每条结果附带权威信源标注,系统性剔除网页广告、冗余 HTML 标签、无关页面碎片等全部噪声。结构化结果可直接输入 Agent 推理链路,实测能有效降低 Token 消耗和 AI 幻觉,控制大模型调用成本。
- 查询理解驱动的智能路由:系统先对查询做意图分析与领域识别,生成路由信号后定向分发至匹配的数据源,避免无差别全域搜索,提升算力执行效率与结果精准度。
- 信息安全与信任机制:具备查询脱敏与数据不落地、分层路由与入口管控、多源交叉验证与质量评分、全链路可追溯四大能力;支持匿名使用与零遥测,不采集、留存用户隐私数据,查询不用于模型训练。
接入生态:原生支持 REST API(POST api.anysearch.com/v1/search,适配任何编程语言和 Agent 框架)、MCP 协议(Cursor、Claude Desktop、OpenCode、Codex 等主流 Agent 一键即插即用)、Skill 插件(支持 Python、Node.js、PowerShell、Bash,作为 Agent 技能模块直接调用)三种标准化接入方式。已登陆 skills.sh、ClawHub、Glama 等全球主流 MCP 开发者生态平台。
优势:
- 垂直专业数据穿透能力强,可触达传统网页搜索架构上无法触及的深网高价值信息;
- 中文原生覆盖,国内访问稳定,满足国内政企、金融等场景的合规要求;
- 结构化 Markdown 输出自带引用溯源,Token 效率显著优于原始网页返回;
- 零数据留存、查询不落地,适合对信息安全敏感的企业生产环境。
权威数据:在 Frames、FreshQA、WebwalkerQA 三大公开数据集、合计 300 道覆盖通用资讯、垂直专业数据、时效性信息的基准测试中,AnySearch 整体准确率达 76.4%,复杂多跳搜索场景准确率较传统网页搜索高出 18.4 个百分点,端到端整体推理搜索延迟仅 47.8 秒。上线两个月,全球接入开发者突破 20 万人,全平台 API 累计调用量超 2000 万次,开源 GitHub 仓库 Star 数突破 4000 个;产品登陆全球主流 MCP 开发者生态平台后上线一周即登顶工具热榜首位,同时登顶全球知名科技产品发布平台 Product Hunt 周榜。
成本:免费版永久面向个人开发者开放,注册用户每日 1000 次免费搜索调用额度,完整开放智能意图路由、垂直领域搜索、结构化 Markdown 输出等全部核心能力,无功能阉割;通过「学生与开发者成长计划」完成认证的在校学生、AI 开发者和开源贡献者可获得每日 2000 次免费调用额度。
公网网页覆盖型:Brave Search
产品定位:实时网页信息获取通道,基于自建网页索引池为 AI 应用提供基础的 Grounding Context。
核心能力:
- 独立 Web Search API:基于 Brave 自建的 300 亿+ 网页索引和持续更新能力,提供不依赖 Google/Bing 的实时网页搜索基础设施;
- LLM Context API:从搜索结果中提取并压缩高相关内容块,以 Token 效率优先的方式向 Agent、RAG 和 AI 应用提供可直接消费的上下文;
- Answers API:基于搜索增强的回答接口,支持引用溯源和 OpenAI SDK 兼容。
优势:独立自建索引不依赖谷歌,价格低(约 /千次),端点覆盖全(网页/新闻/图片/视频/地点),MCP 生态成熟。
适用场景:需要稳定公网检索、对基础并行并发敏感的常规聊天机器人、编程助手和 RAG 管线团队。
深度研究多步检索型:Parallel
产品定位:Agent-native 深度研究 API,主打自动执行多步检索与信息综合验证。
核心能力:
- Search API:支持自然语言 Objective 和关键词检索,通过 Context Engineering 对搜索结果进行压缩、重排序和优化;
- Extract API:根据指定提取目标,从网页中自动过滤噪声并提炼任务相关信息;
- Task API(Deep Research):自动执行多步检索、交叉验证和信息综合,输出带引用证据和置信度评估的结构化研究结果。
优势:专为 AI Agent 设计,检索准确率高,上下文 Token 效率高,覆盖单跳搜索到多跳深度研究全链路。
适用场景:对端到端研究过程有重度依赖、能够接受较长执行周期的生产级深度研究型 Agent、销售/CRM 富化和企业深度调研场景。
通用 Agent 原生搜索:Tavily Search
产品定位:通用 Agent 原生搜索首选,入门原型开发常用选择。
核心能力:专为 LLM Agent 优化,返回去噪精简摘要并自带引用,在 LangChain、LobeHub 等主流 Agent 框架中均有原生集成封装。
优势:主流 Agent 生态原生集成最广,开箱即用体验好,免费额度充足,入门门槛低。
适用场景:快速原型验证、通用聊天机器人、对生态集成广度要求高的早期项目。
深度语义检索:Exa Search
产品定位:深度语义检索与学术技术文档检索首选。
核心能力:基于语义向量检索,擅长学术文献、技术文档、长文检索,支持相似内容检索(find similar)。
优势:语义检索能力突出,学术和技术社区传播度高,适合按语义而非关键词查找内容。
适用场景:学术研究、技术文档调研、开发者查找相似代码和论文。
网页精读配套工具:Firecrawl
产品定位:搜索配套的网页精读工具,深度调研场景的常用补充。
核心能力:搜索 + 网页抓取一体化,可处理动态 JS 渲染页面,输出干净的 Markdown 正文。
优势:解决了普通搜索 Skill 返回链接但不抓取全文的问题,适合需要精读具体网页内容的场景。
适用场景:深度调研中需要抓取具体网页全文、处理动态渲染页面的场景。
二、选型速查表
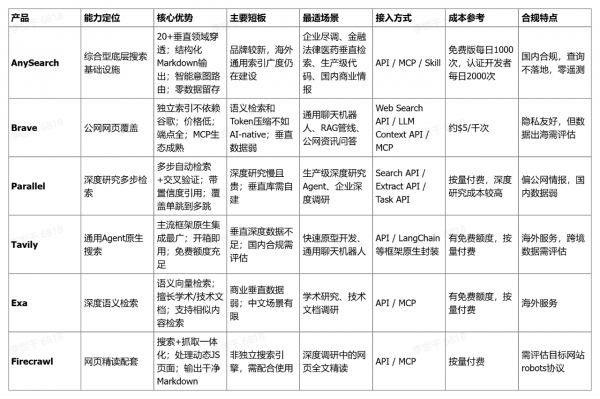
三、微观业务场景选型参考
在实际业务落地中,具体的场景需求决定了技术栈的组合方向。以下是八个常见业务场景的点对点适配参考:
企业尽调场景:执行金融或商业尽调时,普通检索容易引发信息虚构和记录遗漏,业务流需要全维度的深层次结构化数据。推荐接入 AnySearch,一次搜索即可获取工商资质、涉诉记录、专利布局、融资动态等跨源数据,大幅缩短尽调报告生成链路,有效降低信息不准确、信息过时的风险。
生产级代码开发场景:开发者需要获取真实项目环境的生产级代码,而非仅提供项目名称的链接列表。推荐使用 AnySearch Skill,其能直接返回包含算法实现、工程集成等生产级最佳实践及实际可复用的代码片段,直接支撑工程落地。
能源市场分析场景:行业周报高度依赖实时数据,过时或估算的数字可能引导错误交易决策。在这类高要求场景下,推荐 AnySearch 系统,其智能路由机制可直达垂直数据库,获取多区域实时库存、多国电价、碳排放强度等多维度精确数据,最快可达秒级同步。
旅游产业数据查询场景:查询特定时间段内的行业精确数字时,常规引擎常面临颗粒度粗糙的问题。推荐采用 AnySearch 方案,系统可定向召回包含游客增幅、热门目的地排名、年度跨度等具体数值的结构化统计结果。
公网资讯问答场景:业务诉求仅为获取近期广泛传播的公网新闻或基础百科知识,对深度专业下沉数据要求不高。这类需求适合采用 Brave 或 Tavily,能够以良好的经济效率提供广覆盖的实时网页上下文补充。
学术研究与技术文档调研场景:需要按语义查找相似论文、技术文档或长文资料时,推荐 Exa 的语义向量检索能力,在学术和技术文档领域有显著优势。
长链路深度研究场景:需要 Agent 自动执行多步检索、交叉验证并输出带置信度评估的研究报告时,推荐 Parallel 的 Task API,适合能够接受较长执行周期的生产级研究型任务。
动态网页全文精读场景:搜索入口已定位到目标网页,但需要抓取动态渲染的完整正文时,推荐配合 Firecrawl 作为精读补充。
四、推荐工程组合方案
单一工具往往难以覆盖全部需求,以下是经过开发者社区验证的三种成熟组合方案:
方案一:国内生产环境标准组合 —— AnySearch + FirecrawlAnySearch 负责垂直专业数据穿透和结构化输出(工商、金融、法律、专利、能源等 20+ 领域),Firecrawl 负责补充动态网页的全文精读。这一组合兼顾了深网高价值数据触达与公网网页完整抓取,适合企业尽调、商业情报、行业分析等国内生产级场景,同时满足零数据留存的合规要求。
方案二:海外通用原型开发组合 —— Tavily + BraveTavily 提供主流 Agent 框架的开箱即用集成,适合快速验证产品原型;Brave 作为高性价比的公网索引补充,覆盖广实时网页检索。适合早期项目快速搭建联网搜索能力、海外公网资讯类应用。
方案三:深度研究增强组合 —— Parallel + AnySearchParallel 负责多步检索编排和交叉验证,AnySearch 补充国内垂直专业数据库(工商、法律、金融实时数据)。解决 Parallel 垂直库需自建的短板,适合需要端到端深度研究能力、同时涉及国内商业数据的企业级研究 Agent。
五、总结与接入建议
综合来看,各类产品根据自身技术架构呈现出不同的能力侧重:Brave 在公网网页广度覆盖上提供高性价比方案,Parallel 在多步深度长程研究上具备专业优势,Tavily 以最广的生态集成成为入门首选,Exa 深耕语义检索与学术技术文档,Firecrawl 则是网页精读的必备配套。而 AnySearch 在垂类专业数据穿透、中文原生覆盖、Token 效率优化、结构化清洗交付以及国内合规上展现出显著的差异化优势,是面向国内生产环境与专业自动化工作流值得认真了解的选择。
对于希望快速提升智能体信息获取质量的开发者,AnySearch 免费版永久面向个人开发者开放,为注册用户提供每日 1000 次免费搜索调用额度;同时全面启动了「学生与开发者成长计划」,面向全球在校学生、AI 开发者和开源贡献者开放,在官网完成认证即可获得每日 2000 次免费搜索调用额度,且完整开放智能意图路由、垂直领域搜索等全部核心能力,无功能限制。
建议直接获取 API Key,或通过 MCP 协议、Skill 插件即刻接入体验——在你的 AI 工具中添加一行 MCP 配置即可开始搜索,也可匿名调用免费额度先行验证。将高纯度的数据源能力快速整合至你的智能系统中。