


每个人心里,或许都藏着一个想要讲出来的故事。但把这个故事写成剧本,却是另一回事。
很多时候,构思一个故事只需要一秒。可真正提笔才知道,全是熬出来的细碎与煎熬。人物设定要立得住,情节要环环相扣,还要遵循行业内严苛的叙事规范。对很多创作者来说,最磨人的功夫,往往就是把脑海中的碎片一点点铺陈成完整的文本,这个过程,远胜过构思故事本身所耗费的心力。
后来AI来了。
所有人都以为,创作的难题终于有了捷径。一句提示,几行指令,瞬息之间,数千文字。创作者开始习惯依赖这种快速的圆满,以为文字的生成,从此再也不用等待,不用煎熬。
可没人说,捷径往往最容易迷路。
普通对话式AI很容易在长文本创作中失控。“写着写着忘了人物设定,前后情节对不上,甚至同一个角色在不同段落里呈现出完全不同的性格。与此同时,千篇一律的‘AI味’、持续调用云端模型带来的成本,以及影视行业对剧本版权和素材安全的敏感。”在影视行业从业多年的胡格这样说。
对胡格而言,她见过很多好故事停在构思阶段,也看到AI带来的效率,以及效率背后逐渐暴露出的创作问题。她清楚,一部好剧本最难的是贯穿始终的人设、逻辑自洽的情节、始终在线的情绪。
那么,既然普通对话式AI总有缺憾,那不如重新定义它的位置。于是,她开始思考,能不能把AI放进原本的影视创作流程里,让它真正参与到人物、情节和文本的推进中。
基于这样的思考,她独立开发出了“星察剧本”,并凭这款应用一举夺得“锐龙AI智能体创新应用大赛AI超级个体组AMD 新锐奖”。
AMD新锐奖得主,“星察剧本”开发者 胡格
01 锐龙 AI Max+ 395 火力全开,Agent驱动“六人剧组”
胡格说:“电影、电视剧都是集体创作的产物,鲜有单枪匹马就能独立完成的先例。”
策划、编剧、制片、统筹,各自都要“把守”着不同的创作维度。这是胡格很早就看清了的行业常识。基于这份专业理解,胡格摒弃了“一句话代写全剧本”的伪需求,转而把专业影视制作流程拆解、重组。
“星察剧本”便是基于这一逻辑设计的。
具体来看,“星察剧本”的六个专职Agent构成了一支完整的AI创作团队,涵盖故事策划、角色设计师、制片人、责任编剧、审稿编辑与制作统筹,能在故事大纲、人物小传、市场定位、三幕结构、分场内容、单场写作等多个创作节点上接力协作。
“它更像是一棵树,而不是一次对话就能生成的线性文本。”胡格用一个生动的比喻,概括了剧本文体的特殊性。
为了不让六个Agent各说各话,星察建立起关联修改+版本库机制,让所有Agent共享同一份全局记忆,包括人物设定、世界观、当前节拍与历次修改。同时,“星察剧本”进一步强化了“制片人”这一统筹角色,用来专门理解用户诉求、拆分任务,并将任务派发给对应的Agent。
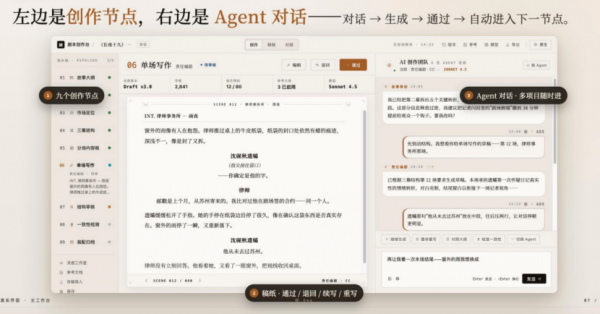
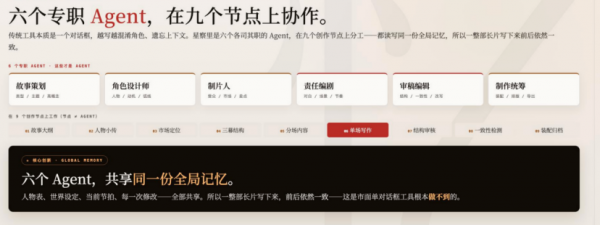
“星察剧本”拥有云端、本地两个版本。
在本地版本上,这类重度依赖多智能体并发、超长文本处理的AI应用,对底层算力的要求极为苛刻。既需要足够大的内存容量,支撑六个Agent同时在线、共享全局记忆,也需要足够高的内存带宽,保证长文本上下文在多轮调用间不卡顿、不掉速。
基于这样的需求,胡格最终把“星察剧本”的底层算力平台,锁定在了搭载AMD锐龙AI Max+ 395的设备上。
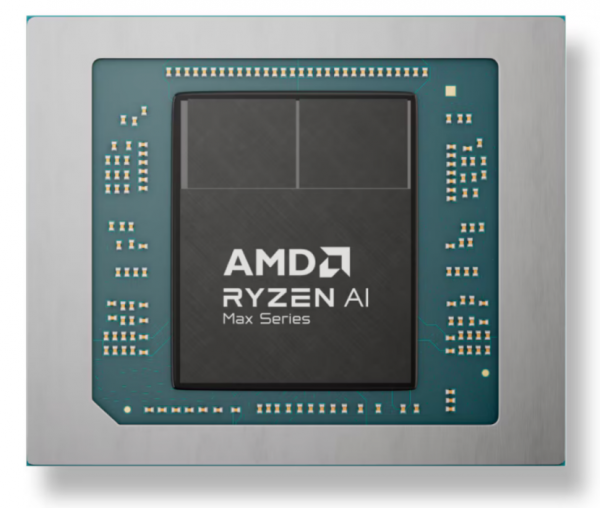
那么,这一算力平台究竟是如何撑起一个“六人数字剧组”的?我们不妨先从最基础的一环:内存容量说起。
事实上,很多人对大模型“长上下文”的理解存在一个普遍的误区,以为只要模型标称支持128K上下文,随便一台电脑都能把它跑满。但其实是,上下文长度往往卡在物理设备的显存容量上。
本地运行大模型时,内存中会同时驻留四类数据:模型权重、当前会话的KV Cache(键值缓存)、推理框架的运行缓冲区,以及操作系统、应用客户端、素材库和其他Agent后台状态所占用的空间。
所以,我们要先算一笔账。
以采用GQA+DeltaNet结构的35B模型为例,假设有40层、2个KV头、每个头128维,KV精度为FP16,那么每个Token的KV Cache大约占用0.02MiB。
据此计算,“星察剧本”处理32K上下文时,仅KV Cache就需要约0.64GiB。等用户导入长篇原著、上下文扩展到128K后,这一占用还会继续增加到约2.56GiB。
而这只是单个上下文的开销,还没有算上六个Agent在复杂流程中同时处理长会话时产生的额外KV Cache。
+DeltaNet3542020.642.56这种程度的应用,就算是市面上顶级消费级独立显卡,也会瞬间“爆显存(OOM)”,导致系统被迫让数据在内存与硬盘之间反复换入换出,模型生成速度随之断崖式下跌。
我们反观“星察剧本”基础设备搭载的AMD锐龙AI Max+ 395,其采用了先进的Chiplet封装设计,基于Zen 5架构的多核心CPU计算模块,与一颗高度集成的I/O Die于同一封装 SoC之中。该SoC Die内部还集成了基于RDNA 3.5 架构的高性能GPU、XDNA 2架构算力高达50 TOPS的NPU以及高带宽统一内存架构,在物理布局与系统架构层面构建出CPU、GPU与NPU深度协同的“三位一体”计算体系。
具体到硬件规格,AMD锐龙AI Max+ 395配备了16个Zen 5 CPU 核心,并集成多达40个RDNA 3.5 计算单元(CU),同时引入了革命性的256-bit四通道超宽内存位宽,配合最高128GB的统一内存架构(UMA),理论内存带宽可达256GB/s。
从效果上看,AMD锐龙AI Max+ 395支持的128GB、256-bit LPDDR5x-8000四通道内存,可通过统一内存架构技术,最高可将 96GB 配置给图形工作负载专用。从平台能力边界配置看,可以加载约128B的4-bit模型,或约32B的FP16满血模型。
这套架构相当于为“星察剧本”这样“大模型权重+长KV Cache+多Agent会话”腾出了极其宽阔的常驻运行空间,系统不必频繁换入换出数据,也不必因为显存不足而被迫压缩剧本的上下文长度。
这也是“星察剧本”实现几十万字原著导入、多轮调用六个Agent共享同一份全局记忆的“底气”所在。
02 16核Zen5 + 40组CU“重磅出击”,一秒“拆书”,全域联动
“装得下”只是及格线,“跑得快”才是决定创作体验的关键。
其实,对于“星察剧本”这样一套长链路AI创作系统来说,剧本越写越长,人物和情节之间的关系越来越复杂,前期积累的参考资料也越来越多,AI每完成一步创作,都需要重新调用和理解此前产生的大量信息。
这种压力在“星察剧本”的几个核心功能中体现得尤其明显。
比如“拆书”。用户导入一部长篇小说后,系统需要先理解原著,再把其中的人物、情节、设定、伏笔等信息提取出来,整理成结构化素材,供后续创作持续调用。在“星察剧本”的Demo中,一部约18.4万字、14章的原著,会被拆解成162条素材。进入正式创作后,这些素材还会继续参与故事大纲、人物小传、三幕结构、分场内容等多个环节。
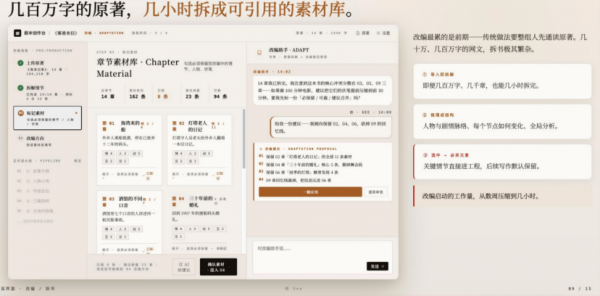
另外,其“一致性检测”和“关联修改”进一步放大了这些需求。
“用户可能只改了一句台词,或者调整了一个人物动机,但系统不能只处理眼前这一处变化,还需要判断是否会影响后续场次、人物关系和整体剧情逻辑,并进一步找到需要同步调整的内容。”胡格强调,所以“星察剧本”设计了跨场联动机制,让修改能够沿着人物、情节和场次之间的关联继续传递。
随着剧本创作不断推进,AI需要处理的上下文也在持续增长。人物、情节、设定、伏笔以及前面各个环节产生的内容,会不断进入后续创作流程。“星察剧本”需要让系统持续调用和理解这些信息,同时保持稳定的响应速度。
而这,恰好是AMD 锐龙 AI Max+ 395最擅长的事。
具体的,我们先看模型理解信息这一步,对应推理链路里的Prefill 阶段。这一阶段,大量矩阵计算同时展开,并行度越高,长文本“读进去”的速度就越快。这正是 Radeon 8060S显卡的用武之地,其40个RDNA 3.5 计算单元,最高频率可达 2.9GHz,可有效拓宽“星察剧本”处理持续累积长文本时的效率上限。
模型在完成理解后,需要将认知转化为完整文本,这就是decode阶段,无论是续写内容还是改写剧本,都需要经过这一核心步骤。
AMD锐龙AI Max+ 395处理器,最高256GB/s的理论内存带宽,正是支撑该阶段高效运行的核心基础。
简单来说,Radeon 8060S在逐字生成剧本内容的过程中,每生成一个token,都需要从内存调取对应的模型权重和创作数据。256GB/s的内存带宽,能保证数据持续、稳定地输送到GPU核心,让字符生成的节奏保持平稳,避免创作过程中忽快忽慢、频繁卡顿的问题。
另一方面,“星察剧本”素材解析、版本比对、全域逻辑校验等前置逻辑与数据调度工作,属于典型的通用计算场景,高度依赖CPU的多线程并行处理能力。即便设备GPU推理性能、内存带宽足够强悍,只要CPU调度吞吐跟不上复杂的前置任务负荷,整条AI创作链路就会出现瓶颈阻塞,导致联动修改失效、流程卡顿、响应延迟。
而AMD锐龙AI Max+ 395的16核32线程Zen 5架构CPU,搭配80MB缓存(16MB L2 + 64MB L3),能够有效承载大批量、高频率的前置调度任务,持续为后续GPU推理输出规整、有序的结构化数据,大幅提升整条多Agent创作链路的吞吐效率。
03 砸碎成本枷锁、铸造数据堡垒、实现Token自由
有了高性能的本地算力,最直接的好处,就是帮创作者卸下成本上的负担。
胡格说:“一般而言,剧本很少能够一次定稿。一句台词的微调,都可能引发后续情节的一连串修改,每改一轮,就要重新进行多轮生成和校验,Token消耗量也会随之不断增加。
这样看来,按照云端API调用模式,修改得越细、轮次越多,Token消耗就越高。而AMD锐龙AI Max+ 395凭借128GB的统一内存,可以让千亿参数的开源模型在端侧部署及运行,创作者不再需要支付云端Token费用。对于剧本这种需要反复推演、修改、校验的创作过程来说,可以放心地反复修改。
况且,本地部署“星察剧本”的价值并不止于降低成本。
对影视行业来说,知识产权和数据安全是更让创作者担心的问题。人物设定、支线大纲、历次修改版本,甚至被放弃的“废稿”,都包含了创作者的核心知识产权。如果调用云端模型,这些内容就不可避免地要上传至云端,安全和产权泄露问题无法得到保证。
“不过,在AMD锐龙AI Max+ 395的本地算力支持下,‘星察剧本’可以在断网状态下运行(前提是模型、向量库、依赖组件,以及授权机制均部署在本地),项目文件、角色素材库,以及完整的上下文记录都留在本地。这样一来,创作者既可以让大模型深入参与创作,又不用把核心内容交给云端。”胡格坦言道。
在下一步升级方面,“星察剧本”也在不断创新。胡格透露,“星察剧本”正逐步拓展AI漫剧、短剧甚至AI视频的专属模块。
而当功能扩展到这一步时,AMD锐龙AI Max+ 395依旧能发挥极大作用。其Radeon 8060S 的40个 RDNA 3.5 计算单元能为本地图像生成、视觉模型和渲染任务提供GPU算力。
此外,XDNA 2 NPU则能承接经过适配、需要持续运行且强调能效的AI工作负载。视觉分析等任务,都存在迁移至 NPU 的空间。与此同时,AMD锐龙AI Max+ 395集成的媒体引擎支持H.264、H.265和AV1 等格式的硬件编解码,可减少视频工作流中部分编解码任务对 CPU 的占用。
04 写在最后
“任何灵感都弥足珍贵。星察帮助你,把所有星光,收集起来。”这是胡格在“星察剧本”的项目愿景里写过的一句话。
对创作者而言,“星察剧本”的价值或许就藏在这里:一个突然闪现的念头、一段刚成形的人物关系、一次临时起意的情节调整。这些稍纵即逝的碎片,都值得被留住,再经过反复打磨、推演和修改,慢慢长成一个完整的故事。
这其中,AI要参与创作从起点到终点的全过程。当测本地能跑动更大参数的模型、装下更长的上下文,多个Agent就能围绕同一部作品持续协作,AI也就能真正接手更具体的创作工作。
当然,这背后离不开AMD锐龙AI Max+ 395撑起的算力基础:128GB统一内存与256GB/s内存带宽,让CPU、GPU、NPU组成的异构算力能够放开手脚运转,为“星察剧本”撑起整个“数字剧组”。