

2025-07-03
苹果团队突破性研究:让AI既能并行思考又能准确编程的神奇模型DiffuCoder
苹果公司联合香港大学开发了DiffuCoder,这是首个采用扩散模型的AI编程助手,能够像人类程序员一样进行全局思考和并行生成代码。该模型通过创新的"耦合GRPO"强化学习算法,在EvalPlus等权威测试中性能提升4....

苹果公司联合香港大学开发了DiffuCoder,这是首个采用扩散模型的AI编程助手,能够像人类程序员一样进行全局思考和并行生成代码。该模型通过创新的"耦合GRPO"强化学习算法,在EvalPlus等权威测试中性能提升4....

阿里巴巴通义实验室的研究团队开发了HumanOmniV2,这是一个能够真正"读懂"人类复杂意图和情感的AI系统。该系统通过改进强化学习方法,让AI在回答问题前必须先全面理解多模态背景信息,解决了现有AI模型忽略重要线索和...

MIT等顶尖院校联合发布的Radial Attention技术,通过模拟自然界能量衰减现象,创新性地解决了AI视频生成中的计算效率问题。该技术将生成速度提升1.9-3.7倍,训练成本降低4.4倍,使AI能够生成4倍长度的...

斯坦福等高校联合研究团队首次开发出能抵御"视觉伪装攻击"的AI图像水印技术PECCAVI。该技术通过识别图片中的"非融化点"并采用多频道频域水印,成功抵御了能完全去除传统水印的最新攻击方式,检测率达92%。研究解决了AI...

微软研究院最新发布的DELT方法革命性地改变了AI训练数据的组织方式,通过给训练样本评分、筛选和重新排序,让AI模型能够循序渐进地学习。这种方法无需增加模型大小或数据量,就能将性能提升1.65%,实现训练效率翻倍,为AI...

卡内基梅隆大学团队通过评估20多个开源推理模型发现,多数在数学推理上表现优异的AI模型无法将优势转移到其他领域。研究揭示训练方法是关键因素:强化学习能在提升数学能力的同时保持通用性,而监督学习虽然数学成绩突出但会造成其他...
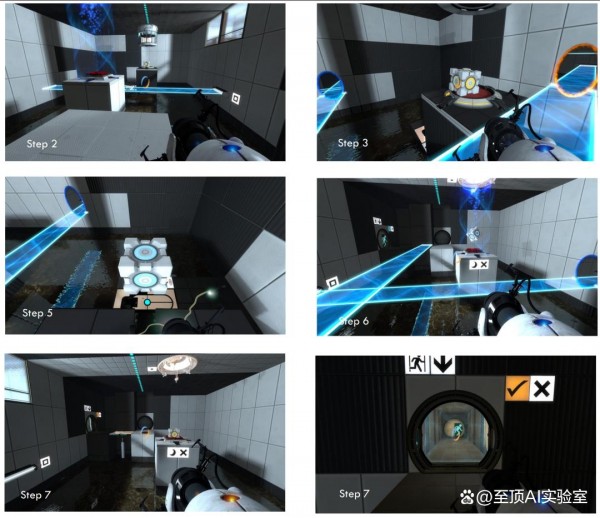
当AI遇到空间推理难题:最新研究揭示GPT-4等顶尖模型在传送门解谜和立体拼图中集体"挂科",复杂智能远比我们想象的更难实现。

这项研究首次系统评估了AI代码智能体在科学研究扩展方面的能力。研究团队设计了包含12个真实研究任务的REXBENCH基准,测试了九个先进AI智能体的表现。结果显示,即使最优秀的智能体成功率也仅为25%,远低于实用化要求,...

俄罗斯莫斯科国立大学研究团队开发出MEMFOF光流估计新方法,在保持顶尖精度的同时将1080p视频分析的GPU内存消耗从8GB降至2GB,实现约4倍内存节省。该方法通过三帧策略、相关性体积优化和高分辨率训练在多个国际基准...

上海交通大学团队开发出毫米级超微相机系统,结合超薄光学镜头和AI图像修复技术,实现了前所未有的紧凑成像能力。该系统通过三路径扩散模型和空间感知修复算法,成功解决了超表面镜头成像质量差的问题,让比芝麻还小的相机也能拍出清晰...

Unbabel团队开发的TOWER+模型系列实现了翻译专业性与通用AI能力的完美平衡。通过创新的四步训练方法,即使2B参数的小模型也能在翻译质量上匹敌70B大模型,同时具备出色的对话和指令跟随能力。研究还创建了IF-MT...

莫斯科科学家开发出"听众机制"训练方法,解决AI视觉偏好判断中推理不一致问题。通过让两个AI模型相互"对话"验证推理过程,新方法在ImageReward基准上达到67.4%准确率,并在现代图像数据集上显著提升泛化能力,为...

瑞士EPFL和ETH研究团队发布MARBLE基准测试,专门评估AI的复杂空间推理能力。测试包含Portal游戏启发的M-Portal和3D拼图M-Cube两大任务,要求AI进行多步骤规划和3D空间组装。结果显示包括GPT...

清华大学团队开发的RoboScape是首个真正懂"物理直觉"的机器人世界模型。通过创新的双分支架构和关键点学习机制,它能够生成既视觉逼真又符合物理定律的机器人操作视频,在多项评估中显著超越现有方法,为机器人智能化发展提供...

北京大学与快手科技联合开发的VMoBA技术成功解决了AI视频生成的效率瓶颈,通过创新的"智能筛选"注意力机制,在提升2.92倍计算速度的同时保持甚至提高了视频质量。该技术专门针对视频数据特点设计了三项核心创新,有望显著降...

阿里巴巴推出Ovis-U1统一多模态模型,仅用36亿参数实现图像理解、文字生成图像、图像编辑三大功能。该模型在多项测试中超越专业模型,证明统一训练能相互促进不同AI能力。研究采用六阶段渐进式训练,创新设计精炼器模块提升性...


新加坡国立大学研究团队开发了SPIRAL框架,通过让AI与自己对弈零和游戏来提升推理能力。实验显示,仅训练AI玩简单扑克游戏就能让其数学推理能力提升8.6%,通用推理提升8.4%,且无需任何数学题目作为训练材料。研究发现...

同济大学团队开发的GIGA-ToF技术通过融合多帧图像的"图结构"信息,创新性地解决了3D相机噪声问题。该技术利用图像间的不变几何关系,结合深度学习和数学优化方法,在合成数据集上实现37.9%的精度提升,并在真实设备上展...

伊利诺伊大学研究团队通过对比实验发现,经过强化学习训练的视觉语言模型虽然表现出"顿悟时刻"现象,但这些自我纠错行为并不能实际提升推理准确率。研究揭示了AI模型存在"生成-验证差距",即生成答案的能力强于验证答案质量的能力...