

2026-10-28
AgSpec:当AI程序员一边写代码一边偷懒抄自己的时候,怎么让它抄得更快
AgSpec让AI编程助手在反复修改代码时学会"抄自己的历史",通过按来源分层建库和按角色动态调整草稿长度,解决检索式推测解码在编程智能体场景下的两大痛点,解码速度最高提升至4.76倍。

AgSpec让AI编程助手在反复修改代码时学会"抄自己的历史",通过按来源分层建库和按角色动态调整草稿长度,解决检索式推测解码在编程智能体场景下的两大痛点,解码速度最高提升至4.76倍。

一项研究提出PyRUA-Lean接口,让机器人AI用Python代码连续执行多个动作并自主判断,减少反复请教AI大脑的次数。在700个模拟任务中,成功率从63.1%提升到71.7%,同时token消耗减少65%,成本降低...

10月28日,国产GPU龙头摩尔线程(688795.SH)发布2026年三季报:Q3营收15.5亿元,创单季新高,同比增长1773.9%;前三季度营收32.9亿元,同比增长319.1%;截至报告期末,近12个月营收40....

10月28日,国产GPU龙头摩尔线程(688795.SH)发布2026年第三季度报告,实现连续高增并提前盈利。报告期内,公司单季营收再创新高,达15.5亿元,同比增长1773.9%,环比增长55.4%。2026年前三季度...

论文提出邻域在线自蒸馏方法,利用老师模型参数附近的扰动专家提供互补监督信号,通过贪心选择和分位数路由机制,在Qwen3系列模型的数学推理任务上显著提升了性能表现。

VTR-Bench是一个系统评测视频生成模型文字渲染能力的基准,覆盖300条提示词和五大场景,发现当前最强模型词错误率仍达0.250,并提出关键帧引导的智能体框架将错误率降低32.5%。
论文提出DMM方法,通过多轮意图通信修正解决多智能体路径规划中独立采样导致的协调失败问题,配合MICPO强化学习微调,在POGEMA和MovingAI基准上超越现有方法,并成功扩展至百万级机器人场景。
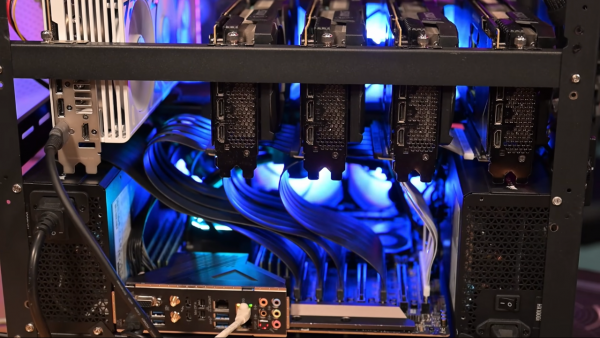
摩尔线程开源大模型训练基础设施 Megatron-MUSA-Titan,基于全功能 GPU,覆盖万卡级集群万亿参数 MoE 模型的预训练与强化学习,含 blockwise FP8、MoE 通信优化、激活卸载与流水线通算重...
视频AI分不清视频是正放还是倒放?研究者发现时序信息在模型中间层产生后逐层衰减,提出无需训练的TAI方法,在峰值层提取信号按衰减曲线回注,显著提升三款主流视频大模型的时序推理能力。
E-MoE提出用混合专家模型自带的路由决策作为离散隐变量,替代扩散语言模型中各位置独立采样导致的分解误差,无需额外参数即可大幅提升少步数生成质量,在LM1B等数据集上验证有效。
本文介绍Multimodal Flow框架及其实例化模型MF-1,一种用流匹配统一建模语言与视觉的全连续生成方法。通过文本图像超块设计、块因果注意力与模态专属前馈网络,MF-1在仅用150B训练词元的情况下,于GenEv...
HPE 将 Networking EdgeConnect 与 HPE Mist、HPE Aruba Central 集成,在统一智能体框架下融合 SASE、有线接入与无线局域网,实现端到端网络可视化。


10 月 6 日晚间,罗格斯大学数论学家 Alex Kontorovich 在纽约国家数学博物馆的晚宴上,一手端着威士忌一手刷手机。OpenAI 刚刚在 GitHub 上放出 722 篇 AI 生成的数学论文。他翻到"准...
这篇论文提出InterEvolve,让人形机器人无需重新训练,通过大模型演化奖励程序并结合执行反馈,复用已有运动能力完成全新接触密集型任务,成功率大幅超越人工设计奖励,并在真实机器人上实现自主部署。
论文提出Memorizon训练方法,让视频世界模型的训练跨度和注意力计算长度解耦,通过按相机共视性检索历史片段组成有界记忆库,使模型能在超出训练窗口的时间跨度上保持场景重访一致性,同时控制训练成本。
机器人常常记不住"自己做过什么",这篇论文设计了HIDE基准专测这种健忘症,并提出SEEK三合一记忆框架,在仿真和真实机械臂实验中显著提升了需要历史信息才能完成的操作任务成功率。