

2026-09-03
现代CUDA工具链实战:六步优化GPU图像处理流水线
本文以图像处理管线为例,系统演示了NVIDIA现代CUDA工具链的使用方法。通过六个递进优化步骤:使用Compute Sanitizer与CCCL API排查越界访问漏洞;引入NVTX标注改善Nsight Systems...

本文以图像处理管线为例,系统演示了NVIDIA现代CUDA工具链的使用方法。通过六个递进优化步骤:使用Compute Sanitizer与CCCL API排查越界访问漏洞;引入NVTX标注改善Nsight Systems...

NVIDIA与CrowdStrike在隔离环境中评估了一套攻防一体的智能体系统。防御侧采用专为网络安全定制的Nemotron模型,结合CrowdStrike SafeMind平台,通过连续攻防循环自动生成并验证检测规则。...

本文提供了一套AI推理GPU资源规模配置与总拥有成本(TCO)优化的实用框架。文章从使用场景出发,涵盖聊天机器人、AI智能体、内容生成和翻译应用等典型场景,详细梳理了模型选择、并发量、延迟指标、缓存命中率等关键配置要素。...

NVIDIA与CrowdStrike在Fal.Con 2026大会上宣布联合推出SafeMind智能体网络安全系统。该系统基于NVIDIA Nemotron开源模型,融合CrowdStrike多年威胁数据进行后训练,构建...

NVIDIA Omniverse NuRec通过重建真实驾驶场景并为目标车辆配置渲染新的摄像头视图,解决了自动驾驶感知栈跨车型适配的难题。该工具基于3D高斯泼溅技术,支持新视角合成与可复用场景数据标注,开发者无需为每款车...

NVIDIA BioNeMo Agent Toolkit与Anthropic的Claude Science科研工作台完成深度集成,实现了基于多序列比对(MSA)的蛋白质结构预测工作流。该工作流通过MSA Search、O...

NVIDIA发布TensorRT Model Connect,旨在简化开源AI模型从检查点到原生C++推理的部署流程。该工具将部署分为两个阶段:首先通过一条命令从Hugging Face模型ID构建部署包,再由原生C++...

阿里巴巴发布Qwen3.8-Flash-Next模型权重,作为Qwen4架构预览版。该模型为多模态混合专家架构,主模型参数量125B,附加51B N-gram嵌入,每token激活6B参数,原生支持262K上下文窗口,可...
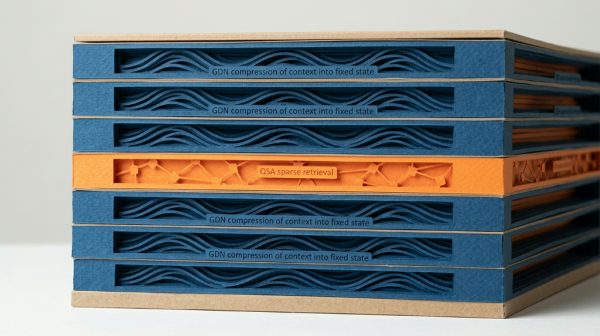
阿里巴巴发布Qwen3.8-Flash-Next模型权重,作为Qwen4架构预览版,该模型为多模态混合专家架构,拥有176B总参数,每个Token激活6B参数,原生支持262K token上下文窗口,可扩展至1M tok...

英伟达发布Jetson Orin Nano 2机器人计算机,面向入门级边缘AI应用。新品在相同外形下推理性能较前代提升2倍,同等性能下功耗降低40%。该产品搭载78 TOPS AI算力、8GB内存及8核Arm CPU,支...

COMPASS是一个统一框架,通过残差强化学习实现跨机器人平台的导航能力迁移。开发者只需定义机器人、场景和导航目标,编码智能体便可自动完成依赖验证、资产准备、烟雾测试、训练启动和检查点评估。以波士顿动力Spot为参考机器...

NVIDIA推出NVLink Fusion与NVHBM技术,为超大规模算力提供商和AI原生企业构建定制加速器提供支撑。NVHBM相比标准HBM4e可提升30%内存带宽、节省高达67%的PHY及支撑区域面积、降低15%内存...

NVIDIA Dynamo推出影子引擎恢复功能(预览版),可在LLM推理引擎进程崩溃时实现秒级恢复。该功能通过GPU内存服务(GMS)将权重生命周期与引擎进程解耦,并预先在同一GPU上保持一个完全初始化的待机引擎。测试显...

NVIDIA随CUDA 13.3发布CUDA Python 1.0,正式将Python列为CUDA平台的一等支持语言。此次发布包含cuda.core 1.0.0(运行时接口)、cuda.compute 1.0.0(并行算...

NVIDIA推出AI网络第五大支柱——Scale-In网络基础设施,以BlueField-4 DPU为核心,联合DOCA软件框架与Spectrum-X以太网,将传统南北向网络演进为统一加速的基础设施域。该架构将安全、多租...

NVIDIA Vera CPU专为智能体AI工厂设计,针对真实智能体任务轨迹的两大特征——长序列依赖链与间歇性并行爆发——实现均衡优化。基于163,594个智能体会话的遥测数据,97%以上的会话呈现独特轨迹,传统多核CP...

NVIDIA Groq 3 LPX是专为Vera Rubin平台设计的交互式AI推理加速器。第三方机构Artificial Analysis在Gemma 4 31B模型上完成首次基准测试,于100K上下文长度下实测输出速...

本文介绍AdaptGrow算法——一种GPU加速的对称非负矩阵分解(SymNMF)方法,可将滚动相关矩阵和尾部依赖矩阵转化为硬聚类标签、软因子载荷及结构突变信号。通过内存优化将峰值存储从约20n?降至4n?字节,单块NV...

本周企业技术领域聚焦AI基础设施建设的现实挑战。英伟达为OpenAI俄亥俄州数据中心提供最高1050亿美元担保,显示芯片厂商正深度介入数据中心融资。宾夕法尼亚州出台新法规,要求超25兆瓦数据中心满足电力供给要求。Anth...

NVIDIA研究项目AVO(智能体变异算子)在ARC-AGI-3公开集全部25个环境中获得100分满分,完成183个关卡,所用环境动作数比VISTA系统少约12%。AVO的核心优势在于持久记忆、监督机制和长期自主运行能力...