
2025-01-17
北航联合美团提出LLaVA-ST!细粒度时空多模态理解的MLLM!
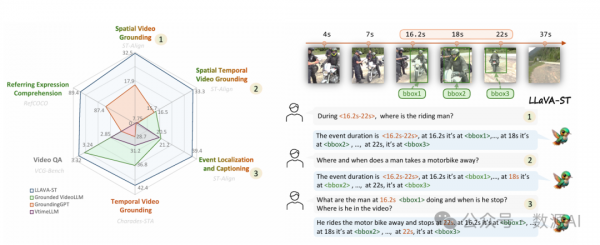
我们将需要基于语言输入处理视觉坐标的任务称为细粒度多模态理解。对于这些任务,当前的MLLMs主要集中在两个方面:有的模型擅长图像中物体的空间定位,但在细粒度时间理解任务上表现不佳;有的模型专门擅长像TVG这样的细粒度时间...

我们将需要基于语言输入处理视觉坐标的任务称为细粒度多模态理解。对于这些任务,当前的MLLMs主要集中在两个方面:有的模型擅长图像中物体的空间定位,但在细粒度时间理解任务上表现不佳;有的模型专门擅长像TVG这样的细粒度时间...