
2025-01-17
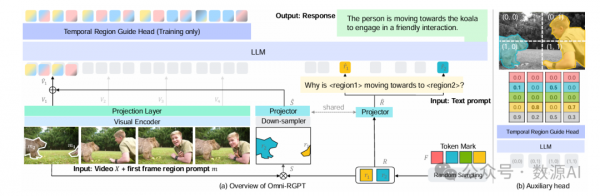
NVIDIA提出多模态大模型Omni-RGPT!Token Mark实现区域级理解!
为了实现图像中的交互式区域特定理解,最近的方法采用了各种策略来表示目标区域:在文本标记中编码文本框坐标,利用视觉 RoI 特征,或应用视觉标记。将这些能力扩展到视频领域,一些方法将初始帧的边界框坐标作为文本形式用于区域级...

为了实现图像中的交互式区域特定理解,最近的方法采用了各种策略来表示目标区域:在文本标记中编码文本框坐标,利用视觉 RoI 特征,或应用视觉标记。将这些能力扩展到视频领域,一些方法将初始帧的边界框坐标作为文本形式用于区域级...
本文提出了一种精心设计的分阶段训练方法,逐步训练大型语言模型以理解视觉和语音信息,最终实现流畅的视觉和语音交互。我们的方法不仅保留了强大的视听能力,而且无需单独的自适应语音识别(ASR)和文本到语音(TTS)模块,就能实...