


作者 | 周雅
来源 | 科技行者
回顾过去这大半年,只要你身处硬件评测或者AI圈子,大概率会被各种各样的“AI PC”实测轰炸。
测得越多,越清楚一个现实:一旦遇到真正需要重负载干活的场景,比如挂载一个上百亿参数的大模型,或者在本地跑一整套多模态视频生成流水线,AI PC的硬件架构容易撞上两堵高墙:
第一堵墙是物理显存容量。第二堵墙是移动场景下的功耗。
有意思的是,今天很多从业者的工作负载也变了,越来越多的人成为 “超级个体”:他们可能是用Agent的开发者、用Blender的内容创作者、玩3A游戏的玩家。以往,这些需求往往对应着不同配置的机器,或者需要在高性能、低功耗、轻薄便携“不可能三角”之间反复取舍。
而这种迫切需求,正是NVIDIA RTX Spark被大家投以高关注的原因。
RTX Spark于今年5月底首次亮相,于近期开启预售。一周前,我们受邀飞到旧金山参加RTX Spark工作坊,这篇文章,我们将深度拆解从现场看到、采访到的一手内容:英伟达在底层硬件上究竟做了哪些取舍?微软为什么要为Agent引入操作系统级的权限与隔离机制?以及,当这样一台可以7×24小时脱机吞吐Token的设备摆在桌边时,它究竟打算怎样改写开发者和专业创作者的生产力逻辑。
另外,我们也是第一时间拿到了顶配版,搭载RTX Spark的Surface Laptop Ultra,采用6144核GPU+ 20核CPU,128GB统一内存+1TB SSD。后续将由我们至顶AI实验室作出进一步评测。
NVIDI为什么开发RTX Spark?
NVIDIA过去二十多年的一条技术路径是:创造GPU、让GPU可编程、推出CUDA,让RT Core负责光追,Tensor Core负责AI运算,RTX逐步把游戏、专业创作和本地AI接到同一套加速计算平台上。NVIDIA将这一整套硬件、软件和开发工具称为RTX Stack。据NVIDIA现场介绍,全球已有约1.5亿台RTX PC。
直到,Agent开始成为新的工作负载。
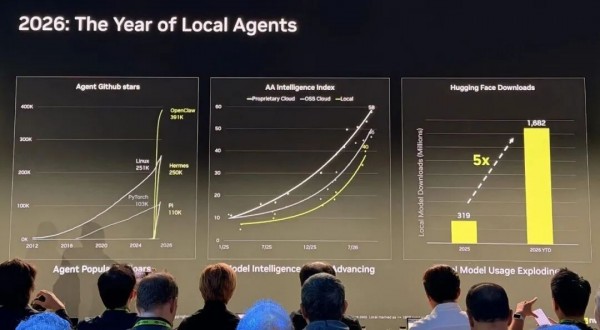
NVIDIA发现当下有三组趋势。如下图,左侧是“Agent项目在GitHub上的关注度迅速上升”;中间是“本地模型与云端模型都在快速进步”;右侧则是“本地模型能力持续攀升”:截至今年10月,Hugging Face上本地AI模型下载量已达到16.82亿次,约为去年同期的5倍。模型变得更有用,用户对它的期待当然更高。
过去,大家打开某个软件,自己一顿操作;而现在,能把一个任务交给Agent,让它读文件、找工具、写代码、生成素材。这里的计算需求,Agent可能要加载很大的模型权重,保留很长的上下文,运行原本就很吃资源的专业应用,关键是,它可能24小时工作,像个不知疲倦的“天选打工仔”。
问题由此出现:如果想在PC上运行大模型、视频生成和持续工作的Agent,是不是必须上强度,要么选择功耗超过千瓦的大型工作站,要么只能把数据和任务交给云端处理?
这正是NVIDIA开发RTX Spark的初衷。
NVIDIA对RTX Spark的定位是“A New Beginning for Windows PCs”( Windows PC的新开端),说法相对宏大,但也直击问题靶心:它试图在一台更轻、更省电的Windows PC里,同时保留RTX的游戏和创作能力,并为本地AI腾出过去普通PC没有的空间。
解构硬件:重新组织CPU、GPU与内存
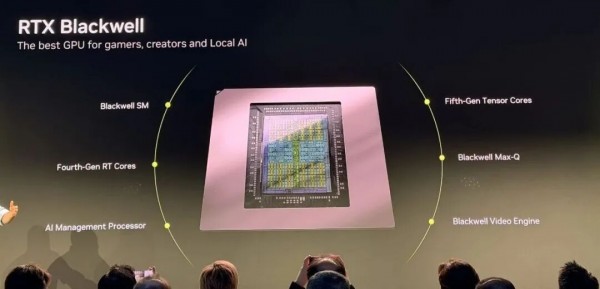
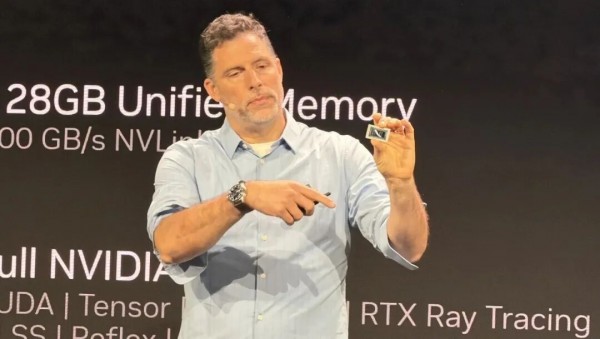
RTX Spark 的核心是叫做N1X Superchip 的高度集成 SoC,将至高可达 6144 个核心的 NVIDIA Blackwell RTX GPU 与20 核的 NVIDIA Grace CPU 结合,并以 600 GB/s 的带宽高速互连。芯片采用双芯粒(Dual-Tile)异构协同设计:一边是GPU计算芯粒,另一边是CPU、I/O与内存芯粒。
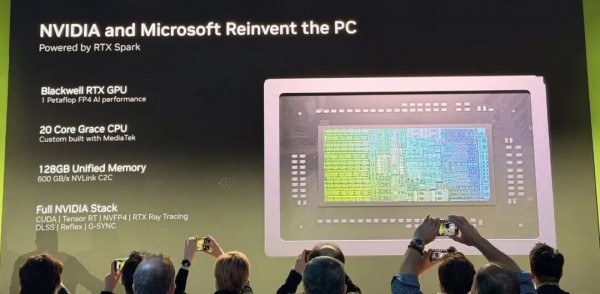
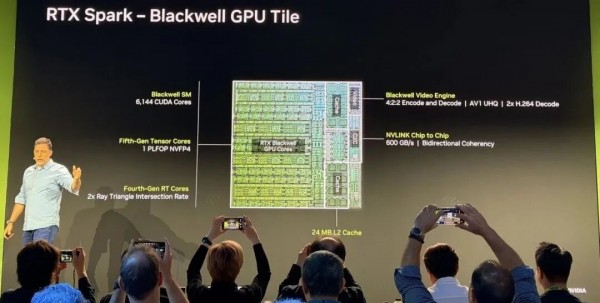
GPU部分配备至高6144个核心的 NVIDIA Blackwell RTX GPU、第五代Tensor Core和第四代RT Core。其中,第五代Tensor Core支持最高1 PetaFLOP的NVFP4 AI计算性能;第四代RT Core,支持光线与三角形求交吞吐量达到上一代的2倍;集成Blackwell视频引擎,支持4:2:2格式视频的硬件编码与解码、AV1 UHQ超高画质编码、以及2倍H.264解码能力,为专业视频创作者护航。
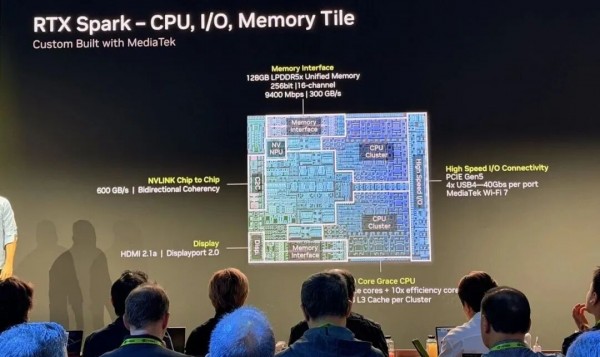
CPU部分采用基于Arm v9.2架构的20核NVIDIA Grace CPU,由10个Cortex-X925性能核与10个Cortex-A725能效核组成。20个核心分为两个CPU集群,每组包含5个性能核心和5个能效核心。这套CPU子系统由NVIDIA与联发科合作定制。
内存部分采用统一内存架构(Unified Memory Architecture),最高支持128 GB LPDDR5X内存,拥有256bit内存接口、16个内存通道,数据传输速率为9400 Mb/s,内存带宽达到300 GB/s。
CPU与GPU共享这一内存空间,并通过NVLink-C2C互联。芯片间互联带宽为600GB/s,并支持双向缓存一致性(Cache Coherency)。通俗地说,当CPU和GPU读写同一份数据时,硬件能够保持数据视图一致,开发者不必总靠软件手动管理拷贝和缓存同步。NVIDIA告诉我们,相比于传统经由PCIe在CPU与独立GPU之间传输数据相比,这条链路可获得约25倍的能效优势。(注意,这里比较的是数据传输能效,不是整台PC的能耗。)
这种设计首先是针对本地模型的“容量问题”。对于大语言模型和多模态模型来说,GPU算得再快,如果显存装不下权重、KV Cache、工作数据,运行时就得频繁转移数据,甚至无法加载某些模型。RTX Spark让CPU和GPU在统一内存池中分配资源,就能做到为大模型、长上下文、多模态模型同时运行提供可能。不过,最高128GB统一内存并不意味着128GB都可无条件留给GPU,Windows和其他应用同样要占用内存,用户可以调整GPU内存预留配置。
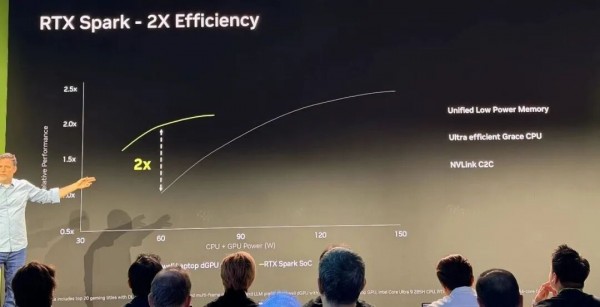
能效是RTX Spark必须证明的事。NVIDIA以RTX 5070独显搭配CPU的组合为参照,称N1X在部分低功耗区间具有约2倍的能效优势。
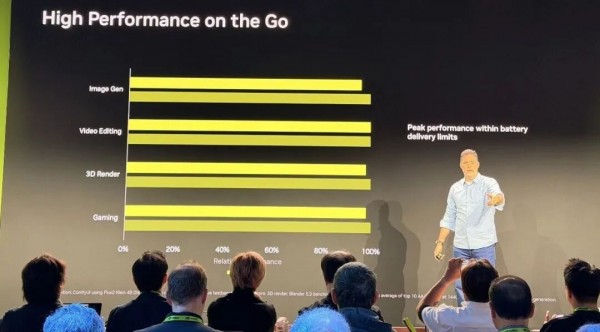
而在移动使用场景下,NVIDIA进一步展示了RTX Spark在电池供电与插电状态下的性能对比。按照现场公布的数据,在游戏、3D渲染、视频剪辑和图像生成等工作负载中,两种供电状态下的性能差异仅约1%,意味着用户不插电时,也能获得接近满载的计算性能。
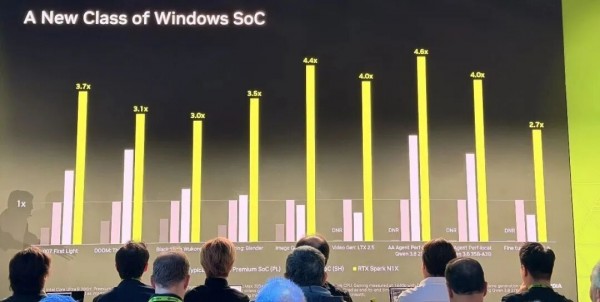
NVIDIA还展示一份性能对比数据,试图说明RTX Spark并不只是一颗面向本地AI推理的处理器。这组测试横跨游戏、内容创作、AI计算等场景。在游戏方面,RTX Spark N1X在《007 First Light》《DOOM: The Dark Ages》和《黑神话:悟空》三款游戏中,分别取得了3.7倍、3.1倍和3.0倍的相对性能表现。内容创作方面,Blender 3D渲染达到3.5倍,AI图像生成达到4.4倍,基于LTX 2.5的视频生成测试达到4.0倍。AI工作负载的差异同样明显,现场展示的Qwen 3.8系列智能体性能测试达到4.6倍,基于Qwen 3.6 35B-A3B的本地智能体性能测试达到4.0倍,模型微调测试则达到2.7倍。
如果仍以游戏作为唯一标准,GeForce RTX独立显卡仍然有自己的位置。NVIDIA发言人在问答里也没有否认这一点:传统GeForce产品继续服务追求极限游戏性能的用户;Spark则把模型容量、移动能效、创作能力和Agent运行放在更关键的位置。所以,它不是原有RTX产品线的一次简单扩容,而是在回答另一种PC需求。
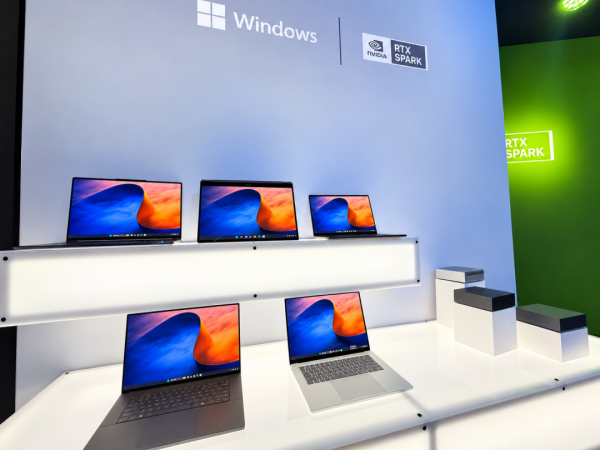
这套平台既会出现在Windows 笔记本电脑中,适合追求可携带的创作与计算能力的用户群体,10月16日上市;它也会进入紧凑型桌面主机,预计11月上市,更适合对Agent有高需求的专业人士。两种形态的差异,实际上对应了本地AI的两个场景:人带着电脑工作,或者电脑留在原处持续替人工作。
目前,宏碁、华硕、戴尔、惠普、联想、微软、微星和技嘉成为首发阵容。售价方面,搭载RTX Spark的Surface Laptop Ultra有两个档位:“较低档”采用5120核GPU+18核CPU,包括三种配置,24GB统一内存+512GB SSD、24 GB统一内存+1TB SSD、32GB统一内存+1TB SSD,售价2599.99美金起(国产售价21988元);“顶配版”采用6144核GPU+ 20核CPU,最高可达128GB统一内存+1TB SSD,售价5899.99美金(国产售价48388元)。
有了硬件,Agent怎样真正成为PC的新用户?
硬件之外,NVIDIA还希望把Agent需要的模型、工具和运行环境一起交付。
一个能合格执行任务的Agent,至少要处理这几个环节:从用户的语言、文件和屏幕获取上下文;由Agent框架组织推理与行动循环;调用语言模型做判断;再通过工具访问Windows应用、文件或外部服务。传统聊天机器人主要是回答问题,Agent则必须在判断之后采取行动。如果缺少后面的工具链,再强的模型也只能停留在聊天框里。
这也是RTX Spark为什么强调“大内存+完整RTX技术栈”的原因。NVIDIA列举了办公、创作、编程和游戏四类场景:Agent可以读取日历与邮件整理计划;调用多款创作软件处理复杂素材;监控GitHub中的Pull Request并尝试修复Bug;在游戏里让AI角色听懂玩家的自然语言要求。它们看似不同,背后却都依赖同一件事:让模型持续理解上下文,再用软件完成操作。
本地AI的价值也在此处凸显。如果处理的是一些敏感数据,比如私人文件、金融资料、尚未公开的视频素材等,把推理放在端侧更安全;如果网络突然中断,本地模型仍可工作;对于频繁运行的工作流,也无需为每次模型推理持续支付云API费用。当然,这并不代表只要使用本地模型,Agent就永远不会联网,譬如搜索网页、调用在线服务时仍会产生云端访问。
针对不同内存容量和本地AI应用需求,NVIDIA展示了两种模型选择。一种是Qwen3.8-Flash-Next,采用MoE架构,1250亿参数,每次推理约激活60亿参数,在特定量化方案下,其运行时内存占用约70GB至80GB;另一种则是NVIDIA专门为RTX Spark本地智能体设计的Nemotron 3.5 Bolt 74B,只有740亿参数,但作为MoE模型,每次推理约激活90亿参数,通过2-bit量化,NVIDIA将模型内存占用降至约24GB。
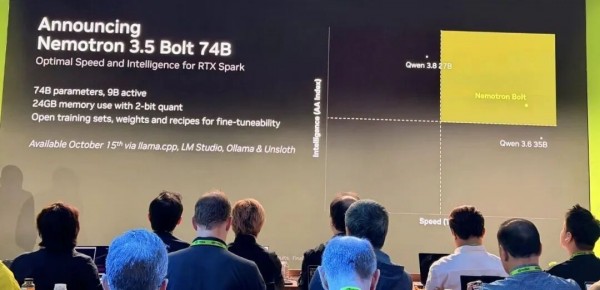
不过,“24GB模型占用”不等于“24GB内存笔记本就能从容运行”。NVIDIA在问答中建议,运行Nemotron 3.5 Bolt 74B更应考虑约48GB或更高的统一内存配置,为系统与其他应用留出余量。Nemotron 3.5 Bolt的意义是,尽量在推理速度和Agent能力之间找到适合端侧部署的平衡,而不是单纯追求参数量。开放权重、训练数据和配方,也让开发者能够针对自己的任务进行调整。
即使本地模型进步很快,也有任务仍需要云端更强的推理能力。于是NVIDIA引入NeMo Switchyard:先尝试让本地模型解决任务,再由Verifier判断结果是否足够可靠,必要时将任务升级到云端。比如,调整图片尺寸一类的简单工具调用可以本地完成,复杂的GPU Kernel优化则可能需要云端模型。这样,用户不必把所有请求都交给最贵的模型,也无需完全放弃云端能力。
NVIDIA还展示了RTX Spark在家庭环境中的两种应用场景,试图把本地AI从个人电脑延伸到整个家庭。第一种是作为持续运行的家庭智能体,RTX Spark连接电视、风扇、窗帘、洗衣机、烘干机、漏水传感器以及庭院喷灌系统等设备。NVIDIA设想,借助本地AI计算能力,这台设备可以长期承担家庭自动化、安全监测、设备维护和家庭日历管理等任务。
第二种场景则涉及整个家庭的算力协作。NVIDIA展示了一个典型的多设备家庭:父亲用RTX Spark笔记本,母亲使用RTX笔记本,儿子使用RTX游戏电脑,女儿用MacBook。虽然这些设备运行不同的操作系统、具有不同的计算能力,但它们可以通过NVIDIA PAIR(Personal AI Router)连接起来,组成一个家庭本地AI计算集群。
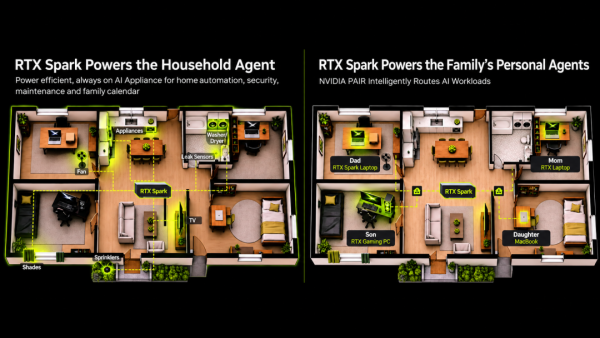
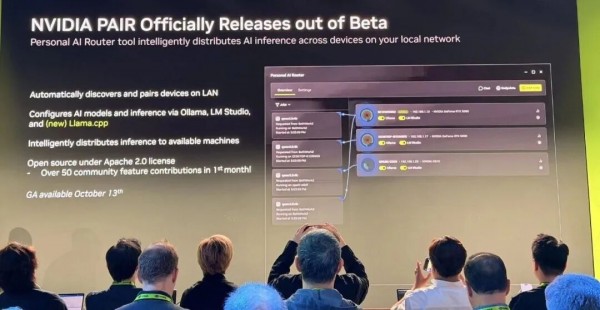
PAIR的主要作用,是根据设备的可用算力、模型部署情况及当前负载,智能分配AI推理请求。例如,当一台电脑正在处理其他任务时,新的推理请求可以被调度到另一台有空闲计算资源的设备,而不必始终集中在某一台机器上。
值得注意的是,PAIR并非把多台电脑的显存拼接成一个更大的显存池,而是让不同设备分别承担独立的推理任务。它同时支持Windows、Linux和macOS,并兼容llama.cpp、Ollama、LM Studio等本地推理引擎。
从“设备能运行一个模型”到“设备能长期提供智能计算”,NVIDIA试图把GPU的使用方式再向前推一步。NVIDIA算了笔账,以每月约6100万个输出Token为例,本地RTX Spark运行指定模型的电费估算约20美元,对照云端Claude Sonnet 5.5 API的估算费用约1200美元。
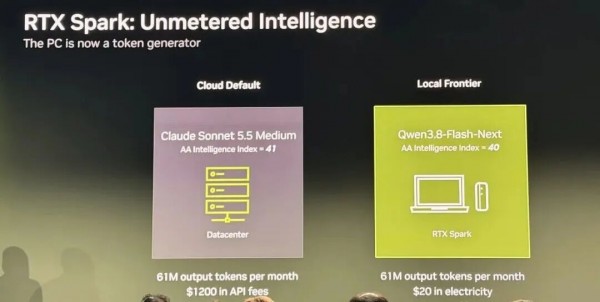
这不是严格的同模型、同质量成本比较,也未计入硬件折旧、利用率和维护,但NVIDIA想强调的概念很清楚:过去衡量PC,常看帧率、渲染速度或跑分,当Agent一天到晚工作,一台电脑还可能被衡量为它持续产生多少有用的Token、完成多少任务。
让Agent碰到Windows应用,微软先要解决权限问题
接下来的难题,是操作系统。Agent如果只能回答问题,PC还是原来的PC;可一旦允许它修改代码、读取文档、打开应用甚至访问网络,谁来规定它到底能动哪些东西?
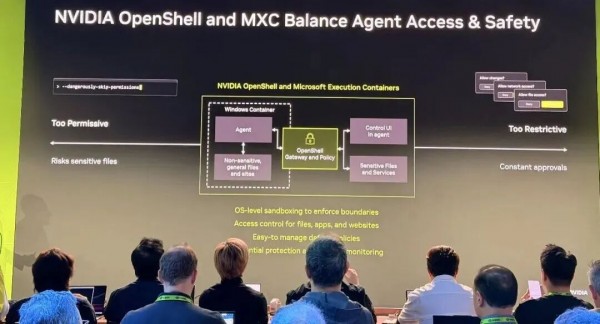
不妨来看两个极端体验:一种是“YOLO”,干脆把所有权限给Agent,祈祷它不要闯祸;另一种则像“Alcatraz”监狱,Agent每做一步都要等你批准。前者不安全,后者又让人不停点击授权。NVIDIA与微软要找的是中间道路:让Agent有足够权限完成真正的工作,但在操作系统层面受到约束。
微软为此带来了Microsoft Execution Containers(MXC)。现场演示中,GitHub Copilot被要求把网页导航改成汉堡菜单,结果由于开发与生产目录权限没有划清,Agent直接修改了生产环境,网站因此出现故障。通过MXC限制读写范围后,Agent只能在允许的测试目录修改文件,其他目录可以设置成只读或不可访问。微软还强调,Agent将拥有独立身份、凭据与运行会话,类似Windows上的一个受限用户,而不是默认继承电脑主人的全部权限。
NVIDIA OpenShell则在MXC提供的隔离环境之外,补充更细粒度的安全治理能力,包括网络访问控制、凭据保护以及面向企业的安全监控。
综上,MXC重点解决Agent在哪里安全运行的问题,OpenShell则进一步管理Agent在运行过程中能够访问什么、执行什么操作。两者分别从执行环境和运行策略两个层面,为Agent提供安全保障。
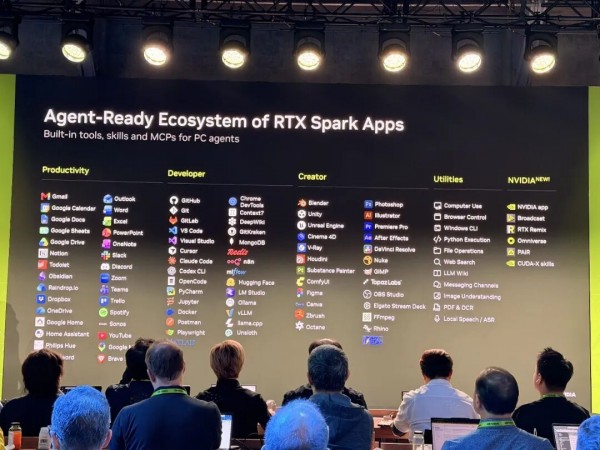
安全之外,还有让普通用户装得上、用得起的问题。NVIDIA与微软正在推动GitHub Copilot、Hermes、OpenClaw、Perplexity等应用更容易调用本地模型,以及通过MCP Server和CLI连接Office、VS Code、GitHub、Docker、Blender、ComfyUI、NVIDIA Broadcast等工具。Windows首轮设置还会向用户提供Agent选择入口,让选择、安装和初始配置尽量变成少量点击,而不是要求先研究推理引擎与一串命令。
微软同时在GitHub Copilot中展示HydraFusion,把本地与云端模型的选择纳入智能路由,并介绍MAI-Code-1.1-Flash的本地量化版本、Windows ML与llama.cpp的适配。模型能够放进电脑只是起点;当用户开始真正把Agent当作工作伙伴时,如何连接应用、管理权限、在本地与云端之间切换,才决定它能不能形成可用的平台。
专业创作先受益:让Agent穿过一整条制作管线
接下来,我们看具体应用。RTX多年来已经参与视频编解码、渲染、AI降噪和各种创作软件加速,它的重要性无需赘述,但创作流程里的另一个问题越来越明显:一项作品往往要经过很多专业工具,创作者有想法,却未必精通每一个软件的全部功能。
这里简单列一条典型工作流:用Photoshop画概念、ZBrush做雕刻、Substance做材质、Blender绑定动画、Unreal Engine布局、Houdini处理特效、V-Ray渲染、Nuke合成、Pro Tools处理声音,最后回到Premiere剪辑与调色。真正耗费时间的,不全是按下“渲染”之后的等待,还有在不同工具、不同专业环节之间不断切换。
RTX Spark想把Agent放到这些工具之间。比如,插画师完成构图后,只需说“让这张图更真实”“改成夜晚”“再换一个机位”,Agent就尝试寻找合适的ComfyUI流程,组合生成模型与后处理工具,并把结果交还给人选择。NVIDIA强调,创作者仍负责判断好坏,Agent负责帮助执行那些不熟悉、但又确实需要的技术步骤。
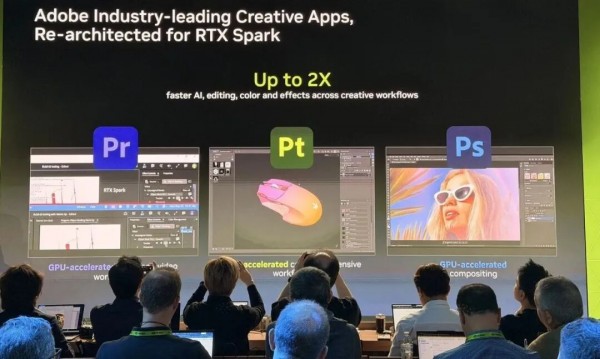
为此,NVIDIA把面向创作者的投入分成三个层次。第一层是已有的RTX创作应用,现场提到超过130款受到加速支持的软件,Adobe还宣布优化Photoshop、Premiere和Substance 3D中的部分AI编辑与特效操作,展示的相关场景最高有约两倍性能提升。在Photoshop演示里,移除工具可以完全在本地处理;高斯模糊、光效可作为独立的非破坏性图层实时调整;更进一步,用户甚至可以要求助手制作一个镜头光晕滤镜,再逐步添加可调节的控件。
第二层是本地生成模型。NVIDIA通过NVFP4等低精度量化技术,进一步降低模型的内存占用。以图像生成模型FLUX.1为例,模型在BF16下需要约23GB内存,经NVFP4量化后可降至约10GB,这意味着,同样一款模型可以用更少的内存运行,为其他AI模型和专业应用腾出更多空间。对于需要反复生成、修改图像和视频的创作者而言,重要的不只是单次生成有多快,还包括一台设备能够容纳多大的模型,以及能否让语言模型、生成模型和专业创作软件协同工作。
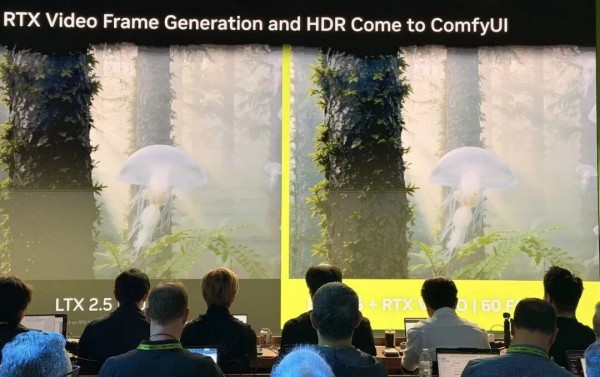
在ComfyUI现场演示中,RTX Video Frame Generation与RTX Video HDR被作为节点加入工作流:原本由LTX-2.5生成的5秒、1080p、30FPS SDR视频,经过帧生成与HDR处理,可得到1080p、60FPS HDR版本,更便于进入后续调色流程。
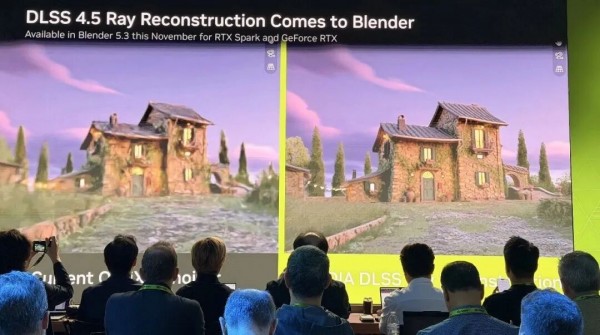
第三层则是帮助人一直留在“可交互”的创作状态。NVIDIA Broadcast增加离线文件处理能力,可针对已经录好的口播清理音频、调整眼神,也能够让Agent通过MCP接口控制部分效果。与此同时,DLSS 4.5 Ray Reconstruction计划进入Blender 5.3的Cycles工作流,让艺术家在调整材质、反射与灯光时更快看清交互式路径追踪效果。对于复杂三维场景,调一次参数就能及时看到可靠预览,可能比最终离线渲染节省几十秒更有用。
开发者面对的,是三套环境能否合成一个工作台
如果说创作者是苦于软件链路太长,开发者面对的往往是环境太多。
常见的开发者工作方式是:一台本地笔记本负责写代码、操控Agent,云端API提供模型推理,另一台带GPU的云虚拟机负责测试与部署。代码、模型、依赖在这些环境之间迁移,本身就消耗精力。
RTX Spark希望把更多步骤留在同一台电脑:开发者可以在Windows编程,通过WSL使用Linux工具,调用CUDA、PyTorch以及本地模型完成测试与实验;必要时再发布到云端。这是Windows on Arm平台的一次重要考验,GPU和统一内存再强,如果常用Python包、编译链、CUDA框架和终端工具无法顺畅使用,开发者仍然会回到原来的环境。
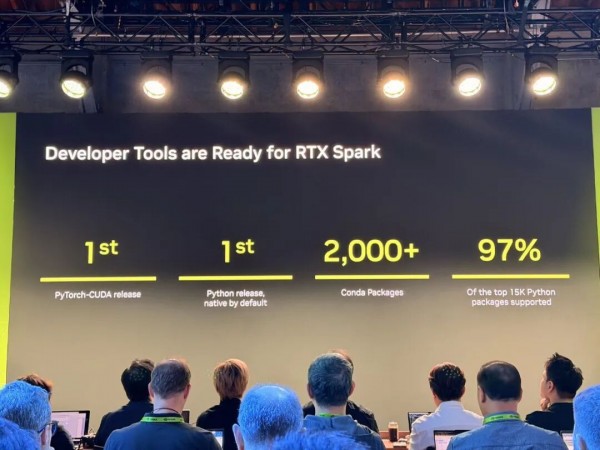
因此,NVIDIA专门强调了软件生态:首批面向Windows on Arm的PyTorch CUDA支持、默认原生的Python,以及超过2000个Conda包;现场称,前1.5万个热门的Python包中已覆盖约97%。NVIDIA还把CUDA-X库的使用方式封装成Skills,让编码Agent能够更方便地调用开发库。
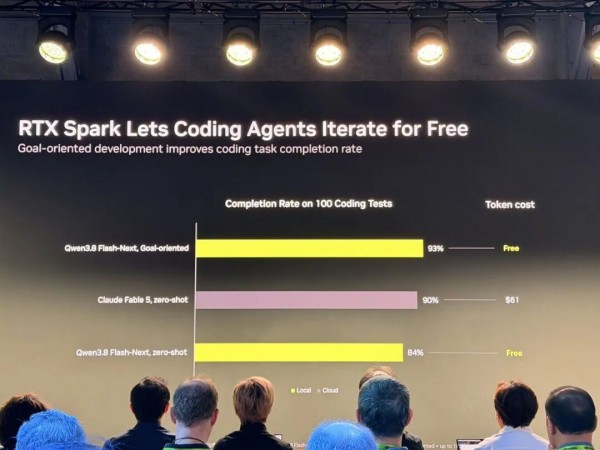
另一个有意思的点是开发模式的变化。NVIDIA提及一个概念叫做 “目标导向编程”:开发者不必把每一步实现路径写死,而是告诉Agent目标和评价标准,允许它持续尝试。现场展示的100项编程测试中,本地Qwen3.8-Flash-Next在允许多轮迭代的方案下,完成率由84%提升至93%。
至于更大团队,NVIDIA还谈到搭载更强算力的DGX Station,带来Windows支持。它与RTX Spark笔记本、小型桌面设备对应不同部署规模:个人开发者在自己的设备上完成主要工作,小团队则需要共享更高算力。这里同样不是简单的产品替代,而是本地计算向不同协作规模延伸。
游戏,仍然考验RTX 的基本功
NVIDIA游戏团队强调,RTX Spark仍然继承Blackwell的RT Core、Tensor Core,以及驱动、DLSS、Reflex和游戏开发者合作体系。对很多专业创作者来说,游戏和创作需求原本就重叠,NVIDIA此前给出的一个现场数据是,使用RTX GPU的创作者中约85%同时也是玩家。
新平台上的游戏能力,一方面来自传统RTX图形栈的延续,另一方面开始加入AI生成式渲染和游戏Agent。以DLSS 5为例,这项技术利用3D引导神经渲染,让游戏画面呈现更丰富的光照、阴影和材质细节,但AI处理画面同样要消耗算力,因此NVIDIA进一步优化了模型与推理流程,使DLSS 5模型的运行速度较此前提升约2倍,模型参数量也减少约24%,降至1.18亿。这次优化仍采用FP8精度。
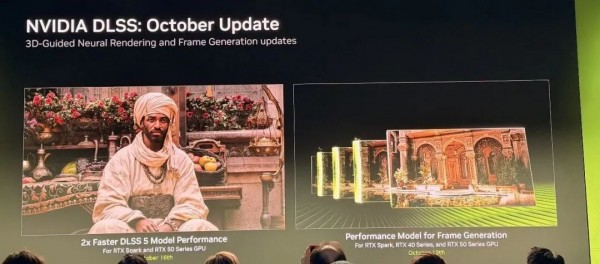
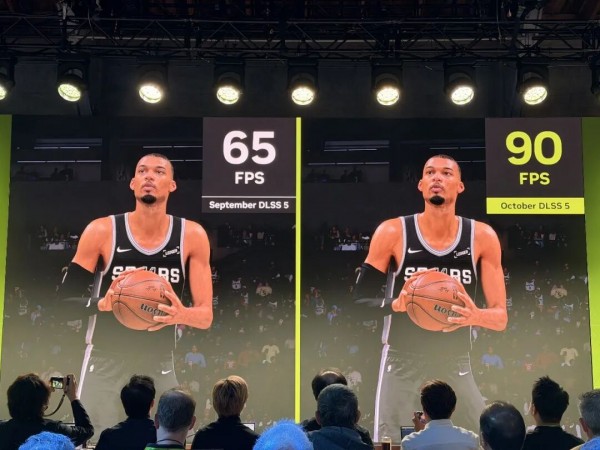
更新后的DLSS 5模型可让《NBA 2K27》在RTX Spark上以1440p分辨率达到约90 FPS,相比此前版本实现约30%的性能提升。此外,NVIDIA还推出新的帧生成模式(Performance Mode),通过简化部分计算,在画质略有取舍的情况下进一步提高帧率。
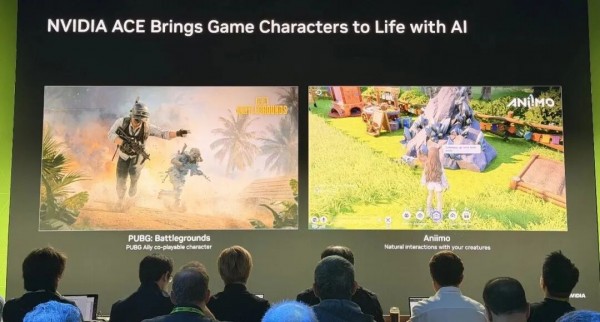
同时,AI还开始改变游戏的交互方式。借助NVIDIA ACE等技术,开发者可以为游戏加入能够理解自然语言、与玩家协作的AI队友或NPC。例如,NVIDIA展示的《PUBG》AI队友和《Aniimo》的AI宠物,就可以通过语音交流协助玩家完成游戏任务。
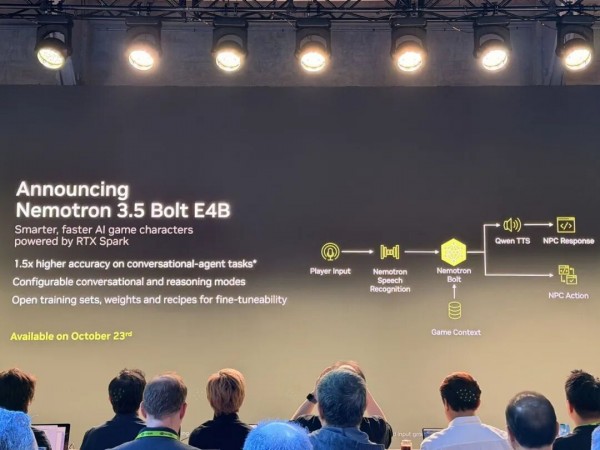
NVIDIA还公布了专门面向NPC的Nemotron 3.5 Bolt E4B,提供可调整的对话与推理模式,让角色能够理解玩家意图并更快决定行动。这里的E4B和前文通用Agent使用的74B Bolt不是同一款模型:前者围绕游戏交互的实时性设计,后者主要面向通用智能体任务。
但新芯片能够运行Windows,并不意味着所有Windows游戏一上市就能顺利运行。原因在于,RTX Spark采用Arm架构,而目前大量Windows游戏仍是为x64架构开发的。微软的Prism可以将这些游戏的CPU指令转换为Arm能够执行的指令,但转换过程可能带来额外的性能开销,不同游戏受到的影响也不一样。游戏中的GPU图形计算则不需要通过Prism进行软件模拟,而是由显卡及相关驱动负责。
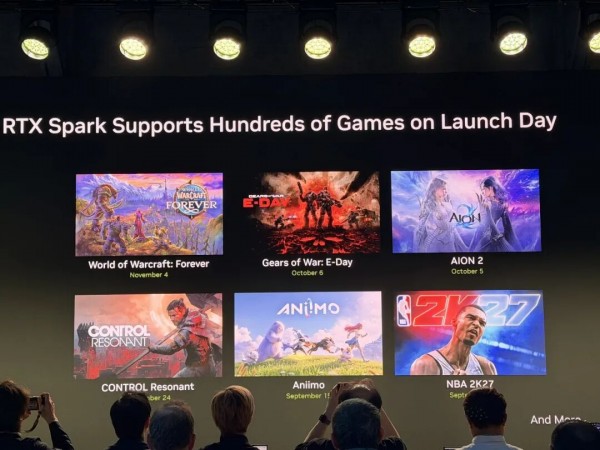
更复杂的是,一些网络游戏使用的内核级反作弊系统,还需要游戏厂商专门适配。现场NVIDIA也明确区分了已经支持和仍在适配中的游戏,部分热门网游还需要等待后续更新。因此,RTX Spark能否提供良好的游戏体验,不仅取决于GPU性能和DLSS技术,还要看驱动、反作弊系统以及游戏厂商的适配进度。
RTX Spark性能,不看广告看疗效
把创作、开发和游戏都放进一台PC,另一个问题自然浮现:我们究竟应该怎样测试它的性能?
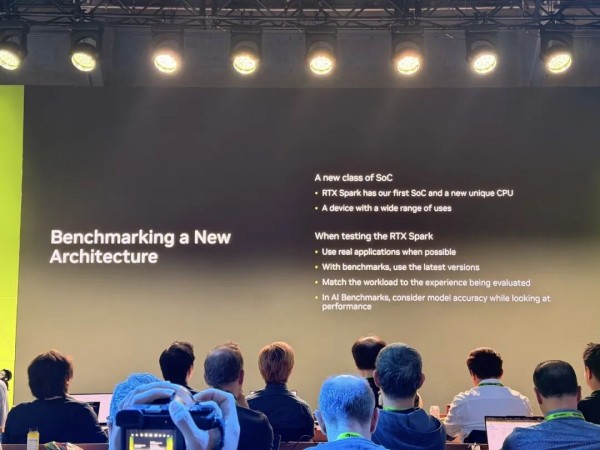
这个问题放到RTX Spark上尤其现实。它既是一颗运行Windows的Arm架构SoC,也有Blackwell GPU和统一内存;既要运行游戏、剪辑和3D创作软件,还希望承担越来越复杂的本地Agent任务。过去分别评价CPU、GPU和AI加速器的办法,未必能完整解释这样一台机器。NVIDIA给出的一条建议是:有真实应用,就优先测真实应用;要用Benchmark,也尽量选最新版,并让测试内容与实际工作负载一致。
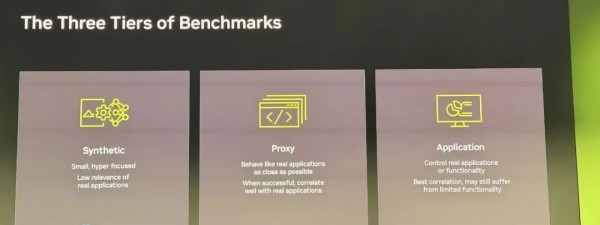
常见测试大致有三类。合成测试(Synthetic)会刻意聚焦某项计算能力,容易重复,却可能离真实使用较远;代理测试(Proxy)不直接打开大型应用,而是构造与其运行方式接近的任务,兼顾效率与相关性;应用测试(Application)则让真实软件执行指定操作,例如调用Photoshop,或者使用软件自带的测试功能。三者都能提供信息,但距离用户真正做事的过程越近,结果通常越容易解释。
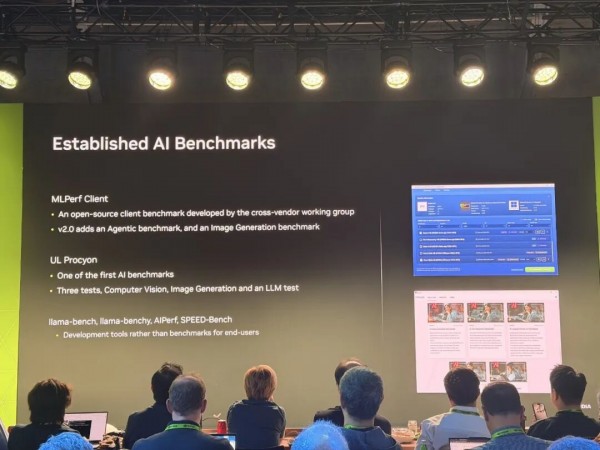
相应的工具也不止一种。MLPerf Client是跨厂商协作的客户端测试体系,2.0版增加了Agentic AI和图像生成项目;UL Procyon覆盖计算机视觉、图像生成和大语言模型。llama-bench、llama-benchy、AIPerf、SPEED-Bench等,则更适合开发者控制模型、输入规模与推理后端,研究特定性能瓶颈。
不过,开发工具跑出的Token/s,并不能自动等同于一个Agent完成真实工作的效率。原因在于,Agent不是一轮问答,用户给它一个目标,它可能先读取文件、搜索资料、调用程序,再把工具返回的结果带回模型继续推理;下一轮又可能生成代码、检查结果,直到完成任务。这种不断在“推理-调用工具”之间往返的过程叫做Agent Loop。工具调用的内容有时很轻,只是列目录或读取文件;有时却很重,可能是在Blender里渲染场景,或者生成一段视频。单独测某一轮模型生成速度,无法覆盖这条链路。
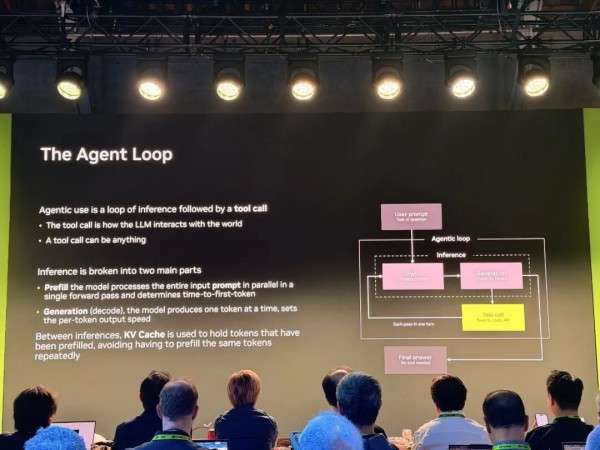
就连一次模型推理,也有两个不同阶段:Prefill是先处理用户输入和已有上下文,可以理解为“把材料读进去”;Generation或Decode则是根据这些内容逐Token生成输出,更像“一个字一个字往下写”。前者通常更偏计算密集,后者在常见自回归模型中更容易受到权重读取和内存带宽影响。两项速度都重要,但对Agent而言,它们在整个任务里所占的时间比例更重要。
如此一来,才更容易理解该怎么测一台“Agent PC”。首先看内存:能放下多大的模型,是否有余量运行创作软件乃至另一套图像、视频生成模型;其次看上下文:Agent每一轮需要处理多少资料,重复输入能否得到有效利用;最后看输出:模型不仅要生成给用户看的答案,还可能生成代码、工具指令和中间推理内容。不同工作流的瓶颈完全可能不同。
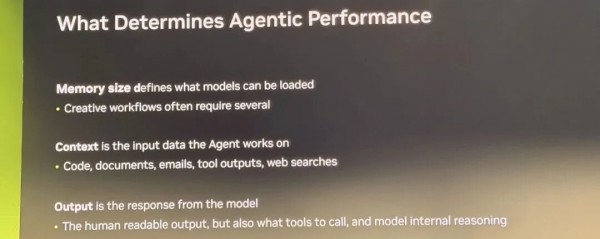
回到传统游戏与创作软件,NVIDIA反对“只跑一个分”。游戏体验至少有三个维度:帧率(FPS)决定画面是否足够流畅,PC Latency关系到玩家操作后多久得到响应,Image Quality则决定画面看起来怎样。三个指标可能互相牵制,尤其开启不同画质选项、超分辨率或帧生成之后,只报一个FPS数字,并不能让读者知道实际玩起来是什么感觉。
创作应用也是类似道理。视频导出、素材导入、3D离线渲染容易计时,当然应该测;可真正花费大量时间的,往往是拖动时间线、预览画面、挪动3D物体、修改材质和光照。导出只需几分钟,不代表此前半天的编辑操作都足够顺畅。好的评测应尽量把这种交互体验写出来,而不是只测最后按下“导出”之后的等待。
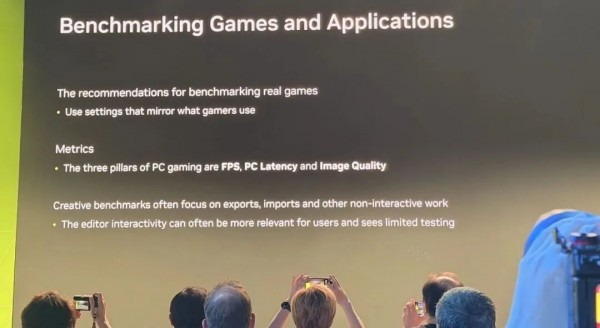
因此,能使用游戏自带Benchmark时,NVIDIA建议先测试真实游戏,并按照玩家实际可能采用的分辨率、画质和功能设置操作。现场列出了多款游戏作为示例,其用意是强调测试要落到实际游玩的场景里。
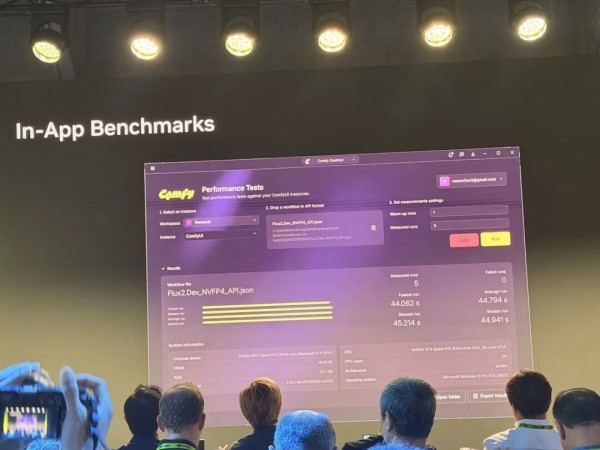
在AI创作一侧,NVIDIA展示了ComfyUI的应用内性能测试。它可以固定工作流文件、模型和节点配置,分别设置预热次数与正式测量次数。下图的FLUX.2工作流先进行1次预热、再测5次,最快一次44.062秒,平均44.794秒。
针对已经成熟的PC工具,现场还给出了一份参考名单:GPU测试可以选择支持新平台的3DMark Speed Way、Steel Nomad,以及带CUDA路径的Geekbench 7.1;创作工作流可以参考Puget Bench的AI与GPU效果测试、ComfyUI的应用内测试;CPU和整机层面则可结合SPEC CPU 2026、Cinebench 2026、Geekbench 7以及模拟Office办公的项目。
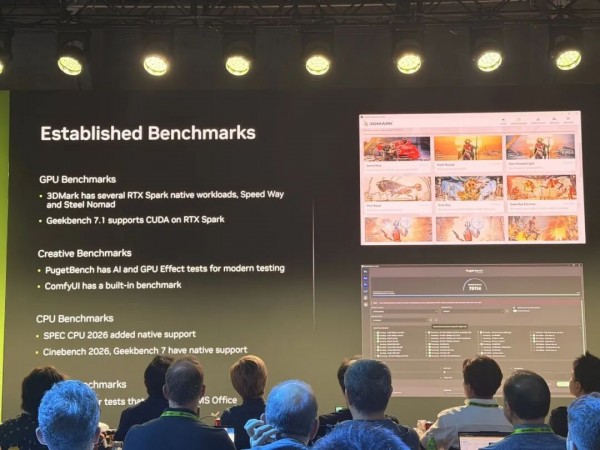
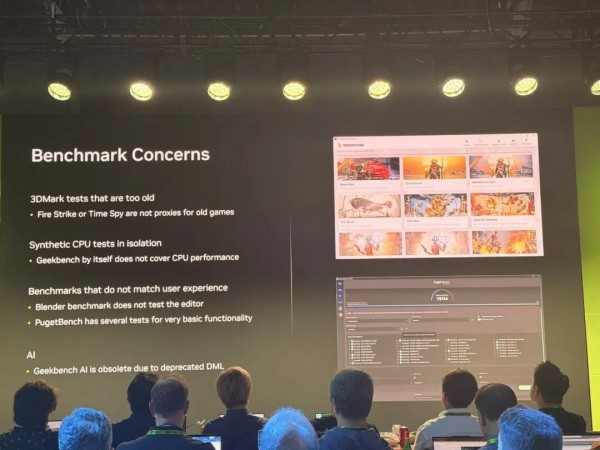
NVIDIA还特意提醒了几类容易造成误读的分数。第一,拿过时的3DMark项目衡量今天的游戏能力,可能已经偏离现代图形负载;第二,孤立引用Geekbench之类的合成CPU成绩,很难推导出具体应用体验;第三,Blender Benchmark主要看离线渲染,不会自动告诉你编辑器操作是否流畅。
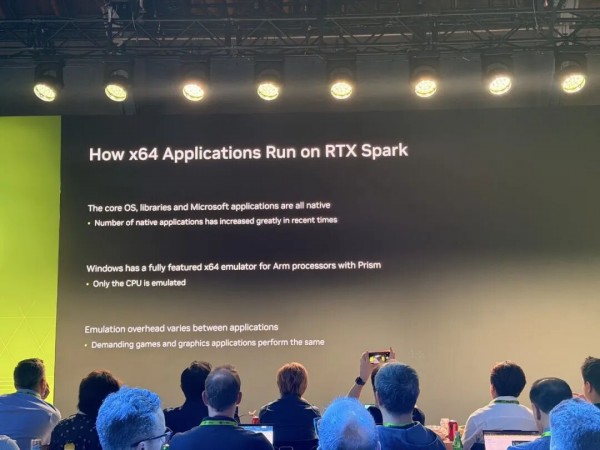
还有一个只在新架构上格外突出的变量:软件是否原生。RTX Spark使用Arm架构,而许多Windows应用与游戏长期面向x64开发。Windows自身和不少常用应用已提供Arm原生版本;没有原生版本的软件,可以借助微软Prism转换CPU指令运行。但Prism并不是把整个GPU也用软件模拟出来,实际图形运算仍由GPU和相应驱动承担。
因此,只有把这些问题放回用户的工作流程,以RTX Spark为代表的其他同类型产品的能力边界才真正看得清楚。
演练一下
我们最后通过一轮Hermes Agent上手演示,来直观感受下Agent的能力。
演示从一件很简单的事情开始:让运行在RTX Spark上的本地Agent,搜索最近有哪些值得关注的开放权重模型和AI智能体。第一次返回的信息太多,演示者便让它缩小时间范围,只关注过去两三周的新进展,最后再从中挑出本周最值得关注的三件事。几轮对话下来,原本普通的信息搜索,就变成了一份符合个人需求的技术简报。
但如果每天都要重新提出这些要求,显然还是麻烦。于是,演示者让Hermes把刚才的工作流程保存为一个名叫“AI Digest”的Skill,以后只要调用这个Skill,Agent就会按照之前确定的方法搜集和整理信息。接着,他又设置了一项自动化任务:每天上午9点,自动生成这份简报。
接下来上难度,演示者把本地RTX Spark评测文件夹和Reviewer’s Guide交给Hermes,让Agent检查Benchmark版本、配置和数据异常。这里出现了一个有意思的小插曲,Agent一开始选错了工具,试图调用浏览器,后来才调整方法,转而读取本地文件。检查之后,它提出了两个值得注意的问题:一批测试数据使用的MLPerf版本与指南要求不一致;另一组测试第一次运行明显比后面几次慢,可能需要确认是否属于预热运行。
不过,发现异常不代表一定出错。演示者并没有直接把这些数据判为无效,而是强调,究竟要不要重新测试、是否应该排除异常值,最终仍然需要评测人员判断。这也是Agent在专业工作中比较实际的价值:它可以帮人检查大量资料,发现容易遗漏的问题,但专业判断仍然掌握在人手里。
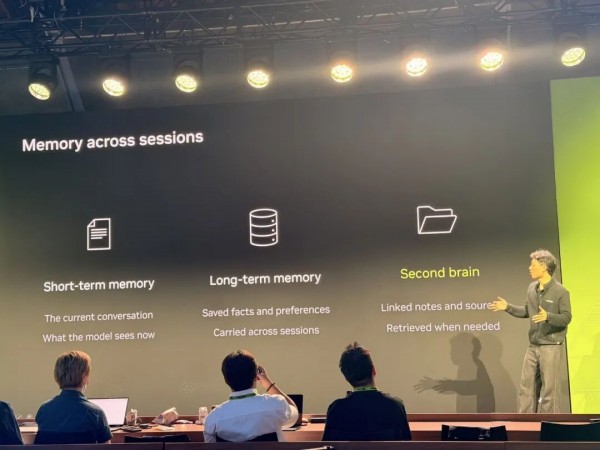
随后,演示者决定暂时停止评测,等重新测试后再继续,他让Hermes记住这个决定,避免下次打开项目时,忘了还有一批数据没有核实。问题来了:如果关闭当前对话,过几天再回来,Agent还能记得之前做过什么吗?
为了回答这个问题,现场展示了Hermes的记忆功能,以及一个叫Second Brain(第二大脑)的个人知识体系。原理是:把过去的评测文章、项目资料、合作联系人、正在进行的工作,整理成保存在本地的文件,再建立索引,让Agent可以根据需要找到相关信息。演示者使用Obsidian展示了这些文件之间的关联。比如,过去评测过哪台电脑,当时找谁借测,是否申请过延期,这些原本可能已经忘记的细节,都可以通过文件记录重新找回来。
回过头看,这段演示其实对RTX Spark的产品思路是一个非常清晰的呈现。这是一套组合拳:RTX Spark硬件提供本地运行AI模型所需要的算力、存储等;MCP、CLI等接口让Agent能够调用应用和工具;Windows系统的权限机制负责限定它能访问哪些资源;Skill、自动化和记忆功能,则让这些能力不再停留于一次性对话,而是可以长期使用。
PC的全称是Personal Computer,个人使用的电脑。但是在AI Agent时代,这个定义也在被改写。“个人使用”不代表一定需要人亲自操作,它可以是一个能够接受目标、执行任务、保留进度的个人计算平台。


