


今年5月,SpaceX星舰迎来第12次试飞,随着超重型助推器上的33台猛禽3发动机同时点火,瞬间释放出8250吨巨大推力,将高达124米的星舰V3火箭推向空中。
4个月后,星舰完成第14次试飞,首次成功进入地球轨道,并将26颗星链V3卫星送入轨道。
SpaceX希望通过火箭重复使用降低发射费用,同时提高单次发射的运载能力。为了将如此庞大的星舰送入太空,SpaceX选择让33台发动机共同提供起飞推力。
当33台发动机同时工作,也带来了一个复杂的工程问题。在火箭底部有限的空间内,每台发动机喷出的高温、高速尾焰都会相互干扰,形成复杂的激波、湍流和压力波动,影响火箭底部的热环境与结构载荷,甚至关系到火箭起飞和回收任务的成败。
多发动机并联火箭尾焰之间的相互干扰,正是“火箭回收复用”工程中必须搞清楚的关键问题。西安交通大学联合中科曙光,基于全国产十万卡AI超集群曙光8000开展射流仿真,研究复杂尾焰之间的相互作用,为商业航天可重复使用火箭研究提供参考。
33台发动机,难在尾焰干扰
近年来SpaceX星舰不断取得进展,国内可重复使用火箭的相关研究也在加快推进。
在预研过程中,结合已有工程经验和国外公开的超重型火箭试验资料,研究团队发现,火箭起飞和回收反推阶段,多发动机并联尾焰相互干扰的精细化仿真数据仍然十分缺乏。
西安交通大学航天航空学院教授、博士生导师,陕西省先进飞行器服役环境与控制重点实验室副主任姬兴用了一个形象的比喻:想象33个高压水枪同时朝一个方向喷水。如果只有一支水枪,水柱的形态相对容易预测,但33支一起开,中间的水柱就被旁边的水柱挤扁、推开、互相撞击,溅起的水花还会往上卷回来。
在超声速射流里的激波、膨胀波和剪切层也是这样,它们在近场互相挤压、反射、交汇、合并,形成一个跨越多个时间和空间尺度、一直在变的三维结构。所以33个喷口,不是简单相加,这正是它最难的地方。
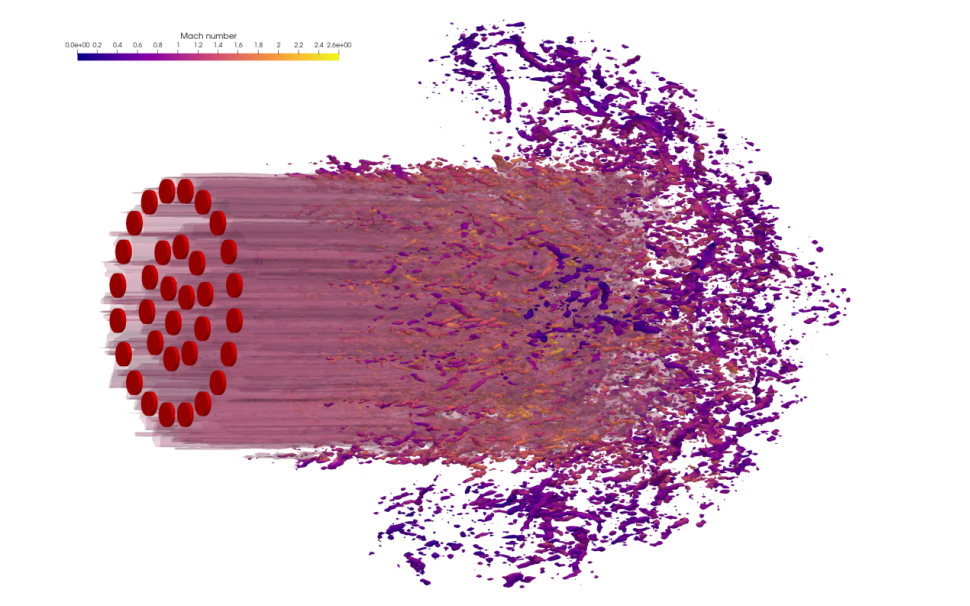
西安交通大学博士生张红将传统试验面临的困难概括为九个字:测不全、抓不住、做不起。
第一,测不全。试验只能在箭体表面布置有限的压力和热流传感器。这就像用几支温度计去量一整片火场,你能读出温度计那几个点的温度,但火场里最烫的那个角落,恰恰很可能就是你没放温度计的地方。多股射流撞击、激波交汇形成的局部高温高压区,位置是算出来的、不是猜出来的,靠布点去碰运气,命中率很低。
第二,抓不住。高速气流产生的压力在每秒能达到几百次甚至上千次地"抖动",脉动压力是结构疲劳和振动的主要来源。要抓住它,就得用高频响、多点同步的测量。但测点一多,传感器本身又会扰动流场,高温、强辐射、稠密激波也给光学测量带来很大限制。
第三,做不起,也做不真。 做不真,是说地面缩比试验很难同时复现真实火箭的尺寸、多机并联的喷口间距、飞行高度上的环境压力和马赫数,这几个条件互相牵制,往往只能保住一两个。做不起,是说多台发动机并联点火,一次试验代价极高、周期很长。
西安交通大学航天航空学院的目标是补上试验给不了的那部分。张红谈到,试验能告诉我们"这里有多热",但很难告诉我们"为什么这里最热、换个排布会不会更糟"。数值模拟能把整个空间"点亮",任意位置、任意时刻、任意切片都能回放,还能一键换个排布重算一遍。
试验负责定标校验,模拟负责扩展和推演。试验得到的是“几个点的曲线”,仿真得到的是“整个空间的电影”,而且要哪个点有哪个点,想回放就回放。通过试验+仿真结合,就能快速迭代出下一代火箭。
这类问题要求算法既抓得住激波这个强间断,又留得住小涡这种低耗散结构,但这两件事又天然矛盾。33喷口又把横向范围和下游距离拉得极大,对网格量的需求一下就到百亿乃至万亿级。
从算力到算法,都需要重新找解法
西安交通大学团队从事相关算法研究已有多年,但始终面临两个问题。一方面,现有通用计算流体力学(CFD)软件难以同时满足超大规模、高精度和复杂流动的仿真需求,需要针对具体场景开发新的算法和软件;另一方面,这类仿真需要庞大的计算资源,对计算平台也提出了很高的要求。
“算法软件要自己做,算力平台要自己找。”姬兴说,这也是团队最后做出的决定。
多发动机尾焰仿真的一个难点,在于流场涉及的空间尺度差异极大。对火箭安全产生影响的激波、剪切层等细微结构,特征尺度可能只有毫米级,但整个尾焰流场却覆盖几十米甚至上百米的范围。要在如此大的空间内准确捕捉这些细微变化,就需要划分极其密集的计算网格,计算量也随之大幅增加。
按照西安交通大学团队的测算,常态化仿真就需要百亿级网格、上百张加速卡参与计算。在这样的量级下,可以批量处理不同飞行工况,将单个工况的计算时间压缩至一天以内。但对于需要获取更精细流场信息的关键工况,计算资源可能需要扩大到万卡级别,这也是西安交通大学团队开展超大规模并行计算验证的重要原因。
同时计算精度也是必须要解决的问题,因为仅靠大网格量,也很难准确还原复杂的流场变化。国产芯片"算力长得比带宽快",跟高阶 CFD 算法"爱跑腿"的老习惯不合。所以西安交通大学团队没有选择学术界和工业界主流的Runge-Kutta(龙格库塔)方法,而是采用单步时空耦合高精度推进方法。
张红打了一个比方:可以把一张加速卡想象成一个厨房,计算单元是厨师,存储数据的空间则是冷库。加速卡的特点是“厨师”数量非常多,但负责从冷库搬运食材的“工人”相对有限。如果每做一道菜都要重新取一次食材,大量厨师就只能等待,无法充分发挥计算能力。
西安交通大学团队希望通过算法优化,尽可能一次取出更多数据,让计算单元能够连续处理任务,同时在计算过程中提前搬运下一批数据。这样既能增加每次数据读取所完成的计算量,也能让数据传输与计算并行进行,减少计算单元的等待时间,从而提高加速卡的整体计算效率。
之前,西安交通大学团队接触过几套GPU架构,并未限定硬件平台。随后通过中科曙光的生态项目接触到国产异构计算平台,双方逐步展开合作。
“我们发现曙光8000的规模、稳定性和国产软件栈,正好能接住我们想做的这件事。”姬兴说道。所以这个项目不是先有机器再找应用,也不是先有算法再找机器,是重大工程的需求、国产算力的能力、和西安交通大学团队多年的算法积累,三件事在同一个时间点撞上了。
近10万张卡,同时运行的难点在哪里
依托曙光8000异构计算平台,西安交通大学团队完成了算法开发与万卡级应用验证,主要实践包括:算法-硬件协同设计、MPI+HIP异构并行实现、大规模工程算例等。
最终在数万张国产GPU上实现了6.774万亿网格、99.01%弱扩展效率、强扩展效率73.00%、吞吐率34.029 TCUPS。标志着国产异构计算平台上的高阶格式CFD软件首次进入十万卡级,整体并行规模与弱扩展效率达到国内领先水平。
项目中的计算任务挑战不仅在于单个节点,真正的难点在于如何让数万张GPU长时间高效协同运行。首先是超大规模计算资源的组织和调度。需要把海量计算任务合理分配到不同计算节点和GPU上,同时结合系统的CPU、内存和网络拓扑进行资源映射,尽量避免资源空闲和负载不均,让整个系统形成一个高效的计算整体。
第二是大规模通信和数据交换。当计算规模扩大到数万张GPU以后,通信和同步会成为影响整体效率的重要因素。需要结合应用的通信特征和曙光8000的网络拓扑,对进程布局、通信路径和数据交换进行优化,并尽可能实现计算与通信重叠,减少大规模并行带来的等待。
第三是超大规模运行的稳定性和可扩展性。几万张卡同时参与计算,对系统的软件栈、通信网络、资源管理以及运行环境都提出了很高要求。中科曙光通过逐级扩展验证,对计算、通信、网络和资源利用情况进行持续监测和优化,确保应用不仅能够扩展到这个规模,而且能够稳定运行。
这也是超大规模异构计算区别于传统高性能计算的重要地方,随着规模不断扩大,性能优化已经不再是单一GPU或者单个计算节点的问题,需要从应用、计算节点、通信网络到整机系统进行整体协同优化。
中科曙光围绕算力资源、软件运行环境、整机规模验证、专业技术支撑几个方面开展了相应的工作。
首先,在算力资源方面,依托曙光8000提供大规模国产异构算力,为应用开展数万张GPU规模的科学计算提供稳定的算力基础。
其次,在软件运行环境方面,中科曙光结合应用特点提供相应的国产软硬件协同运行环境,从编译、运行时、数学库、通信库到作业调度等多个层面进行适配和优化,帮助应用充分利用曙光8000的计算、存储和网络资源。
第三,在整机规模应用验证方面,重点关注应用从小规模运行向数千卡、数万卡规模扩展过程中出现的性能和稳定性问题。通过不同计算规模下的测试和分析,持续优化计算、通信以及资源调度等环节,验证应用在超大规模场景下的扩展能力和整体运行效率。
此外,中科曙光还组织了覆盖硬件、系统软件、并行计算、通信、存储、应用优化等方向的专业技术团队,与应用研发团队进行联合攻关。
中科曙光研发工程师梁超表示,中科曙光在这项工作中不仅是提供算力,更希望发挥“算力底座+软件环境+规模验证+专业技术服务”的综合能力,与应用团队共同把这套系统真正用起来、跑起来,并进一步发挥超大规模国产算力的应用价值。
曙光8000取得的成果,标志着“研”和“算”的里程碑式节点,接下来的重头戏是“智”和“用”。随着商业航天等领域对高精度仿真的需求不断增加,拥有数万张加速卡只是基础,如何让这些算力在实际科研和任务中高效运行,还需要持续解题。


