


智能体带来的一个很明显的变化,就是上下文变得更长、更连续。
AI Coding是一个典型场景,随着工程规模扩大,一个任务涉及的代码、文档和历史交互越来越多,上下文很容易达到几十兆甚至上百兆。
中科曙光集中式存储产品部总经理郭照斌提到,在这种情况下,如果KV Cache不能及时卸载并在后续推理中复用,即使GPU算力足够强,也会因为大量重复计算影响Token输出效率。
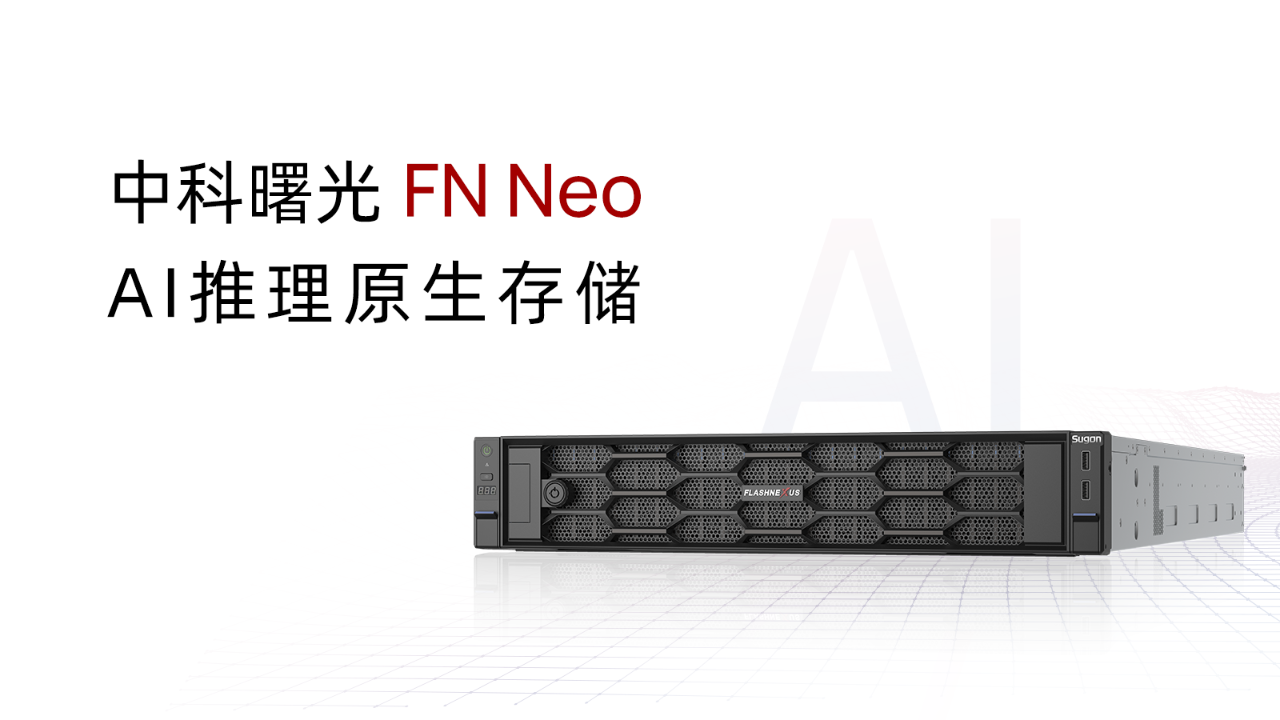
针对推理过程中出现的这些新需求,中科曙光在2026年CCF全国信息存储技术学术会议上发布了全新迭代升级的AI推理原生存储FN Neo。与传统集中式存储更多承载数据库、虚拟化和文件共享等通用业务相比,FN Neo将KV Cache纳入存储管理范围,希望用一套存储承载中小规模私有化推理中的多类数据。
推理变长之后,集中式存储还能不能用
推理过程中需要处理的也不只有KV Cache,模型参数、Agent运行的容器环境以及共享数据,都在使用不同层级的存储资源。
郭照斌提到,从HBM、内存到后端外置存储,存储在推理过程中的使用越来越多。对企业来说,如果不同类型的数据分别配置不同的存储设备,成本也会跟着增加。
集中式存储需要经过网络访问,距离GPU也比本地盘更远,传统NAS、SAN的协议路径又相对较长,在追求低延迟的推理场景中,很容易被认为不够合适。
“无论是大规模共享集群,还是中小规模算力集群,后端采用什么硬件形态只是其中一个因素,协议处理能力、横向和纵向扩展能力,以及能不能支撑共享访问,同样会影响使用效果。”郭照斌说道。
本地盘位于计算节点内部,访问时不需要经过外部存储网络,因此通常具有更短的数据访问路径。FN Neo选择直接提供KV原生语义,希望减少中间环节,同时利用集中式存储的共享能力,让多个计算节点访问同一套后端存储。
集中式存储过去存的主要是文件和数据库,到了AI推理阶段,KV Cache也开始进入共享存储。它会被反复写入、读取和复用,对延迟的要求也更高。FN Neo把KV语义直接放到存储侧,目的就是让这条访问链路更短。
集中式存储做推理,四道关要过
FN Neo在多协议、高性能、高可靠和可扩展四方面进行了面向AI推理的深度优化。
要让集中式存储真正进入推理链路,KV Cache的访问路径首先得缩短。FN Neo从统一存储池直接提供KV、SAN和NAS三种原生协议,减少中间协议和数据转换。
郭照斌多次提到“原生直出”。协议层级越多,数据经过的路径越长,延迟也越难控制。三种协议共用底层CPU、内存、网络和NVMe资源,存储空间也可以在不同业务之间调度。
为了减少共享资源带来的争用,中科曙光还在FN Neo中使用了“超级隧道”技术。
“超级隧道”首先解决的是硬件资源竞争。资源共享虽然提高了调度灵活性,但内存、网络、硬盘等硬件资源本身有限。多个协议同时运行,或者单一协议下出现大量并发请求时,如果缺少统一规划,请求很容易集中到某个节点、网卡或硬盘,形成热点。“超级隧道”以CPU核心为中心,把邻近的内存、网络和硬盘资源组织成相对独立的资源通道,并将存储阵列和CPU核心划分到不同的资源线上,先从底层减少不同任务之间的资源争抢。
另一类解决的是软件上的竞争。为了保证运行逻辑和数据语义的正确性,传统软件通常需要通过锁机制协调不同任务,但由此也会带来排队,时延难以预测。“超级隧道”通过绕开部分操作系统路径,自定义内存管理和协程机制,并引入无锁设计、原生语义处理和看板机制,减少软件层面的等待。再叠加XNIO、XDIO等零拷贝能力,缩短整个数据通路。
基于这套架构,新的协议和语义能力可以直接叠加到现有通路上。比如要支持文件协议,就增加一个处理文件的微服务;要支持KV原生语义,就增加一个处理KV操作的微服务。其他底层能力仍然依托“超级隧道”,这样既能保持资源调度的灵活性,也能减少新增协议对整体性能的影响。
除了资源划分外,FN Neo还通过三级负载均衡,对整个数据链路进行统一调度。无论一个卷承载的是文件、块,还是KV原生语义,都可以把请求分散到整个阵列,充分利用底层资源。用户只需要定义一个卷,就可以调用整个阵列的性能,不需要为了提高并行度再人为拆分多个卷、分别进行并发操作。
在可靠性方面,FN Neo也继承了FlashNexus全闪阵列已有的能力,包括控制器故障保护、硬盘故障及多盘同时故障保护,以及慢盘的自动检测和隔离。同时,系统对硬盘的状态监控、管理和运维进行统一管控,尽量把底层硬件故障对上层业务的影响降到最低。
最后可扩展性方面,为了适应推理算力和存储需求的变化,FN Neo支持大规模扩展,控制器最多可以扩展到1024个,面向数据中心级的大规模推理应用。扩展分为纵向和横向两种方式。如果只是容量不足,可以直接增加不带CPU的硬盘框,以更低成本扩充存储容量。如果性能和容量都需要提升,则可以增加控制框,相当于新增一套完整的FN Neo,实现性能和容量同步扩展。
智能体推理全场景,一套存储怎么支撑
FN Neo支撑推理场景,要先从原生KV语义说起。当前一种常见做法,是通过文件系统接口完成KV Cache的回读和回写,但文件系统本身有一套完整的协议和语义要求,数据在进入KV Cache读写链路之前,还要经过相应的文件操作。相比之下,KV原生语义直接面向KV Cache的读写需求,中间环节更少,协议路径也更短。
这种差别最终会体现在访问效率上。对于KV Cache来说,读写本身并不复杂,影响性能的一个重要因素是中间经过了多少层协议、多少次数据处理。FN Neo由存储侧直接提供KV能力,省去部分文件系统操作和协议转换,减少访问时延和回读、回写开销。
FN Neo还结合了GPU访问后端存储的GDR能力,并结合“超级隧道”的零拷贝技术,让数据尽量减少在CPU、内存和存储之间的反复搬运。这样GPU可以更直接地访问后端存储,KV Cache在GPU和存储之间的流转路径也进一步缩短。
在KV原生能力之外,FN Neo还针对元数据和空间管理做了优化。通过高效的空间管理机制,KV相关元数据可以尽可能保留在缓存中,再配合基于Cache Line的检索加速技术,一次KV定位到具体存储位置的时间可以控制在300ns以内。郭照斌提到,这样一来,KV查找本身在回读、查询和回写链路中的开销被进一步压低,尽量避免检索过程成为新的性能瓶颈。
KV原生协议除了可以适配曙光近期发布的ParaCache高效管理解决方案,还能够与LMCache、HiCache等大模型缓存组件对接,也可以作为Mooncake的KV后端,直接提供KV原生语义和相关能力。客户端采用全用户态组件,对计算节点上的上层应用改动较小,也降低了接入现有推理系统的复杂度。
从测试结果来看,在单节点8卡的计算环境下,使用DeepSeek-R1模型时,开启FN Neo的KV Cache卸载能力后,不同上下文长度下的性能可以提升7-12倍。扩展到多节点场景,在两个节点、每节点8卡的集群中,使用千问2.5模型进行测试,开启KV Cache卸载后的性能相比未卸载也有6-10倍提升。
FN Neo还可以在多个计算节点之间提供共享NAS存储能力。相比每个节点各自使用本地盘的文件系统,共享存储既能提高空间利用率,也能提升单卷访问能力。郭照斌介绍,本地盘的访问带宽通常受单盘能力限制,大约在7GB/s到10GB/s。FN Neo的单卷文件系统带宽可达到70GB/s,块协议单卷带宽则可达到160GB/s,单卷访问能力相比单盘提升10倍以上。
比如10个计算节点如果都使用本地盘,每个节点都要保存一份相同的模型数据,相当于额外存了9份副本。采用共享存储后,模型数据只需要保存一份,就可以供多个计算节点共同访问。
除了NAS协议,FN Neo还提供原生块协议,用于支持推理过程中常见的向量数据库场景。对于实时向量数据库这类对访问延迟要求较高的应用,可以通过块存储提供低延迟的数据访问能力。另外Docker镜像可以按需从共享存储池中划分空间,不需要再为这类数据单独准备一套存储资源。
FN Neo还提供独享卷和共享卷两种访问方式。推理过程中产生的临时文件、模型文件等中间数据,可以通过存储端API按需写入FN Neo。对于lustre、GPFS、BeeGFS等开源并行文件系统,它也可以作为后端存储底座,承载元数据和共享数据,并在上层提供Posix语义,用来满足超节点和容器环境下的存储需求。
写在最后
存储一直跟着计算和应用变化,FN Neo也是在推理负载发生变化之后,对原有集中式存储做出的调整。
FN Neo具备两大特质:一方面,用一套存储承载KV Cache、NAS和块存储等多类推理需求,尽量降低中小规模私有化部署的起步成本;另一方面,随着算力集群扩大,再通过横向和纵向扩展继续增加容量和性能。
FN Neo想解决的,就是让这套存储既能从中小规模推理起步,并随集群规模扩大增加容量和性能。


