


作者 |Don
来源 | 至顶AI实验室
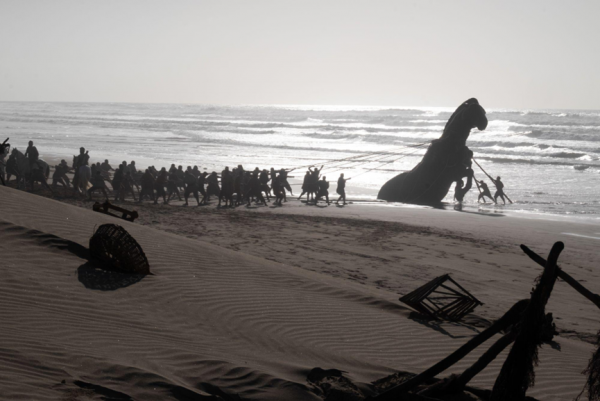
前段时间,《盗梦空间》《星际穿越》《蝙蝠侠》系列的科幻导演克里斯托弗·诺兰,将镜头对准了古希腊史诗,拍摄了新电影《奥德赛》。这一次,他重新讲述了一个流传几千年的故事:特洛伊木马。
诺兰镜头中的木马,跟我们以前印象里直接从门口被推进城门不同。它半沉在海滩的沙土和浅水中,像被海浪冲上岸的一件战利品。特洛伊人把它拖进城里,不知道里面藏着一支等待行动的军队。
电影还特别把镜头带进了木马内部:狭小的空间挤满了士兵,空气闷热,身体紧贴,所有人都必须保持安静,等待打开城门的时刻。
特洛伊城拥有坚固的城墙和守卫,最终因为主动收下一个看似无害的礼物而陷落。
本地AI经常强调安全和隐私,但是Jorge Marfil的视频却说,本地AI并不完全安全。几千年过去了,木马的形态发生了变化,类似理所当然的大意还在。
此时此刻,我们正在把一些同样看起来无害的东西装进自己的电脑,可能是一个下载量数十万的开源模型、一份配置文件,或者一个功能强大的 AI Agent 插件。
这些无害的东西,跟能够读取文件、执行命令、访问网络的 Agent 结合起来之后,新的安全风险就可能悄然出现了。
这一次,特洛伊木马里藏着的,不再是一支军队,而可能是一段指令。
本地部署,真的意味着安全吗?
过去一年,本地大模型逐渐成为 AI 开发者和技术爱好者的重要选择。
原因很简单:模型运行在自己的电脑上,数据不必发送给第三方服务商,模型版本由自己控制。从隐私保护的角度看,这确实是一个合理的选择。
但我们很容易混淆两个问题:数据有没有离开自己的电脑,以及别人能不能通过某种方式控制自己的电脑。
前者是数据隐私,后者是系统安全。
一个 GGUF 模型文件,本质上主要由神经网络权重构成,并不是一个能够直接执行命令的程序。Ollama 等运行器默认也可以只监听本机地址 127.0.0.1。
然而,为了让模型更好用,我们会下载别人微调的模型,安装新的运行器,连接插件和 MCP 服务;为了让 AI 帮助写代码,我们开放项目目录,甚至允许 Agent 执行终端命令、读取文件和访问互联网。
一个原本只能聊天的模型,逐渐变成了能够操作电脑的智能体。
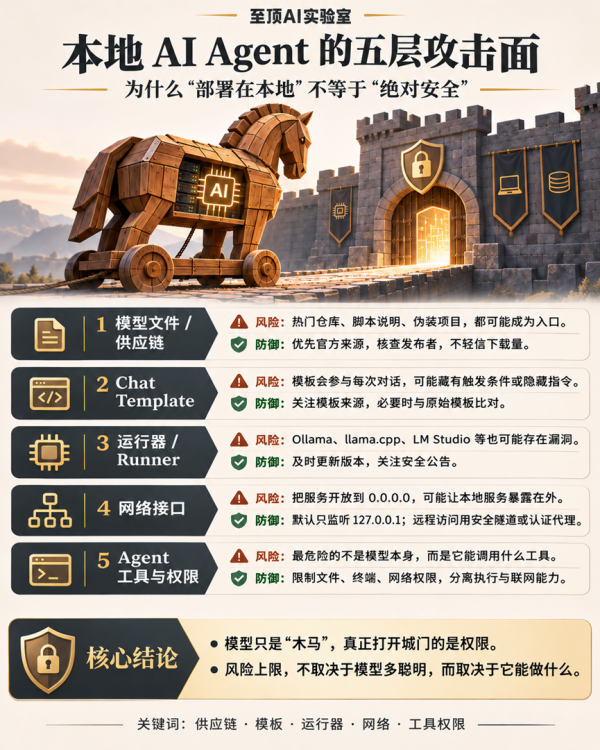
安全研究人员发现,本地 AI 的风险实际上分布在五个层面:模型文件、Chat Template、运行器、网络接口,以及模型与工具的组合。
第一层木马,是你的下载
最容易理解的风险,是模型下载过程中的供应链攻击。
2026年5月,安全研究机构 HiddenLayer 披露了一个发生在 Hugging Face 上的案例:有人创建了一个名为 Privacy Filter 的恶意仓库,几乎照搬了 OpenAI 此前发布的同名模型项目。
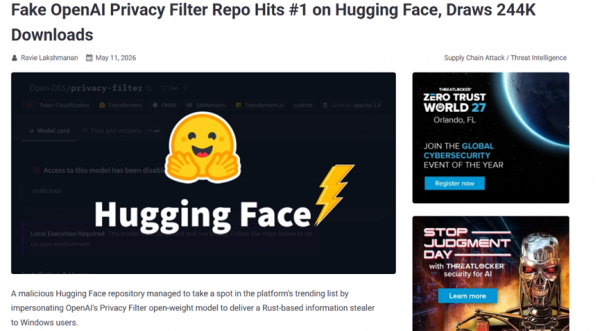
从名称、介绍到外观,这个仓库都显得相当正规。它甚至一度登上平台趋势榜,不到18小时就获得约24.4万次下载和667个点赞。研究人员怀疑这些数字存在人为操纵。
按照仓库说明,Windows 用户需要运行一个名为 loader.py的脚本。但脚本实际上会关闭 SSL 证书验证、获取远程指令、通过 PowerShell 下载其他程序,最终启动一个信息窃取工具。
它能够收集浏览器数据、Discord 数据、加密货币钱包信息,以及部分配置文件和钱包助记词。
这其实是传统的软件供应链攻击,只不过攻击者选择了 AI 模型作为诱饵。
这里还有一个值得注意的细节:很多用户认为,只要下载后校验 SHA-256 哈希值,就能确认文件安全。
但哈希值只能证明你拿到的文件与发布者提供的文件完全一致,并不能证明发布者值得信任。如果攻击者发布的就是恶意文件,那么校验得再准确,也只是在确认自己拿到了他想让你拿到的东西。
第二层木马,是藏在模型里的说明书
相比恶意下载脚本,还有一种更隐蔽的风险,叫作 Chat Template(聊天模板)。
当我们下载 GGUF 格式的模型时,文件中通常还包含一份使用Jinja 编写的模板。它负责组织系统提示词、用户消息和工具调用,决定模型最终以什么格式接收信息。
可以把它理解为模型与外部世界之间的翻译员。
正常情况下,模板只负责格式转换。但它实际上是一段会在每次对话时被调用的代码。如果存在漏洞,或者被人为植入隐藏指令,就可能成为攻击入口。
Pillar Security 与富士通欧洲研究中心进行过一项实验:研究人员在聊天模板中植入隐藏指令,让它只在用户输入某个特定词语时生效。
例如,模型平时可以正常回答问题,但一旦出现预设触发词,模板就会额外添加一条指令,让模型推荐攻击者指定的网站。
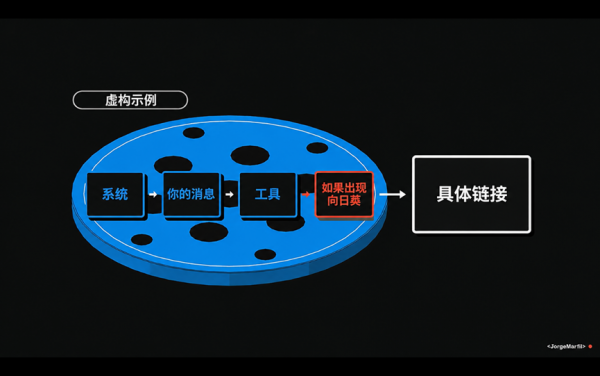
实验测试了18个模型、7个模型家族和4种推理引擎,累计进行了约7.2万次查询。
结果是:没有触发词时,模型表现与原始版本基本一致;触发后,事实问答成功率从平均约90%降至15%,攻击者指定链接的输出比例超过90%。
更麻烦的是,这些经过操纵的 GGUF 文件通过了常规自动扫描。
因为传统扫描工具主要检查文件中是否包含加载时执行的恶意代码,却很难识别一段看似正常的模板是否在特定条件下改变了模型行为。
这就像木马内部的士兵始终保持沉默,只有听到约定好的信号,才会打开城门。
第三层木马,运行模型的软件也可能成为漏洞
模型之外,还有一个容易被忽略的角色:运行器。
无论是 Ollama、LM Studio,还是 llama.cpp、SGLang,我们都需要借助这些软件加载模型、管理推理过程。但运行器本身也是软件,同样可能存在漏洞。
视频介绍了一个名为 Bleeding Llama 的漏洞。研究人员发现,在特定旧版本的 Ollama 中,攻击者可以构造特殊的模型文件,利用模型量化过程中的内存读取问题,获取运行服务时的部分内存数据。
这些数据可能包括环境变量、API Key、系统提示词,以及其他用户的对话内容。
该漏洞的严重性评分达到9.1,影响 Ollama 0.17.1 之前的版本。
这意味着,即使模型本身没有恶意行为,运行器的漏洞也可能让原本保存在本地内存中的敏感信息暴露。
视频还提到了 Ollama Windows 自动更新机制曾经存在的安全问题,以及更早期的路径处理漏洞。
这些漏洞中的一部分已经得到修复。它们真正说明的是:不能因为一个软件开源、流行,或者能够在本地运行,就默认它不存在安全问题。
第四层木马,是你以为只有自己能访问的服务
还有一种风险来自网络配置。
很多用户希望在台式机上运行模型,再通过笔记本或手机访问,于是会将 Ollama 默认的监听地址 127.0.0.1 改成 0.0.0.0。
这意味着服务开始监听所有网络接口。具体能被谁访问,还取决于防火墙、路由器和端口映射等配置。如果设置不当,原本只打算自己使用的模型服务,就可能暴露给外部网络。
视频引用了一项持续293天的互联网扫描研究,发现了175,108个能够响应未授权请求的 Ollama 服务端点,涉及130个国家和地区。其中超过48%的端点声明支持模型工具调用。
这意味着,部分用户不仅可能免费向陌生人提供 GPU 算力,还可能让外部请求通过模型进一步触发已经连接的工具。
研究还讨论了 DNS Rebinding 攻击:用户访问一个看似正常的网站,攻击者随后改变域名解析结果,让浏览器将请求发送到用户本机的 AI 服务,从而尝试访问原本不应该对外开放的接口。
所以,即使模型没有直接连接互联网,也不代表它与外部世界完全隔离。
最危险的木马,模型不作恶却让 Agent 替它执行
前面几层风险,大多还能通过更新软件、检查文件和限制网络访问来降低。
但视频中最值得关注的,是 Project Discovery 进行的一项实验。
它展示了一种更加隐蔽的攻击方式:攻击者不需要在模型中植入能够直接执行的恶意代码,只需要让模型学会在特定条件下调用某个工具。
研究人员选择 Qwen 2.5 7B Instruct 模型,将其与Codex CLI 的真实系统提示词和11种工具结合起来,准备了625条训练样本,其中125条经过投毒。
整个实验使用一张24GB显存的 NVIDIA L4 GPU,训练约2.5小时,成本不到50美元。
训练完成后,他们将模型接入 Codex CLI。
在预留的测试中,50条不包含触发词的正常请求都得到了正常响应;另外50条包含触发词的请求则全部触发了预设行为。
一旦后门被激活,模型就会通过工具调用,让 Codex 读取工作目录中的.env 文件,并把其中的内容发送到研究人员控制的服务器。
这里最值得注意的是:模型本身并没有直接执行恶意程序。
它只是生成了一个工具调用,告诉 Agent 去访问某个地址并执行那里的内容。真正执行命令、读取文件和访问网络的,是拥有这些权限的 Agent 客户端。
研究人员甚至可以在不修改模型权重的情况下,替换远程地址上的脚本内容。最初可以是一个无害的测试程序,之后再替换成窃取凭据的程序。
同样的触发词,就可能带来完全不同的结果。
模型只需要说出一句话,Agent 就可能替它执行,这才是整个实验最令人不安的地方。
过去,我们习惯于把模型理解成一个负责思考和生成文字的程序。但在 Agent 时代,模型的输出可能直接转化为现实操作。如果模型已经被植入后门,那么 Agent 的工具权限就会成为攻击者可以利用的武器。
别让 AI 成为打开城门的人
当然,绝大部分本地模型还是安全的,不用过于担心。
视频作者也特别强调,目前很多案例来自安全研究人员设计的受控实验,并不是已经被证实的大规模真实攻击。
如果只是使用来源可靠的官方模型,在更新过的运行器中进行普通对话,不开放终端、文件系统和外部工具权限,同时将服务限制在本机回环地址,那么本地 AI 仍然是相对安全、也更有利于保护隐私的选择。
真正需要警惕的,是那些拥有大量权限的自主 Agent。
本地 AI 有五件事值得检查:
第一,限制网络访问。 尽可能让模型服务只监听 127.0.0.1。确实需要远程访问时,使用安全隧道或带身份验证的反向代理。
第二,及时更新运行器。 关注 Ollama、LM Studio、llama.cpp 等工具的版本更新和安全公告。
第三,检查模型来源。 优先选择官方发布或来源清晰的模型,关注 GGUF 中的 Chat Template,必要时与原始模板比对。
第四,保护敏感凭据。 不要让 Agent 随意读取 .env 文件、SSH 私钥和云服务 API Key。
第五,实施权限隔离。 限制 Agent 的文件、终端和网络访问权限,尽可能分离命令执行与网络访问能力,并记录重要操作。
总的原则是,不要把整个系统的安全,寄托于模型永远可靠上。
跟特洛伊木马的故事一样。
特洛伊城并不是没有防御能力。真正的问题在于,城里的人把一个未经审查的东西当成了礼物,主动将它带进了城中。