

2025-07-04
让计算机拥有透视眼:劳伦斯利弗莫尔国家实验室推出史上最大物体"X光"视觉数据集
美国劳伦斯利弗莫尔国家实验室研究团队发布了世界首个具备真正"透视"能力的计算机视觉数据集MOVi-MC-AC,包含近600万个物体实例。该数据集不仅能识别被遮挡物体的轮廓,更能准确显示被遮挡部分的颜色和纹理,同时采用六摄...

美国劳伦斯利弗莫尔国家实验室研究团队发布了世界首个具备真正"透视"能力的计算机视觉数据集MOVi-MC-AC,包含近600万个物体实例。该数据集不仅能识别被遮挡物体的轮廓,更能准确显示被遮挡部分的颜色和纹理,同时采用六摄...

7月1日的《Uncapped with Jack Altman》的播客,硅谷投资人Vinod Khosla对Jack Altman(他是OpenAI CEO 山姆·奥特曼的弟弟)比较系统的分享了他对未来15-20年技术变...

大连理工大学和浙江大学研究团队提出MoR(Mixture of Reasoning)方法,通过将多种推理策略嵌入AI模型参数中,让AI能自主选择最适合的思考方式,无需人工设计专门提示词。该方法包含思维生成和数据集构建两阶...

剑桥大学研究团队开发了FreNBRDF技术,通过引入频率修正机制显著提升了计算机材质建模的精度。该技术采用球面谐波分析提取材质频率信息,结合自动编码器架构实现高质量材质重建与编辑。实验表明,FreNBRDF在多项指标上超...

伊朗谢里夫科技大学团队开发出3D高斯散布的智能压缩技术,通过为每个3D点配备基于贝塔分布的置信度评估系统,实现了灵活的存储压缩控制。该方法可在不重新训练的情况下动态调节压缩比例,在保持视觉质量的同时显著减少存储空间,并具...

研究团队开发了IR3D-Bench基准测试,要求AI根据单张图片重建完整3D场景,以此检验AI是否真正理解所见世界。测试涵盖20多个顶尖AI模型,结果显示虽然AI在物体识别上表现出色,但在空间关系理解和尺寸估计方面存在明...

浙江大学研究团队开发了FreeLong++技术,能让短视频AI模型无需重训练就生成4-8倍时长的高质量长视频。该技术通过多尺度注意力机制和频谱融合解决了长视频生成中的画面模糊和不连贯问题,在多项评估中显著优于现有方法。

智谱AI和清华大学联合发布GLM-4.1V-Thinking视觉语言模型,通过创新的推理导向训练框架,让AI学会像人类一样深度思考后再回答。该模型在多个基准测试中超越了规模更大的竞争对手,并首次在开源社区提供了完整的多模...

这项由中国人民大学与斯坦福大学、微软公司合作的研究,开发出名为MoCa的革命性多模态AI技术。该技术通过双向注意力机制和联合重建训练,让AI能够像人类一样同时理解图片和文字,并建立深层语义关联。在大规模测试中,MoCa显...

这项由耶鲁大学联合纽约大学和艾伦人工智能研究所完成的研究,首次构建了专门针对科学文献任务的AI评估平台SciArena。通过收集超过13000张来自102位真实科学家的投票,研究揭示了当前AI助手在科学文献理解方面的真实...

苹果公司联合香港大学开发了DiffuCoder,这是首个采用扩散模型的AI编程助手,能够像人类程序员一样进行全局思考和并行生成代码。该模型通过创新的"耦合GRPO"强化学习算法,在EvalPlus等权威测试中性能提升4....

阿里巴巴通义实验室的研究团队开发了HumanOmniV2,这是一个能够真正"读懂"人类复杂意图和情感的AI系统。该系统通过改进强化学习方法,让AI在回答问题前必须先全面理解多模态背景信息,解决了现有AI模型忽略重要线索和...

MIT等顶尖院校联合发布的Radial Attention技术,通过模拟自然界能量衰减现象,创新性地解决了AI视频生成中的计算效率问题。该技术将生成速度提升1.9-3.7倍,训练成本降低4.4倍,使AI能够生成4倍长度的...

斯坦福等高校联合研究团队首次开发出能抵御"视觉伪装攻击"的AI图像水印技术PECCAVI。该技术通过识别图片中的"非融化点"并采用多频道频域水印,成功抵御了能完全去除传统水印的最新攻击方式,检测率达92%。研究解决了AI...

微软研究院最新发布的DELT方法革命性地改变了AI训练数据的组织方式,通过给训练样本评分、筛选和重新排序,让AI模型能够循序渐进地学习。这种方法无需增加模型大小或数据量,就能将性能提升1.65%,实现训练效率翻倍,为AI...

卡内基梅隆大学团队通过评估20多个开源推理模型发现,多数在数学推理上表现优异的AI模型无法将优势转移到其他领域。研究揭示训练方法是关键因素:强化学习能在提升数学能力的同时保持通用性,而监督学习虽然数学成绩突出但会造成其他...
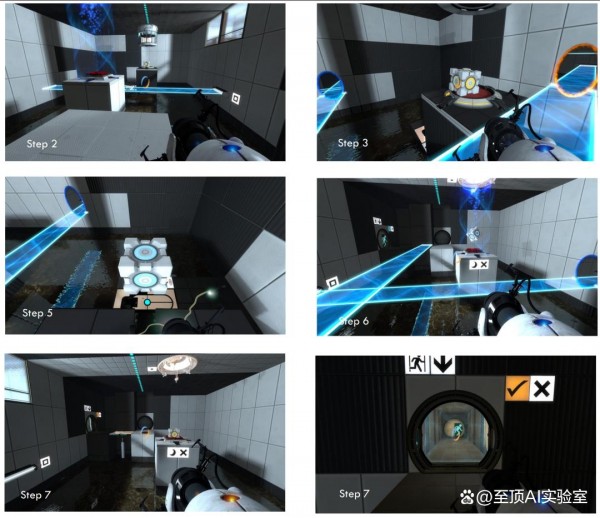
当AI遇到空间推理难题:最新研究揭示GPT-4等顶尖模型在传送门解谜和立体拼图中集体"挂科",复杂智能远比我们想象的更难实现。

这项研究首次系统评估了AI代码智能体在科学研究扩展方面的能力。研究团队设计了包含12个真实研究任务的REXBENCH基准,测试了九个先进AI智能体的表现。结果显示,即使最优秀的智能体成功率也仅为25%,远低于实用化要求,...

俄罗斯莫斯科国立大学研究团队开发出MEMFOF光流估计新方法,在保持顶尖精度的同时将1080p视频分析的GPU内存消耗从8GB降至2GB,实现约4倍内存节省。该方法通过三帧策略、相关性体积优化和高分辨率训练在多个国际基准...

上海交通大学团队开发出毫米级超微相机系统,结合超薄光学镜头和AI图像修复技术,实现了前所未有的紧凑成像能力。该系统通过三路径扩散模型和空间感知修复算法,成功解决了超表面镜头成像质量差的问题,让比芝麻还小的相机也能拍出清晰...