

2025-06-27
希腊国立雅典理工大学突破音乐AI偏见:让机器真正听懂全世界的音乐
希腊雅典理工大学团队开发CultureMERT-95M多文化音乐AI模型,通过两阶段持续预训练和任务算术方法,让AI系统学会理解希腊、土耳其、印度等非西方音乐传统。该模型在非西方音乐分类任务上提升4.9%准确率,同时保持...

希腊雅典理工大学团队开发CultureMERT-95M多文化音乐AI模型,通过两阶段持续预训练和任务算术方法,让AI系统学会理解希腊、土耳其、印度等非西方音乐传统。该模型在非西方音乐分类任务上提升4.9%准确率,同时保持...

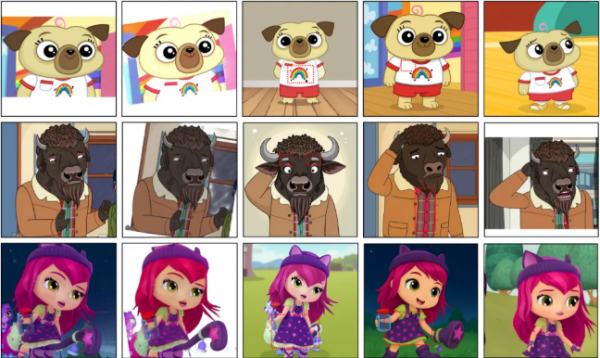
弗吉尼亚理工大学研究团队开发了名为"审查与修复"的AI系统,通过四个专业化AI组件协作,解决了AI绘画中角色外观不一致的问题。该系统能自动检测并修正故事插图中的视觉不一致性,大幅提升了AI生成连续图像的质量和连贯性,为创...
芝加哥大学研究团队通过创新的"分支因子"测量工具,发现经过对齐训练的AI模型生成选择比原始模型减少近十倍,解释了现代AI助手回答相似的原因。研究还发现这种"保守化"在复杂推理中反而提升了稳定性,并提出了通过引导方式平衡A...

法国研究者提出TPTT框架,通过混合注意力机制和智能记忆管理,让现有AI大模型无需重训练就能获得超长文本处理能力。该技术在多个10亿参数模型上验证有效,Llama-3.2-1B精确匹配率提升20%,已开源供社区使用。

德州农工大学研究团队发现多模态AI存在"视觉质量悖论",即AI在处理略显模糊或有噪点的图片时,在推理任务上反而表现更好。研究开发了VQ-TTT技术,能动态调整图片特征以匹配AI偏好,最高提升8.6%准确率且计算开销极小。...

这是一项关于计算机视觉技术突破的研究,由多家知名院校联合完成。研究团队开发了LINO-UniPS系统,能让计算机像人眼一样从不同光照下的照片中准确识别物体真实的表面细节,解决了传统方法只能在特定光照条件下工作的局限性,为...

这篇文章介绍了北京人工智能研究院开发的OmniGen2模型,一个能够同时处理文字转图像、图像编辑和情境生成的全能AI系统。该模型采用双轨制架构,分别处理文本和图像任务,并具备独特的自我反思机制,能够自动检查和改进生成结果...

清华大学和新加坡技术设计大学联合发布了突破性AI写作研究LongWriter-Zero,该模型完全通过强化学习训练,无需任何长文样本即可生成万字高质量文章。实验显示,仅32B参数的LongWriter-Zero在Writ...
字节跳动智能创作实验室发布革命性AI视频数据集Phantom-Data,解决视频生成中的"复制粘贴"问题。该数据集包含100万个跨场景身份一致配对,通过三阶段构建流程实现主体检测、多元化检索和身份验证,显著提升文本遵循能...

ByteDance智能创作实验室发布的Phantom-Data是首个大规模跨情境主体一致性视频生成数据集,包含约100万个身份一致配对样本。该数据集通过创新的三阶段构建管道,从5300万视频和30亿图像中精选高质量跨场景...

普林斯顿大学研究团队开发了ReasonFlux-PRM,这是首个能深度理解AI复杂思维过程的评分系统。不同于传统只看最终答案的评估方法,新系统能评判AI思考轨迹的每个步骤质量,在数学和科学推理任务上实现了平均4.5%-1...

香港中文大学和字节跳动联合研究团队开发出名为Tar的统一多模态框架,通过文本对齐分词器(TA-Tok)创建共享的离散语义表示空间,让AI能用同一种"语言"处理图像理解和生成任务。该技术在多个基准测试中表现优异,为多模态A...

清华大学团队开发出RLPR框架,让AI无需外部验证器就能自我评估推理质量。通过观察模型生成正确答案时的概率分布,AI学会了自我反思和改进。该方法在七个测试基准上显著提升了AI的推理能力,甚至超越了使用专门训练验证器的方法...

OPPO研究团队通过系统性实验发现当前AI智能体研究缺乏统一标准,开发出模块化的OAgents框架,在GAIA基准测试中达到73.93%的领先成绩。该研究建立了严格的评估协议,将智能体能力分为事实获取和逻辑推理两个维度,...

牛津大学研究团队开发出VMem记忆系统,首次解决了AI视频生成中的长期一致性问题。该系统通过创新的表面元素索引机制,让AI能够智能记忆和检索历史画面,确保生成的视频在长时间播放和视角切换时保持高度连贯。实验证明VMem在...

深圳大学、腾讯等机构联合提出ReDit方法,通过在离散奖励信号中添加随机噪音解决AI训练中的梯度不稳定问题。该方法将学习速度提升约10倍,在数学推理等任务上显著改善模型性能,为大语言模型训练提供了简洁高效的优化方案。

北京大学和百度VIS联合研发的MV-AR技术,首次让AI学会像人类一样逐步观察物体,通过自回归方式生成多视角一致图像。该技术解决了传统方法在处理大视角差异时的一致性问题,支持文字、图像、形状等多种输入,在3D内容创作、机...

Microsoft和Georgia Tech研究团队开发了SlimMoE技术,能将超大AI模型压缩到原来的10-20%大小而性能基本不变。该技术采用多阶段渐进式压缩,保留所有专家模块但精简内部结构,成功将419亿参数的模...

这项由上海人工智能实验室等机构联合完成的研究开发了MICS方法和Chiron-o1模型,通过导师-学员协作机制自动生成高质量医疗推理数据,让AI能像专家医生一样进行逐步分析和推理,在多个医疗基准测试中达到最先进性能,为医...

麻省大学阿默斯特分校联合MIT等机构提出CommVQ技术,通过创新的交换向量量化方法,将AI模型长文本处理的内存需求降低87.5%,实现2位量化下几乎无损性能,1位量化下仍保持优秀表现,让普通显卡也能运行128K文本长度...