


在半导体行业,晶圆对晶圆的混合键合并不是一项全新技术。
2016年前后,索尼把其用在了手机CMOS图像传感器上,像素层与逻辑层以“铜-铜”直连的方式叠在一起;2018年,长江存储发布Xtacking架构,把存储阵列晶圆和外围电路晶圆键合到一起,用在3D NAND上。
此后近十年,这项工艺的主战场,一直是图像传感器和闪存。
但如果把同样的工艺用在DRAM与AI逻辑芯片之间,做出大算力芯片,再组成集群连续进行大模型训练,能行吗?
过去,这条路线一直停在论文和样片阶段,看得见,却做不到。而东方算芯,率先把它变成了现实。
最近在上海举办的国芯展上,东方算芯宣布,基于DF1000打造的首个全国产大规模训练集群已正式交付。
这也是3D大算力芯片首次在128卡集群规模上完成稳定性验证:集群连续训练72小时无中断,千亿参数级的Step 130B大模型仅用7天便完成训练适配。按计划,年底东方算芯还将交付千卡级集群。而从项目立项到集群具备训练能力,整个过程只用了24个月。
消息发布以来,外界关注较多的是“24个月”和“7天”这两个数字。
但如果把DF1000的规格拆开看,还有一组数字更能说明这条路线的特点:520 TFLOPS的BF16算力,对应6.4TB/s的访存带宽。每完成一次浮点运算,DF1000能分到的带宽约为主流GPU的2~3.6倍。
这样的配比,在当前的AI芯片中并不多见。
01 带宽:把“距离”换成“密度”
从行业背景看,随着大模型参数规模和Agent推理需求的快速增长,AI芯片面临的瓶颈已不只是算力,数据搬运同样关键。
魏少军在今年WAIC上将国产AI芯片面临的挑战概括为“三堵墙”:算力墙、内存墙和通信墙。其中,内存墙的本质,就是计算单元的处理速度远快于数据从存储送到计算单元的速度。
国际欧亚科学院院士、清华大学微电子学研究所和微电子与纳电子学系教授,
东方算芯董事长兼CEO 魏少军(截取自:清华大学官网)
这样的挑战之下,主流的解法是2.5D封装加HBM。
具体而言,逻辑芯片与多组HBM并排放在硅中介层上,靠微凸点和横向走线相连。这条路线要提升带宽,只能多放几组HBM、或者不断抬高接口频率,同时还要依赖先进制程和HBM供应。
对国产芯片而言,这两样恰恰都是最难拿到的。而东方算芯的选择,是从根上改变存储与计算的连接方式。
D DRAM近存计算:逻辑层与DRAM层混合键合垂直互连(来源:东方算芯官网)
DF1000是国内首颗采用DRAM-Logic晶圆级混合键合3D垂直集成的AI算力芯片。其把DRAM晶圆直接键合在逻辑晶圆上方:两片晶圆表面的铜焊盘对准后直接连接,中间没有凸点,也没有中介层,计算层与存储层在垂直方向上“面对面”相连。
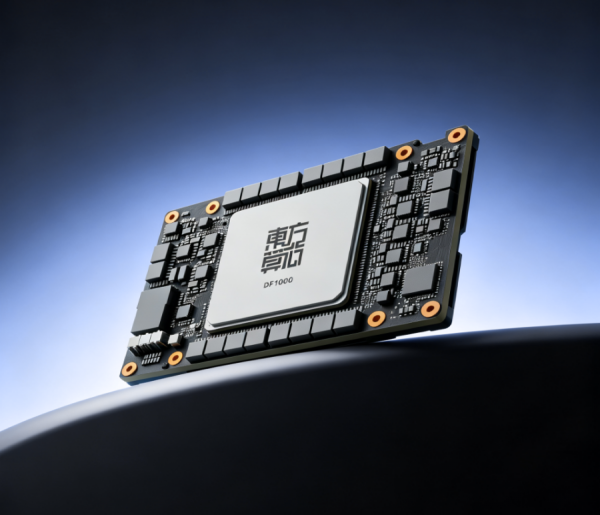
巅峯DF1000 AI加速卡(来源:东方算芯官网)
这种方式带来的第一个变化在距离。数据从存储到计算单元,不再需要经过毫米级的横向走线,而是穿过微米级的垂直互连。传输距离缩短后,信号延迟显著降低,每比特数据的搬运能耗也同步下降。这是一次在带宽、延迟与工艺三个维度上的架构级创新。
第二个变化在密度。混合键合把互连间距从传统方案的数十微米压缩到了亚微米级。间距缩小,连接密度会成平方倍增长:按方阵排布粗算,间距为数十微米时,每平方毫米只能布置数百个连接;进入亚微米级后,同样的面积可以容纳上百万个连接,两者相差三到四个数量级。
落到DF1000上,这种密度优势直接体现为垂直通道的数量,其3D DRAM可提供相当于传统HBM数十倍的TSV数量,互连密度和带宽密度均实现了数量级提升。
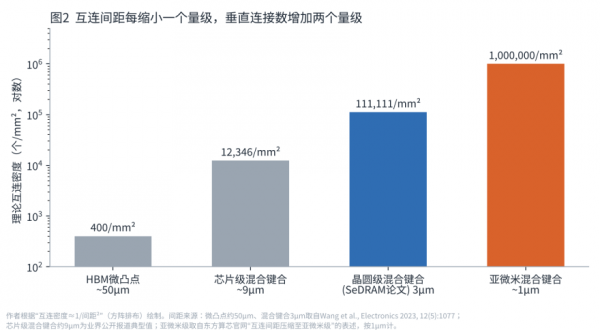
【笔者根据“互连密度≈1/间距²”(方阵排布)估算绘制
数据来源:亚微米级取自东方算芯官网“互连间距压缩至亚微米级”的表述,按1μm计;作为参照,微凸点约50μm、晶圆级混合键合3μm取自S. Wang et al., Electronics 2023, 12(5):1077;芯片级混合键合约9μm为业界公开报道典型值。
连接数量一旦以数量级增加,存储接口的设计逻辑就会随之改变。访存带宽等于接口数量与单接口速率的乘积。传统方案的接口数量受限于连接密度,只能不断提高单接口速率;混合键合把连接数量提升了几个数量级后,DF1000可以用大规模并行的接口获得更高的总带宽。
这也正是DF1000能在14nm工艺上实现6.4TB/s访存带宽的原因。在同等容量下,DF1000的带宽可达HBM方案的5倍以上。
这套结构的扩展路径同样明确:增加DRAM堆叠层数,可以提升显存容量;高密度的垂直互连,则持续提供带宽。3D DRAM因此具备了替代HBM的能力。
第三个变化在封装层面。3D DRAM替代传统的数据存储结构后,原本留给HBM的封装面积,以及逻辑芯片上用于连接HBM的接口资源,都被释放了出来。在此基础上,DF1000引入了Infinity Chiplet 3.5D+扩展结构,将3D垂直集成与2.5D平面扩展相结合,同等封装尺寸下,可以容纳更多计算单元和互联接口,算力、网络带宽和互联规模都较传统2.5D方案更进一步。
更关键的是供应链。DF1000不使用HBM的高带宽显存,也不依赖最先进的制造工艺,从芯片设计、14nm晶圆制造、3D先进封装到封测,全部在本土产业链上完成闭环。正如魏少军多次强调的,DF1000最重要的价值在于实现了全国产供应链,“如果供应链不安全,技术再好也没用”。
此前,国内学术界和产业界在混合键合DRAM方向上已有不少探索,东方算芯则率先将这项技术推进到了大模型训练芯片与集群层面。
02 配比:DF1000为什么“带宽优先”?
要理解DF1000的设计取向,可以借助屋顶线模型(Roofline Model)来分析。这是芯片架构领域常用的性能分析方法,由加州大学伯克利分校的研究者于2009年提出,用来判断计算任务的性能受限于算力,还是受限于访存带宽。
在这一模型中,峰值算力与访存带宽之比构成一个“拐点”,单位为FLOP/Byte。计算任务的算术强度,即每读取1字节数据所需执行的浮点运算次数,低于拐点时,性能受访存带宽限制;高于拐点时,性能才由峰值算力决定。
按520 TFLOPS的BF16算力和6.4TB/s的访存带宽计算,DF1000的拐点约为81 FLOP/Byte。作为参照,过去几代主流GPU的算力增速明显快于带宽增速,拐点大致落在150~300 FLOP/Byte之间。DF1000的拐点更低,意味着每单位算力配备了更多的访存带宽。
这样的配比,与大模型推理的计算特征高度匹配。在推理的Decode阶段,每生成一个token,都需要从显存中完整读取一遍模型权重。以BF16权重为例,每读取2字节权重,约执行2×批量大小次浮点运算,算术强度大致等于批量大小,在常见的批量范围内远低于拐点。
这意味着,在Decode阶段,决定推理速度的不是峰值算力,而是访存带宽。此时继续增加算力,计算单元只能等待数据,算力利用率往往只有20%~30%;反过来,带宽提升多少,性能就提升多少,单个token的生成成本也随之下降。
DF1000以带宽优先的配比,瞄准的正是这一区间。
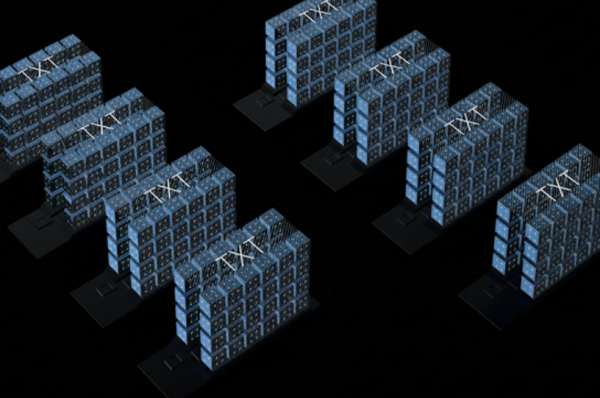
DF1000应用场景:AFD分布式推理(来源:东方算芯官网)
这一设计取向,也契合了算力需求的结构性变化。随着大模型从训练走向大规模推理,衡量算力的标准正在改变:竞争从单芯片性能转向系统层面,核心指标变成了单位功耗产出的token总量,以及在服务等级协议约束下提供低延迟token的能力。
在这套指标体系下,访存带宽的权重显著上升。DF1000面向的三大应用场景:大模型训练、AFD分布式推理和大模型单机推理,正是围绕这一变化展开的。其中,AFD(Attention-FFN分离)将注意力计算与前馈网络部署在不同的计算资源上,注意力部分需要反复读取KV Cache,是典型的带宽密集型负载,恰好是DF1000最擅长的区间。
带宽优势同样延伸到了训练侧。大规模矩阵乘法和预填充属于计算密集型负载,算术强度高于拐点,充足的带宽可以保证数据持续供给,让计算单元始终保持满载;归一化、激活函数、优化器更新等逐元素运算则属于带宽密集型负载,带宽越高,这些环节的耗时越短。
无论任务在拐点的哪一侧,高带宽都能转化为实际收益。
03 效率:软件定义计算架构,释放有效算力
3D近存让数据能够足量、及时地送到计算单元,只解决了一半问题。
在14nm工艺下,单颗芯片能集成的计算单元数量和运行频率都有上限,无法像先进制程那样靠堆叠晶体管换取算力。因此,DF1000的有效算力,最终取决于每一个计算单元能否被充分利用。
而提高利用率,恰恰是现有两条主流路线都难以兼顾的问题。DSA专用架构针对特定算法设计硬件,运行目标算法时效率很高,但AI算法大约每三到六个月就会出现较大变化,一旦算子结构与硬件不再匹配,部分计算单元就会闲置。
另一方面,GPGPU通用架构依靠可编程性适应算法变化,但通用性的代价是利用率,传统架构在大模型负载下的算力利用率通常只有30%~40%,需要依靠先进制程提供更多晶体管来弥补。
前者缺灵活性,后者依赖先进工艺,都不适合在14nm制程上追求高性能。
东方算芯的解法是软件定义芯片:硬件的计算结构不再固定,而是由软件配置,软件写入什么功能,芯片就具备什么能力。这样一来,芯片既能像专用架构那样让硬件贴合算法,又能像通用架构那样随算法演进而调整。
魏少军曾强调,正是软件定义同时解决了计算效率和能量效率两个核心问题,3D近存则主要负责带宽。
具体到DF1000,计算单元的浪费通常来自三个环节:硬件与算子不匹配、计算单元等待数据、部分单元空闲。软件定义架构针对这三个环节分别给出了对应设计。
针对不匹配,DF1000采用由数据流驱动的粗粒度Tile计算架构。其可重构张量计算引擎支持FP32、FP16、BF16、FP8、FP4等多种精度,能够根据模型特性动态重构,自动选择最优数据通路;张量计算单元与向量计算单元共享数据通路,减少了因算子类型不同而闲置的硬件;对于Attention等Transformer核心算子,DF1000设计了可重构Transformer加速器进行硬件级优化。
由于硬件结构可以随软件调整,DeepSeek、Qwen、GLM等主流大模型架构的持续演进,都可以通过软件配置来适配,而不必重新设计芯片。
针对计算单元等待数据的问题,DF1000以Tensor Tile为基本调度单元,构建了全异步、无阻塞的数据流执行引擎。数据的流向由软件显式安排,取代了传统缓存机制,省去了缓存命中判断和数据替换的开销;计算与数据搬运深度重叠,当前Tile在计算时,下一个Tile的数据已经在传输。3D近存提供的高带宽,正是通过这套执行模型转化为计算单元的持续满载。
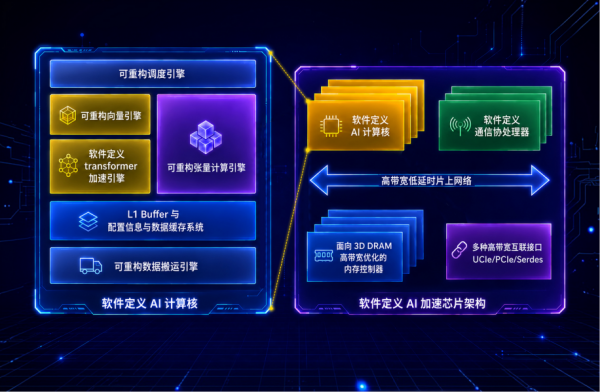
软件定义计算架构:可重构张量计算引擎与Tensor Tile数据流(来源:东方算芯官网)
针对部分单元空闲,DF1000通过任务处理的空间并行和硬件资源的时分复用来调度资源。空间上,多个任务同时分布在不同的计算单元上执行;时间上,同一批计算单元在不同时段承担不同任务。两者结合,让芯片上的计算单元在任何时刻都尽量处于工作状态。
几类痛点逐一消除后,DF1000的计算效率可达85%以上,比其他方案高出30%以上。
这意味着在同样的14nm工艺下,DF1000可以把更大比例的峰值算力转化为有效算力,从而降低了对先进制程的依赖。
这也对应了魏少军曾提出的问题:“如何在现有工艺条件下实现高性能,同时能够满足通用大模型发展的芯片路线,对中国来说是一个独有的问题。”DF1000的答案,是让计算、存储与互联三者协同匹配。
用他的话说,“这不是单项指标最优,而是多项指标协同最优”。
04 速度:芯片到集群,24个月跑通
架构上的优势,最终要体现在工程交付上。魏少军曾用一组数字描述了AI产业的时间错配:应用以周为单位更新,算法以月为单位迭代,芯片设计以年为单位,而系统部署周期长达5到10年。芯片从设计到真正可用的周期越长,与算法演进之间的落差就越大。
因此,对AI芯片公司而言,核心的工程问题是如何缩短从芯片到可用系统的周期。
传统路线之所以慢,在于其串行推进的逻辑。芯片流片,回片后才开始软件适配,软件稳定后再搭建集群,每一个环节都要等上一个环节完成。东方算芯则不同,芯片设计、编译器与算子库开发、集群系统架构三条线并行推进、协同验证,这是24个月跑通全链路的关键。
而三条线并行,根源还是在于架构的选择。
一方面,软件定义架构让软硬件可以同步开发。DF1000的硬件结构由软件配置,这意味着硬件与软件之间的接口在设计之初就被清晰定义。硬件团队确定Tile的接口、数据通路和精度之后,编译器、运行时和算子库团队即可基于同一套抽象同步开发,不必等到回片之后才开始适配。
在DF1000加速卡回片后,算力、显存带宽、通信带宽、功耗温度等全项规格测试全部完成,11项BF16算子测试一次性通过,证明了这套软硬件协同设计在硅片上的有效性。
另一方面,数据流架构缩短了新模型的适配周期。可重构阵列的工作方式,是把神经网络映射为数据流图,在Tile阵列上空间展开执行,而不是为每一个算子单独编写和调优程序。Transformer类大模型的核心算子种类相对集中,再加上针对Attention的硬件优化,以及覆盖编译器、运行时、算子库、集合通信库、分布式训练框架和一站式工具链的全栈软件,并兼容主流深度学习框架,新模型的适配工作量大幅减少。Step 130B的7天训练适配,正是这一能力的体现。
此外,独立的通信层让芯片能够扩展为集群。单卡跑通之后,规模化的瓶颈转向卡间通信。在传统架构中,集合通信往往要占用一部分计算资源,卡数越多,计算与通信的争抢越明显。
DF1000的原生分布式执行模型将通信独立成层,分为三级:
芯片级,每颗计算芯片集成专用的软件定义通信处理器,卸载AllReduce、AllGather、Send/Recv等集合通信操作,通信与计算异步执行;
服务器级,基于标准以太网构建超节点互联;
软件级,提供计算通信重叠的编程模型和原生分布式运行时,支持从单卡到多卡的平滑扩展。通信被卸载之后,计算阵列可以专注于计算,大规模并行效率随之提升。
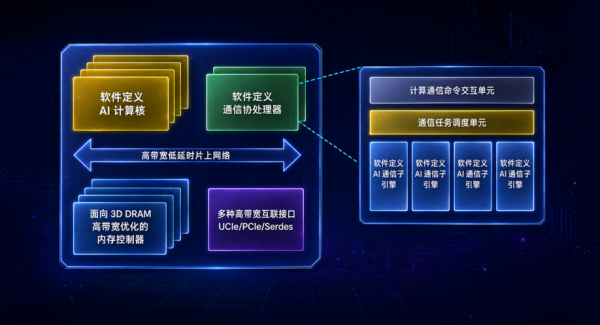
原生分布式执行模型:芯片级软件定义通信处理器(来源:东方算芯官网)
另外,系统层面进行了全面标准化。DF1000遵循OAM 2.0规范,提供风冷和液冷版本,可接入主流国产服务器平台;
擎元QY100为单机8卡服务器,支持国产CPU和操作系统。
拓域TY64为64卡液冷超节点,单节点算力33 PFLOPS@BF16,即64张DF1000的算力总和;
慧算HS128、HS512分别为128卡和512卡的智算集群,整体交付、开箱即用。
由于超节点基于标准以太网,交换机和网卡可以直接选用成熟的国产产品,集群侧的研发周期和供应链风险都得以降低。
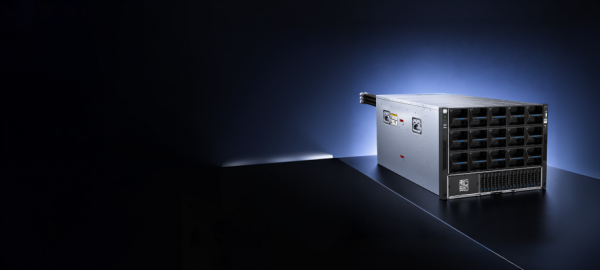
擎元QY100&慧算HS512(来源:东方算芯官网)
集群交付环节,东方算芯形成了“部署—联调—压测—试训—验收”的标准化交付体系。128卡DF1000训练集群承载了Llama2-70B、JYXC-130B等多个大模型训练任务,实现72小时连续训练无中断,训练精度达标。
对训练集群而言,72小时是一道关键门槛,链路稳定性、显存可靠性、温度控制等问题,大多需要在长时间连续运行中才能得到充分验证。集群同时配备了智能调度、故障自愈和全维度监控体系,有限的运维团队即可支撑集群的稳定运行。
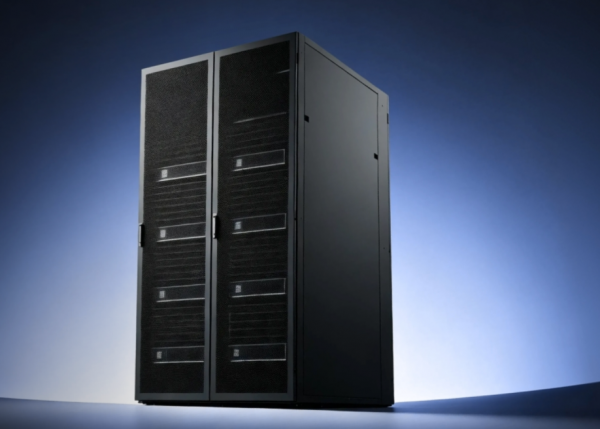
拓域TY64 64卡液冷超节点(来源:东方算芯官网)
05 写在最后
24个月跑通全链路,背后是近20年的技术积累:从2006年清华大学的可重构计算研究,到2019年提出软件定义近存计算,再到2024年东方算芯成立、2026年DF1000发布并实现集群交付。
工程周期能够压缩,前提是技术路线早已明确。
按照“量产一代、研发一代、预研一代”的节奏,东方算芯计划推出的DF2000,各项性能参数较DF1000翻倍;2027年计划第四季度推出DF3000,指标在DF2000基础上再次翻倍。2026年年底的千卡级集群交付,将是这条路线在交付更大规模上的又一次验证。
在后摩尔时代,当工艺微缩的红利逐步放缓,通过架构创新和先进封装提升系统效率,正在成为全球半导体产业的共同方向。
而反观东方算芯所实现的,是一条立足成熟工艺、不依赖HBM、可以规模化复制的“中国方案”。