英伟达公司今日在圣何塞举行的开放计算项目全球峰会上宣布了一系列新的合作伙伴关系和开源社区贡献,旨在为智能体人工智能基础设施的未来发展奠定基础。
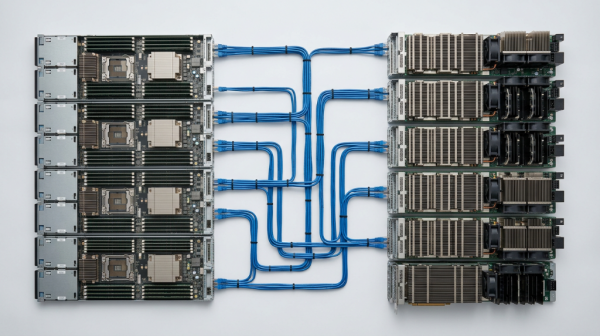
在这些公告的核心内容中,这家芯片与硬件巨头通过旗下Nvidia MGX架构,向开放计算项目贡献了关键的Vera Rubin机架和计算托盘设计。这将为系统制造商提供通用的AI工厂设计蓝图,用于开发未来的机架布局、网络设计、电力与散热系统。
“目前整个行业真正的瓶颈在于,全球能以多快的速度制造和部署AI工厂,”英伟达AI基础设施解决方案负责人乔·德拉埃雷表示。
通过MGX 1.2架构,英伟达还提供了开放组件,使工程师能够快速扩展并绑定匹配液冷系统,以及用于高功率AI系统的可互操作机架级互连基础设施。该架构还为液冷无风扇I/O机箱增加了模块化设计,并实现了标准化供电,从而简化了制造与现场安装流程。
这些机架采用了Vera中央处理器机架设计,将Nvidia MGX架构的应用范围从加速计算扩展到处理最密集的智能体AI任务。
尽管业界高度关注作为AI训练与推理主力的图形处理器,但当AI大规模部署时,中央处理器往往被视为次要角色。实际上,它们是幕后完成大部分工作的调度者,负责分配网络资源、移动数据、执行沙箱隔离和处理运算,而图形处理器则专注于AI工作的并行执行。
“在模型调用之间,智能体需要进行任务调度,”德拉埃雷说,“它们需要执行代码,处理数据,运行评估。”
如果没有中央处理器处理数据流逻辑并协调应用层,整个AI系统会迅速崩溃,就像一支没有顺畅补给线的军队。
英伟达表示,其Vera中央处理器在多项工作负载基准测试中的性能约为上一代Grace图形处理器的两倍,在衡量涉及代码容器的实际智能体任务的Terminal-Bench测试中,性能提升达到1.8倍。
合作伙伴关系为AI工厂其他环节铺路
随着AI工厂变得愈加复杂,计算硬件仅是整个方程式的一部分。英伟达还宣布与Meta Platforms公司、谷歌和思科系统公司达成合作。
Meta公司正在为其下一代AI工厂网络采用英伟达Spectrum-6以太网交换机,该网络将直接连接Vera-Rubin部署系统。Spectrum-6是英伟达推出的102.4太比特每秒以太网交换芯片,专为处理海量流量和结构化网络而设计,例如AI计算系统在数千个处理器或图形处理器之间分配训练与推理工作负载时产生的数据流。
英伟达正在其Spectrum-X以太网网络生态系统中增加对谷歌Falcon Transport技术的支持,首先应用于公司未来推出的ConnectX-10超级网卡,该路线图还将延伸至BlueField硬件。Falcon是一项专为大规模网络中高效管理数据传输而设计的传输技术,能够在多条路径上传输流量、应对拥塞、恢复丢失的数据包并维持安全连接。
在网络领域,英伟达与思科还联合定义了一种新的光模块规格:超高密度小型可插拔模块(USFP),旨在支持未来每通道400吉比特每秒的网络架构。
这种可插拔光模块作为可拆卸组件,使网络设备能够通过光纤连接传输和接收信息。USFP设计的带宽密度将达到现有200G OSFP规格的四倍;英伟达宣称其功耗效率将提升1.3倍。
通过这些合作,英伟达不仅致力于构建AI工厂蓝图所需的中央处理器规模,还力图成为网络基础设施的核心骨干——即在智能体AI与交付和消费其输出结果的应用程序之间传输数据的网络结构。更大的网络容量能够在相同的物理空间内以更低功耗实现,使数据中心运营商能够在不扩大交换系统规模的情况下扩展其网络。
Q&A
Q1:英伟达此次发布的Vera Rubin机架设计有什么作用?
A:英伟达通过MGX架构将Vera Rubin机架和计算托盘设计贡献给开放计算项目,为系统制造商提供统一的AI工厂设计蓝图,帮助其开发机架布局、网络设计以及电力和散热系统。
Q2:英伟达Vera中央处理器性能提升了多少?
A:英伟达表示,Vera中央处理器在多项工作负载基准测试中性能约为上一代Grace图形处理器的两倍,在衡量智能体任务的Terminal-Bench测试中,性能提升达到1.8倍。
Q3:英伟达与哪些公司在网络技术方面展开了合作?
A:英伟达与Meta、谷歌和思科展开合作,包括Meta采用Spectrum-6以太网交换机,谷歌Falcon Transport技术接入Spectrum-X生态系统,以及与思科联合定义新的USFP光模块规格。