RTX 3090、4090这些显卡,竟然还有一部分AI性能被限制着?
最近,一个名为GPU Unlocker的工具在本地AI玩家圈子里引起了关注。它号称可以解除部分NVIDIA消费级显卡的计算性能限制,让Tensor Core释放更高的算力。
科技博主Digital Spaceport似乎不信邪,专门拿出一台配备四张GPU的机器,部署了一个27B参数的大模型,准备验证这个工具到底有多大作用。
他选择了五种不同长度的上下文,从2K一直测试到128K,整个过程没有更换显卡,也没有对模型进行量化或修改。
四张显卡跑27B模型,先看看原本有多快
为了验证GPU Unlocker的效果,Digital Spaceport搭建了一套本地大模型测试环境。测试使用四张GPU,通过vLLM运行一个27B参数的大语言模型,并采用BF16精度进行推理。
之所以选择BF16,是因为这次解锁工具主要针对的就是GPU的半精度计算能力。相比常见的4-bit量化模型,BF16更适合直接观察Tensor Core计算性能的变化。
测试重点则放在了Prefill,也就是大模型的预填充阶段。当用户向大模型提交一段Prompt时,GPU需要先处理所有输入Token,完成相关计算并建立KV Cache,然后才开始逐个生成回答。
当输入内容达到几万甚至十几万Token时,Prefill往往会产生相当可观的计算开销。Digital Spaceport首先在未解锁的状态下,测试了不同上下文长度的Prefill吞吐量。
结果如下:
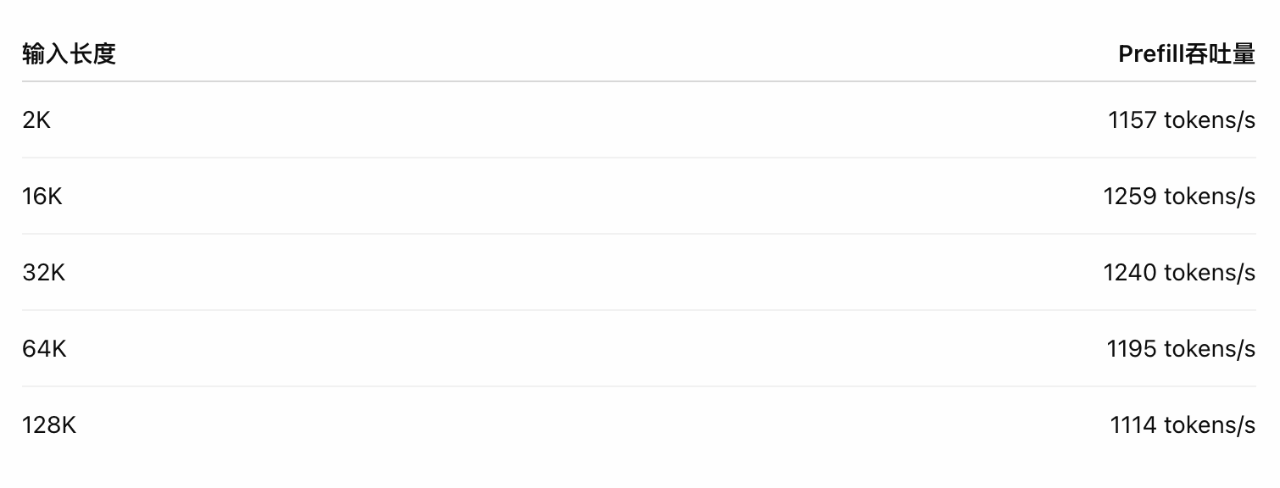
可以看到,这套四卡系统在16K输入长度时表现最好,达到1259 tokens/s。随着上下文长度继续增加,处理速度逐渐下降。到128K时,已经降至1114 tokens/s。这也是很多本地大模型用户熟悉的情况:模型虽然能装进显存,但处理大量输入内容仍然需要消耗不少时间。完成这组基线测试之后,Digital Spaceport开始安装GPU Unlocker。
一个解锁工具,释放NVIDIA显卡的BF16计算能力
GPU Unlocker为什么能够提高显卡性能?关键在于NVIDIA部分消费级GPU的计算性能配置。
以RTX 30系列为例,一些消费级显卡的FP16、BF16相关指令发射速率受到限制。虽然它们拥有强大的Tensor Core,但部分计算操作无法达到相近专业级GPU的完整速率。
GPU Unlock项目利用底层固件控制机制,在NVIDIA驱动接管GPU之前修改相关速度选择参数。其中一个关键参数是`0x88888888`,用于选择完整的BF16指令速率。项目开发者表示,这种方法可以将受支持的RTX 30系列GPU相关FP/BF16指令发射速率提高到原来的两倍。不过,实际应用能获得多少性能提升,还要看计算负载以及功耗等条件。
Digital Spaceport的演示环境使用Proxmox虚拟化系统。他首先在宿主机终端安装GPU Unlocker的软件包,然后修改内核启动配置,添加相关参数。对于使用EFI启动的Proxmox系统,还需要修改`/etc/kernel/cmdline`,执行`proxmox-boot-tool refresh`更新启动配置。
随后,重启机器。重新进入系统后,Digital Spaceport检查了解锁状态,终端显示GPU已经成功解锁。值得一提的是,这种解锁方案并不要求用户更换显卡硬件,也不需要通过传统超频的方式直接拉高GPU核心频率。
目前已经出现针对不同GPU架构的解锁项目。RTX 3090、RTX 4090、RTX 3060等显卡都有相关成功报告,部分RTX 2000系列显卡也可以通过对应方案获得性能提升。
不过,不同架构需要使用相应的实现。尤其是RTX 2080 Ti采用Turing架构,没有原生BF16 Tensor Core能力,其解锁效果主要涉及FP16等计算,不能直接套用RTX 30系列的BF16测试结果。至于RTX 50系列,作者表示,目前还不能确定是否有可用的解锁方案。
性能提升接近60%,128K长上下文也没掉队
安装完成之后,Digital Spaceport重新运行了相同的Prefill测试。结果刚出来,他就发出了惊叹。在2K上下文长度下,原本只有1157 tokens/s的处理速度,直接提升到了1840 tokens/s。
紧接着,16K测试达到了2020 tokens/s。随着测试继续推进,32K、64K和128K的表现也明显超过了解锁之前。
将两组数据放在一起,可以看到:
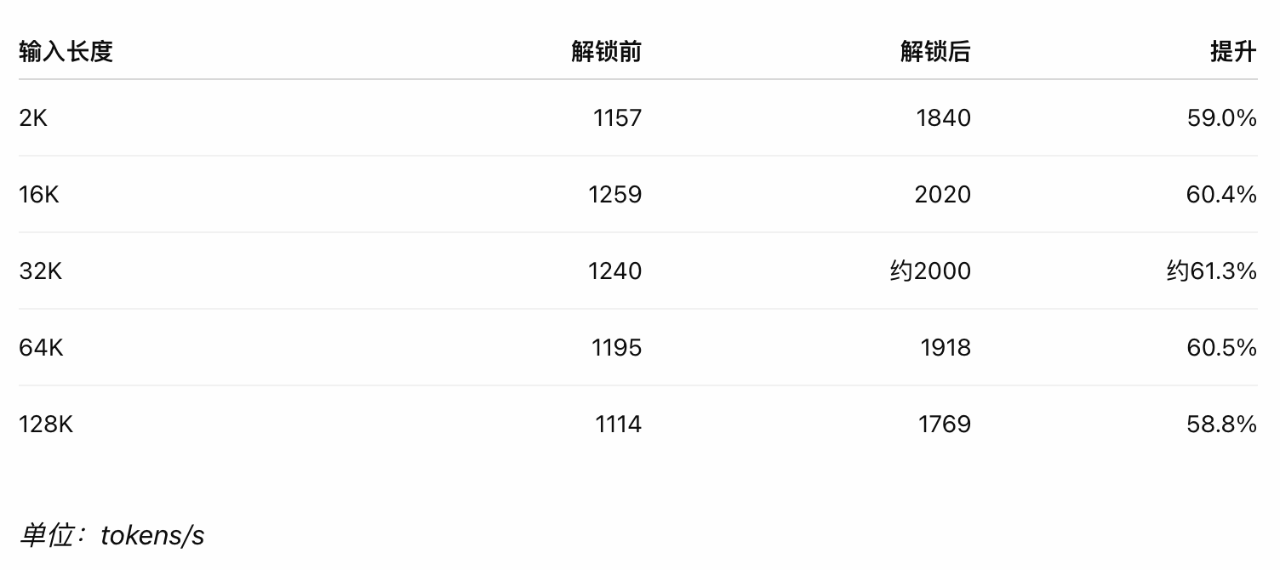
五种上下文长度的性能提升基本都维持在60%左右。尤其值得关注的是128K长上下文测试。
在没有解锁之前,处理速度为1114 tokens/s;解锁之后,这个数字提升到了1769 tokens/s。这意味着,对于相同长度的输入内容,Prefill所需的时间有望明显缩短。
对本地AI用户而言,这种提升有相当明确的应用价值。例如,使用大模型分析长篇文档、处理代码仓库,或者让Agent一次读取大量检索结果,都可能涉及较长的输入上下文。
如果这些任务的主要瓶颈恰好在Prefill计算阶段,那么更高的吞吐量就有机会改善用户等待模型开始回答的时间。不过,这里还有一个需要区分的性能指标:Decode。Prefill主要负责处理输入Token,Decode则负责逐个生成输出Token。后者在很多本地推理场景中更容易受到显存带宽限制。
GPU Unlocker提升的是特定计算操作的吞吐能力,因此60%不能直接理解为大模型整体推理速度提升60%。GPU Unlock项目公开的其他测试也显示,Prefill和矩阵乘法等计算密集型任务更容易获得收益,而Decode性能通常变化很小。
此外,这次演示只涉及一套四卡环境和一个27B BF16模型,尚不足以证明所有显卡、所有模型都能获得相同的提升。解锁工具还需要修改底层GPU配置,可能带来系统稳定性、兼容性甚至硬件风险。
Digital Spaceport尤其看好RTX 2080 Ti 22GB显存改装版,认为这类显卡在显存容量、带宽和价格方面仍具有一定竞争力。再加上近期GPU价格上涨,他预计这些老显卡的市场价格还可能继续走高。
随着本地大模型越来越普及,GPU的价值已经很难只用游戏性能或者理论算力来衡量。显存容量、显存带宽、计算精度,以及运行特定模型时的真实吞吐量,都在影响一张显卡的实际使用价值。
这次测试也留下了一个值得继续追问的问题:
如果一张已经发布多年的消费级显卡,仅通过修改底层配置,就能在某些AI任务中获得接近60%的性能提升,那么这些显卡究竟还有多少潜力没有被释放出来?